Qué significa ser ingeniero de implementación para clientes en OpenAI
Qué hacemos, cómo trabajamos y cómo resolvemos los problemas más difíciles de las empresas para generar un impacto real.
Por: Colin Jarvis, director de Ingeniería de Implementación para Clientes en OpenAI
Cuando se lanzó Codex, alguien del equipo me preguntó: “¿Qué hacemos cuando Codex puede resolver de un solo intento los casos de uso que pasamos los últimos meses desarrollando?”
Esa pregunta refleja la esencia de lo que significa ser ingeniero de implementación para clientes en OpenAI. Trabajamos junto a los clientes para entender sus problemas más difíciles y crear soluciones en las que puedan confiar. Lo que aprendemos ayuda a dar forma a nuestros productos y le aporta a Investigación problemas concretos que resolver.
Eso es avanzar. Si cada par de meses nos volvemos innecesarios, nuestro equipo de ingenieros de implementación para clientes está cumpliendo su función.
Fundé el equipo a principios de 2025 para cerrar lo que llamamos “la brecha de implementación”: la distancia entre lo que los modelos parecen capaces de hacer y lo que las personas pueden usar de manera confiable para realizar su trabajo.
Las capacidades de los modelos han avanzado más rápido que los sistemas y procesos necesarios para aprovecharlas. A veces, lo que falta es un producto. A veces, un modelo obtiene buenos resultados en una prueba de referencia, pero no puede cumplir la tarea con las variables y restricciones del mundo real.
Nos enfocamos en los problemas más difíciles de los clientes. Cuando nuestros modelos ya pueden cumplir la tarea, trabajamos con el equipo de Producto y el cliente para que la solución se pueda replicar; cuando no alcanzan, trabajamos con los clientes e Investigación para identificar las carencias y hacer mejoras. Nuestra meta es que cada proyecto deje al siguiente cliente un mejor punto de partida. Si mejoramos las capacidades de base hasta que nuestros clientes ya no necesiten ingenieros de implementación para clientes para resolver esta clase de problema la próxima vez, habremos hecho bien nuestro trabajo.
El desafío de John Deere, una empresa agrícola con 200 años de historia, era ampliar el alcance del asesoramiento personalizado para agricultores.
Un ejemplo es See & Spray, su tecnología de control de malezas de precisión, que usa cámaras y aprendizaje automático para identificar y rociar malezas en lugar de tratar campos enteros, lo que reduce el uso de productos químicos hasta un 70 %.
Pero obtener esos beneficios depende de que los agricultores sepan configurar la tecnología, planificar la temporada y ajustar sus prácticas a medida que cambian las condiciones.
John Deere implementó las API de OpenAI para ofrecer ese apoyo de forma personalizada y a gran escala.
La IA puede responder las preguntas de los agricultores en lenguaje natural, ofrecer orientación y recomendaciones de configuración personalizadas, detectar cuándo un equipo podría no estar aprovechando todo su potencial y ayudar a los agricultores a entender el valor que obtienen de la tecnología.
La oportunidad va más allá de una interacción aislada: ofrecer orientación pertinente a lo largo de toda la experiencia del cliente, para ayudar a los agricultores a aprovechar mejor sus equipos y mejorar la eficiencia y la sostenibilidad.
Este es el tipo de desafío que buscan resolver los ingenieros de implementación para clientes de OpenAI: ayudar a las organizaciones a convertir las capacidades de la IA en sistemas que aporten valor práctico en entornos reales y complejos.
Pero los problemas suelen estar poco definidos, puede que no haya una referencia objetiva establecida y no existe una guía para resolverlos. Todos quieren crear algo que nunca haya existido. Menos personas están dispuestas a hacer lo necesario para lograrlo.
Encontrar ingenieros de implementación para clientes talentosos mientras elevamos el estándar de lo que consideramos “suficientemente bueno” ha exigido experimentar y poner a prueba lo aprendido constantemente.
Al inicio de cada sesión del equipo de ingenieros de implementación para clientes, muestro una diapositiva con un valor central: "Empieza por el resultado, haz lo necesario para lograrlo y después amplía su alcance".
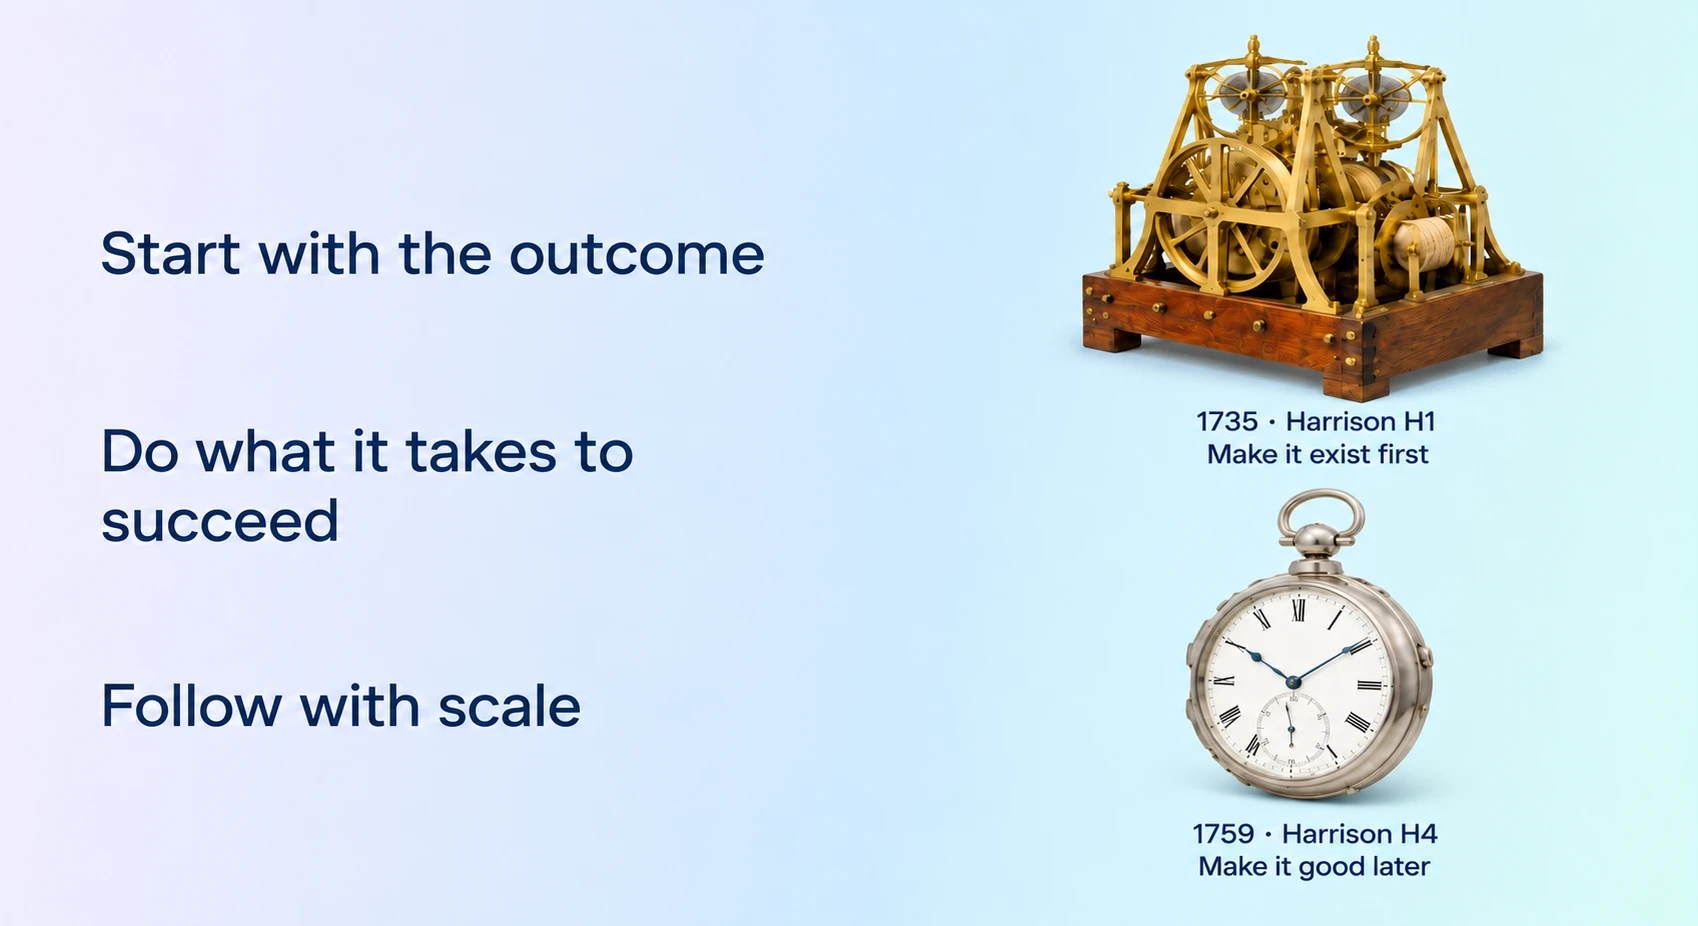
Una demostración impresionante puede ganar mucho terreno antes de que alguien pregunte si funciona en el mundo real.
Nuestro trabajo es resolver el problema del cliente con un nivel de calidad que podamos respaldar en producción.
A mediados de 2025, teníamos alrededor de 15 ingenieros de implementación para clientes trabajando con una gran empresa de semiconductores en más de 10 casos de uso. La meta era transformar su proceso de verificación para que tuviera la IA como base y abarcara:
Generación de pruebas dirigidas
Análisis de causa raíz y depuración
Un asistente de arquitectura
La verificación puede representar cerca del 70 % del esfuerzo de un proyecto en esta industria. La oportunidad era enorme y había muchos puntos de partida posibles.
Algunos ingenieros de implementación para clientes se habían incorporado a OpenAI apenas unos días antes y nunca habían trabajado en semiconductores. Se integraron al equipo de verificación del cliente, estudiaron diseño de chips en su tiempo libre y elaboraron evaluaciones con los ingenieros para comprobar si la IA podía generar pruebas útiles y diagnosticar correctamente fallas en los chips.
En paralelo a ese aprendizaje, creamos arneses de ejecución personalizados para cada caso de uso. En los primeros 3 a 6 meses, todos llegaron a producción y comenzaron a usarse. La recompensa fue ver las métricas:
Cerca del 48 % de ahorro de tiempo gracias a la generación de pruebas dirigidas con IA.
Una mejora mediana del rendimiento del 22 % gracias a la optimización de kernels.
Semanas de depuración reducidas a horas
Cuando presentamos todos estos resultados, el director de hardware preguntó: “¿Ustedes trabajaron como diseñadores de chips antes de venir aquí?”
Nuestros ingenieros de implementación para clientes no necesitan conocer la industria desde el primer día, pero es su responsabilidad aprender sobre ella.
A medida que los asistentes de programación aceleran el desarrollo de software, entender el negocio del cliente se vuelve aún más importante. Formamos equipos que combinan generalistas y expertos en el sector.
Necesitas conocimientos suficientes para tomar decisiones bien fundamentadas y curiosidad suficiente para cuestionar lo que se da por sentado.
En las ciencias de la vida, por ejemplo, la formación científica de nuestros ingenieros de implementación para clientes les ayuda a ganarse la confianza de investigadores que trabajan en tareas preclínicas de descubrimiento de fármacos, como la validación y priorización de dianas terapéuticas, el análisis de expresión génica y la reconstrucción de rutas de síntesis química. Esa experiencia les permite aportar criterios fundamentados sobre cómo mejorar esos flujos de trabajo.
Habíamos demostrado que estos flujos de trabajo podían aportar valor, pero cada uno todavía requería demasiado trabajo de integración a medida para extenderlo a otro equipo. El siguiente desafío era conservar esos resultados y, al mismo tiempo, facilitar la implementación y el mantenimiento del software.
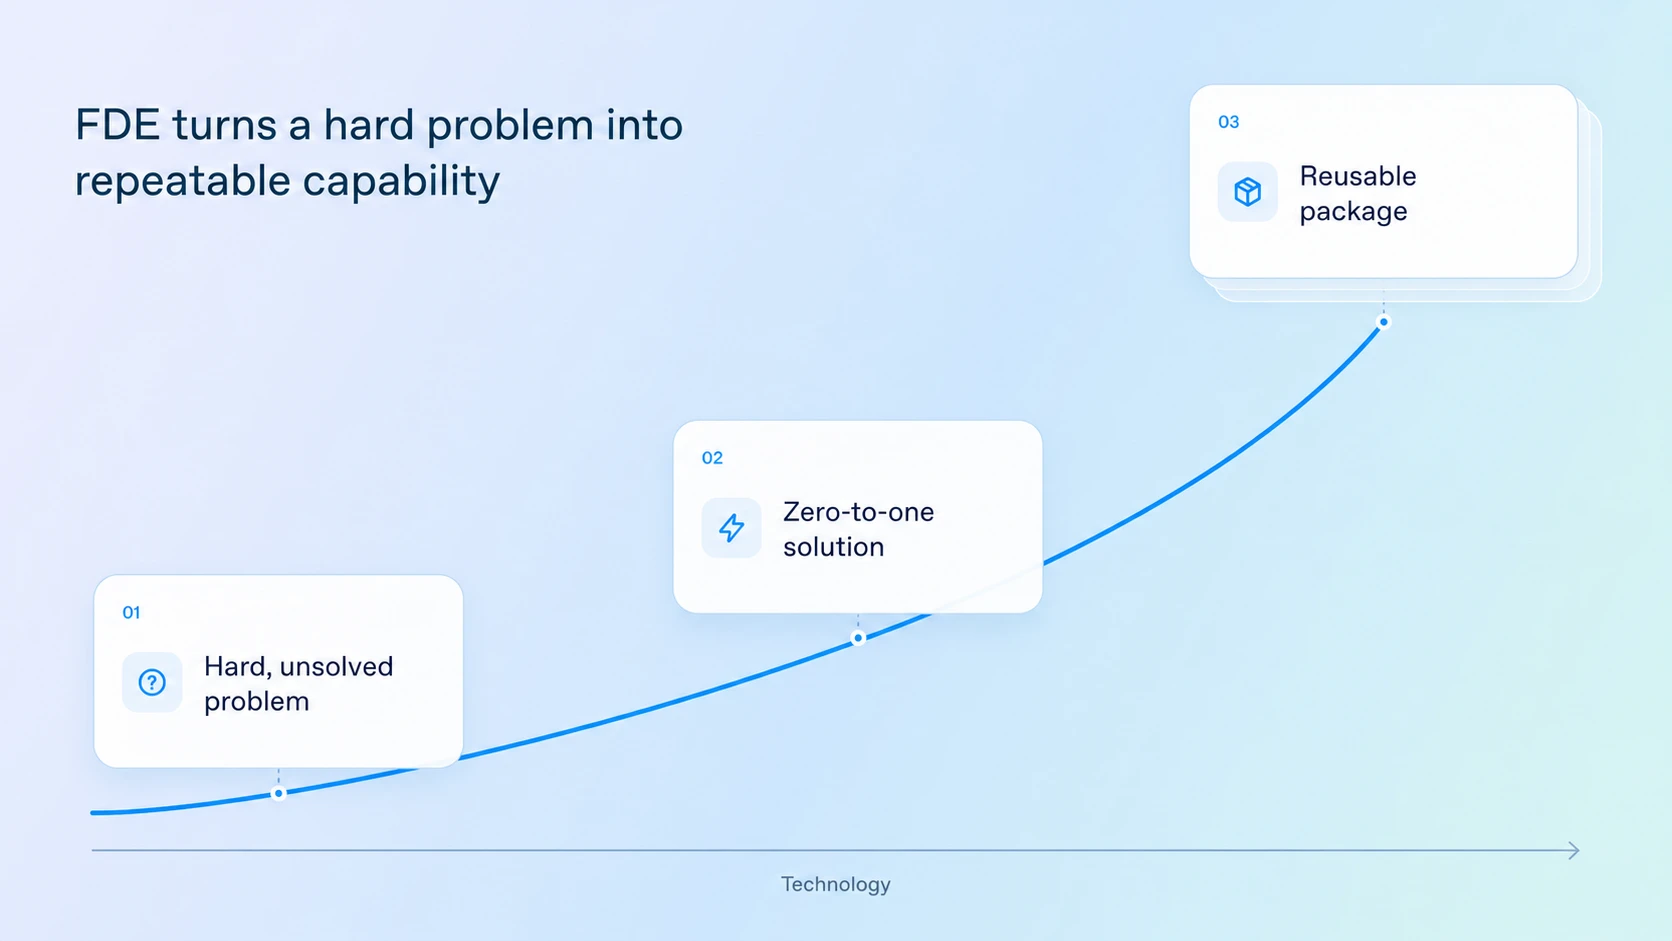
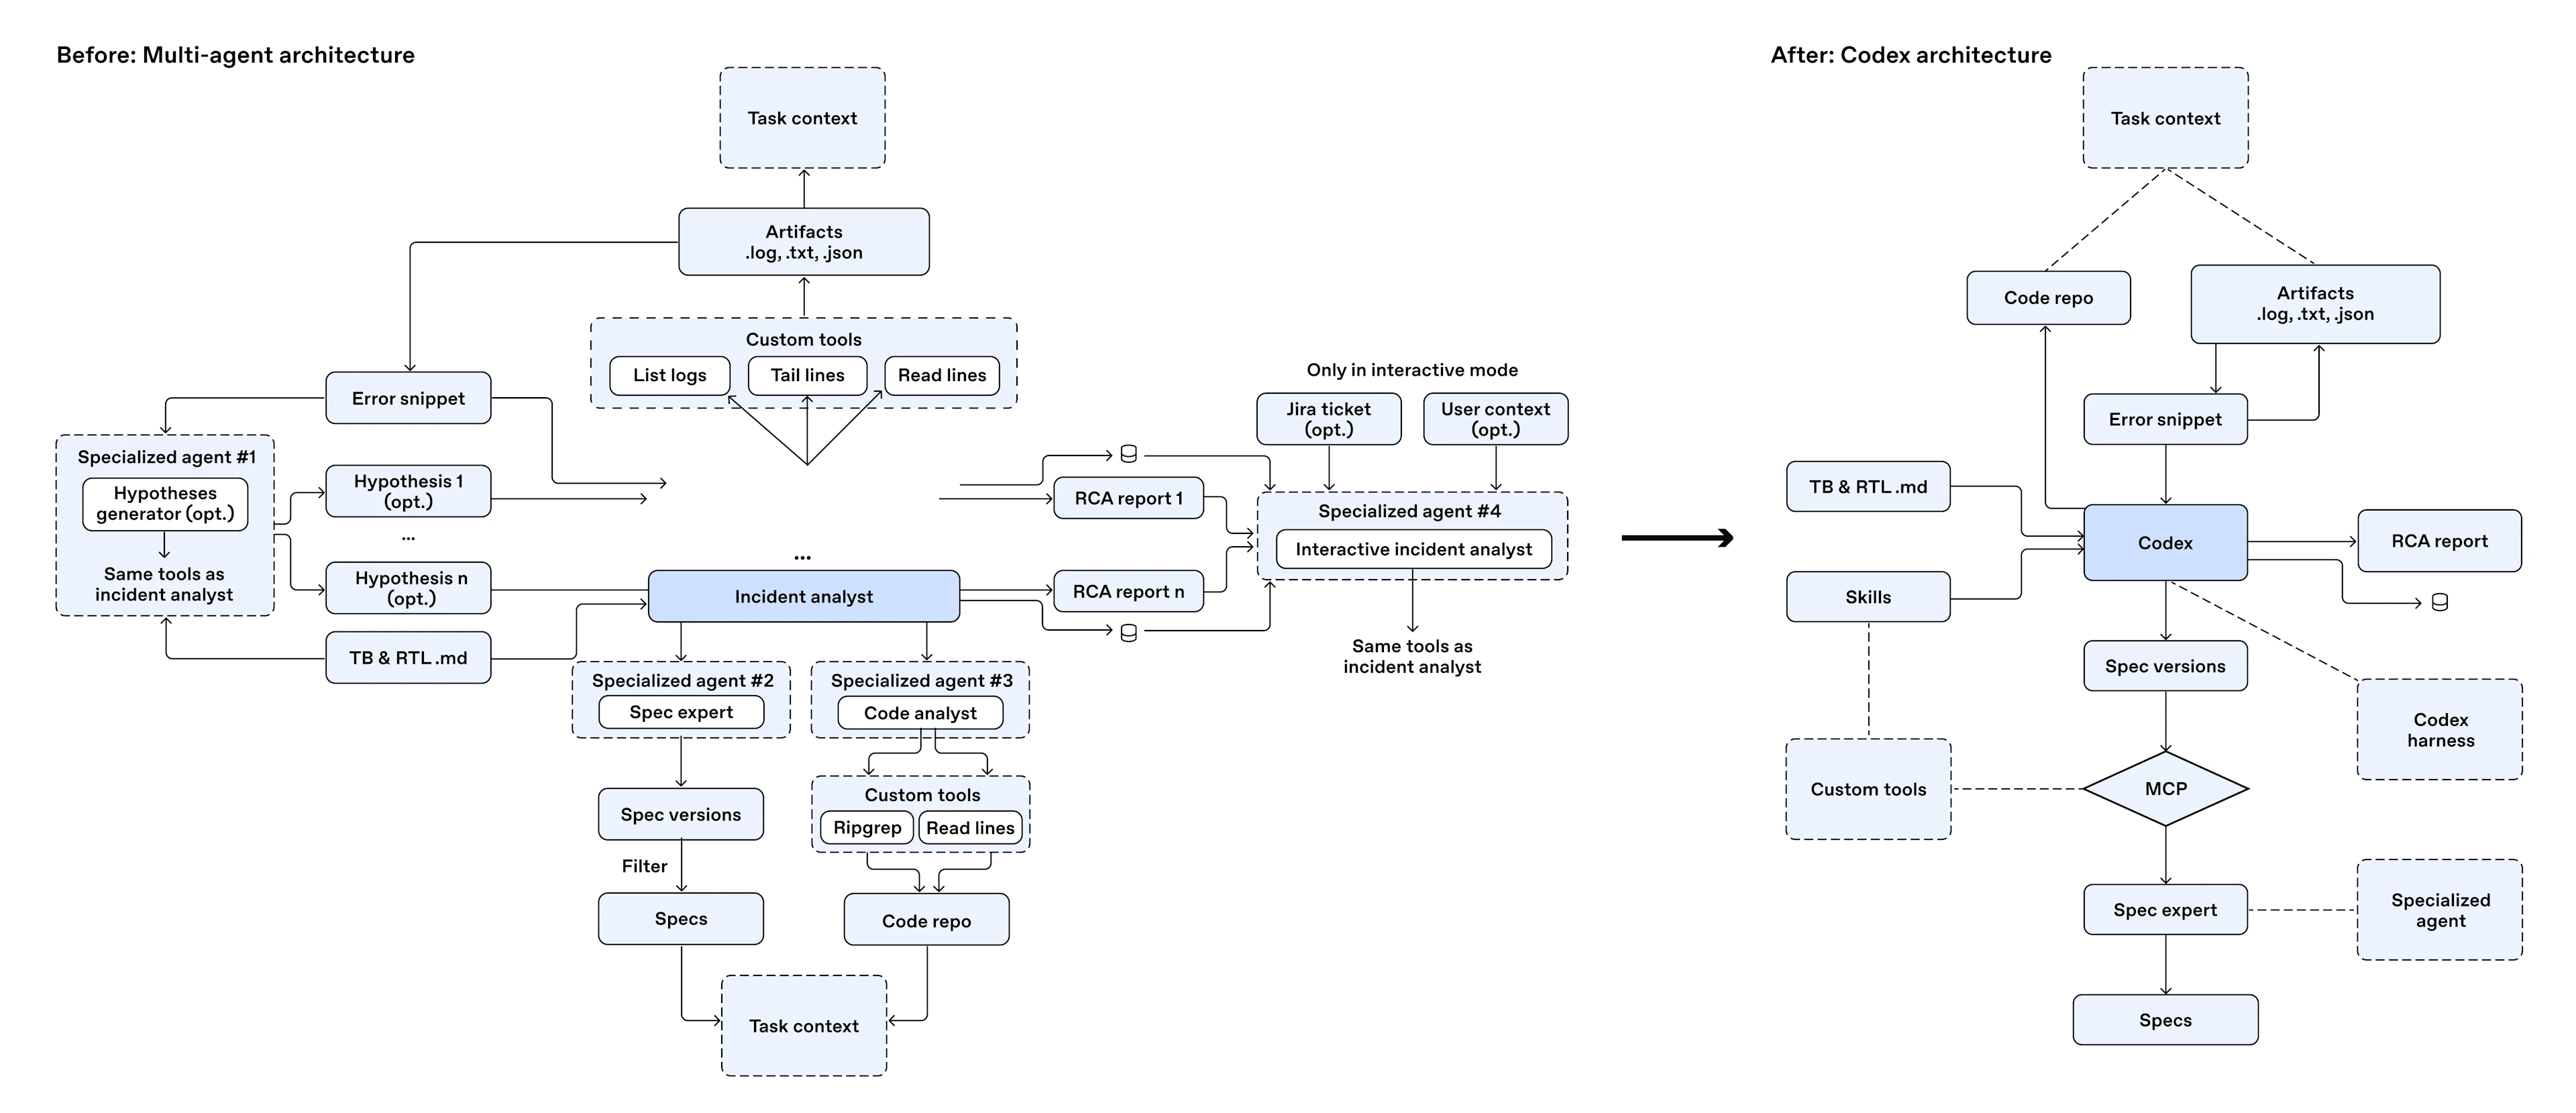
Para entonces, las capacidades de Codex habían mejorado. Un ingeniero de implementación para clientes probó reconstruir su aplicación en torno a Codex y luego trabajó con el equipo para migrar los casos de uso a un arnés de ejecución común con Codex como núcleo.
Las aplicaciones personalizadas se convirtieron en plugins y habilidades basados en primitivas comunes de Codex. Codex también se convirtió en la interfaz, lo que nos permitió retirar las interfaces de terminal y de línea de comandos que habíamos creado por separado para cada caso de uso.
Pudimos eliminar alrededor del 90 % del código personalizado de cada proyecto, y esto cambió nuestra forma de crear, mantener y ampliar estos flujos de trabajo:
Podíamos aprovechar las mejoras centralizadas de Codex, lo que reducía la cantidad de código de integración necesario para cada caso de uso
Las funcionalidades clave se agruparon en habilidades y plugins, lo que facilitó compartirlas entre equipos y controlarlas de forma centralizada desde el centro de excelencia en IA. Así, extender la solución de un equipo a otro podía ser tan simple como incorporar nuevos conectores o servidores MCP, crear nuevas evaluaciones —para las que también teníamos una habilidad— y ponerla en marcha.
En un caso de agosto de 2026, la implementación inicial tomó dos meses. Extender la solución a un segundo equipo tomó un día. Los siguientes equipos se incorporaron más rápido a medida que ampliábamos el alcance. Esa tendencia continuó: en un caso de uso de agosto de 2026, la incorporación del segundo equipo tomó 1 día, después de una implementación inicial de 2 meses.
Esa es una forma de volvernos innecesarios. El trabajo que habíamos hecho para llegar a producción dejó claro qué era importante. A medida que mejoraba el producto subyacente, podíamos reemplazar gran parte de nuestra implementación personalizada y conservar el valor que aportaba.
Por eso importa el orden. Los LLM nos permiten crear rápido. Aprovecha esa velocidad para poner algo valioso en manos de los usuarios, descubrir qué funciona en la práctica y luego ampliar lo que da resultado.
El mismo principio se aplica a todos los proyectos con clientes.
OpenAI Presence, nuestro producto para agentes de voz y chat empresariales, surgió de implementaciones reales de clientes. El trabajo comenzó con Swarm(se abre en una nueva ventana) y evolucionó a través de Agents API, y hoy un cliente gestiona más de la mitad de sus llamadas con IA.
La puesta en producción de esas implementaciones nos permitió identificar qué problemas requerían una solución personalizada y qué componentes básicos podían reutilizar otros equipos. Incorporamos esos componentes reutilizables a Presence para que los desarrolladores puedan automatizar flujos de trabajo sujetos a regulaciones sin tener que reconstruir la infraestructura subyacente. Cada implementación contribuyó a dar forma al producto y proporcionó a los siguientes clientes un mejor punto de partida.
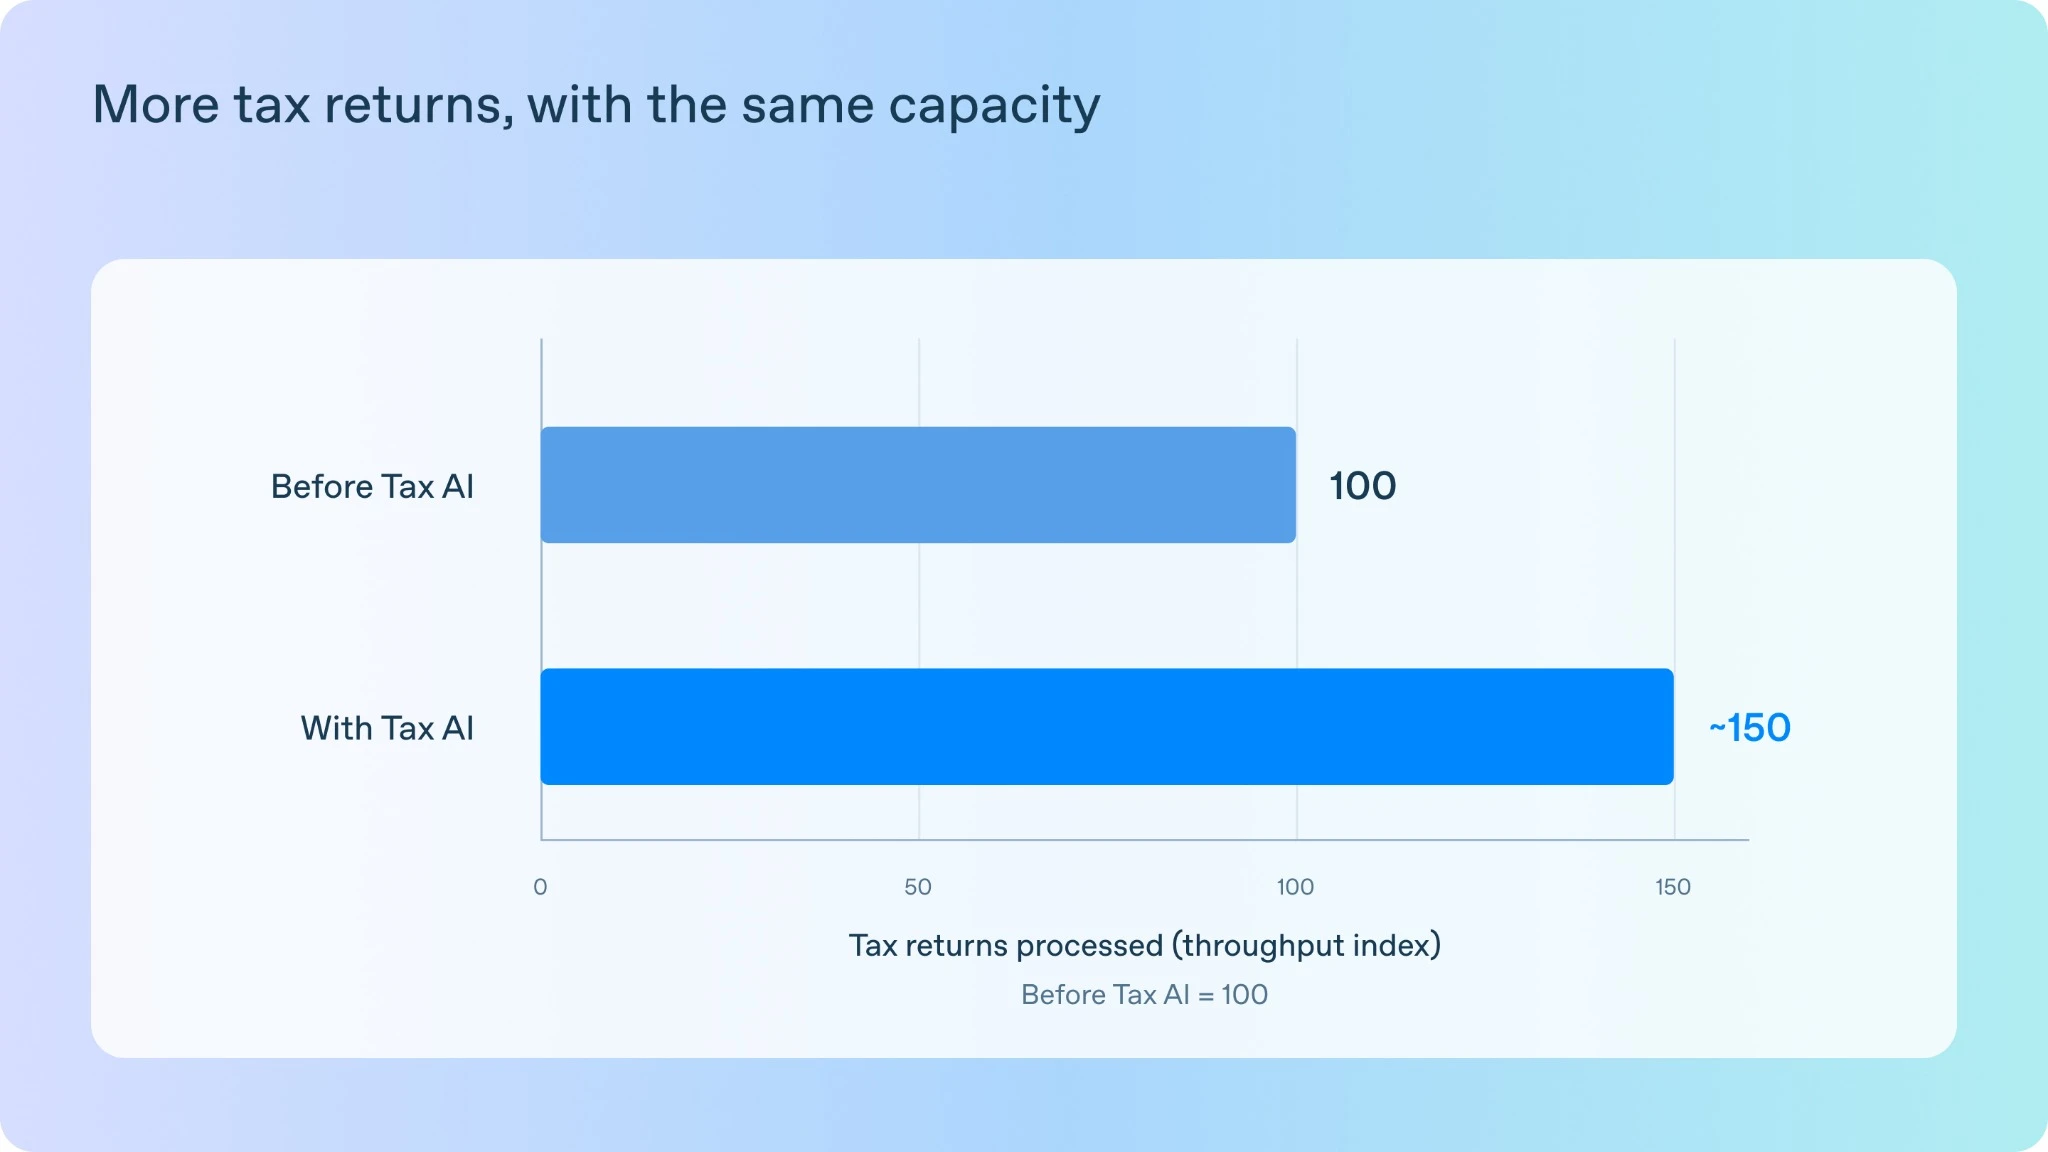
Con Thrive Holdings,los ingenieros de implementación para clientes (FDE) de OpenAI e investigadores de OpenAI trabajaron junto con ingenieros y contadores para desarrollar Tax AI para los estudios contables de Crete. Durante su piloto, Tax AI procesó 7000 declaraciones y aumentó el rendimiento en aproximadamente un 50 %.
Uno de los desafíos más difíciles fue automatizar las declaraciones de impuestos de propiedades en alquiler, lo que requirió seis semanas de trabajo de ingeniería y revisión por parte de especialistas para alcanzar un 90 % de precisión y exhaustividad. Este trabajo permitió desarrollar patrones reutilizables que facilitaron la ampliación de Tax AI a otros anexos fiscales complejos.
Los equipos ahora están aplicando el mismo enfoque a la contabilidad, la auditoría y el soporte de TI, y desarrollando sistemas que mejoran gracias a los comentarios de los profesionales y su uso en situaciones reales.
A veces, un mejor producto nos permite simplificar lo que construimos, pero otras veces el propio modelo todavía no puede cumplir la tarea.
Si solo construimos lo que los modelos actuales ya permiten, no descubriremos las carencias de inteligencia que Investigación debe abordar a continuación. Por eso, muchos de nuestros proyectos importantes parten de esos límites, con el compromiso del cliente, los ingenieros de implementación para clientes e Investigación de superarlos juntos.
Ya habíamos desarrollado una plataforma de atención al cliente con una gran empresa de telecomunicaciones, y querían ampliarla al canal de voz.
Las llamadas de voz representaban alrededor del 90 % de su volumen de atención al cliente. Resolver estos casos sin intervención humana era más costoso que en el chat, y planteaba nuevos desafíos técnicos para que el manejo de los acentos, el tono, la latencia y la precisión alcanzaran el nivel necesario para producción. Lograrlo marcaría una diferencia sustancial para su negocio.
Durante la definición del alcance, nuestro modelo obtuvo alrededor del 60 % en las evaluaciones clave que usamos para determinar si podía cumplir la tarea en producción. Habíamos llegado al límite de sus capacidades. Era necesario mejorar la llamada a funciones y el seguimiento de instrucciones en situaciones de atención al cliente.
Se lo explicamos al cliente e incorporamos al equipo de Investigación al proyecto. El equipo de ingenieros de implementación para clientes trabajó con el cliente para construir la plataforma y definir qué debía hacer el modelo. Investigación trabajó para subsanar las carencias del modelo, cuyas versiones sucesivas nos permitieron evaluar el progreso frente a los requisitos del cliente.
En seis meses, el desempeño en las evaluaciones clave pasó de alrededor del 60 % al 80 % y luego a más del 90 %, hasta alcanzar los niveles necesarios para producción.
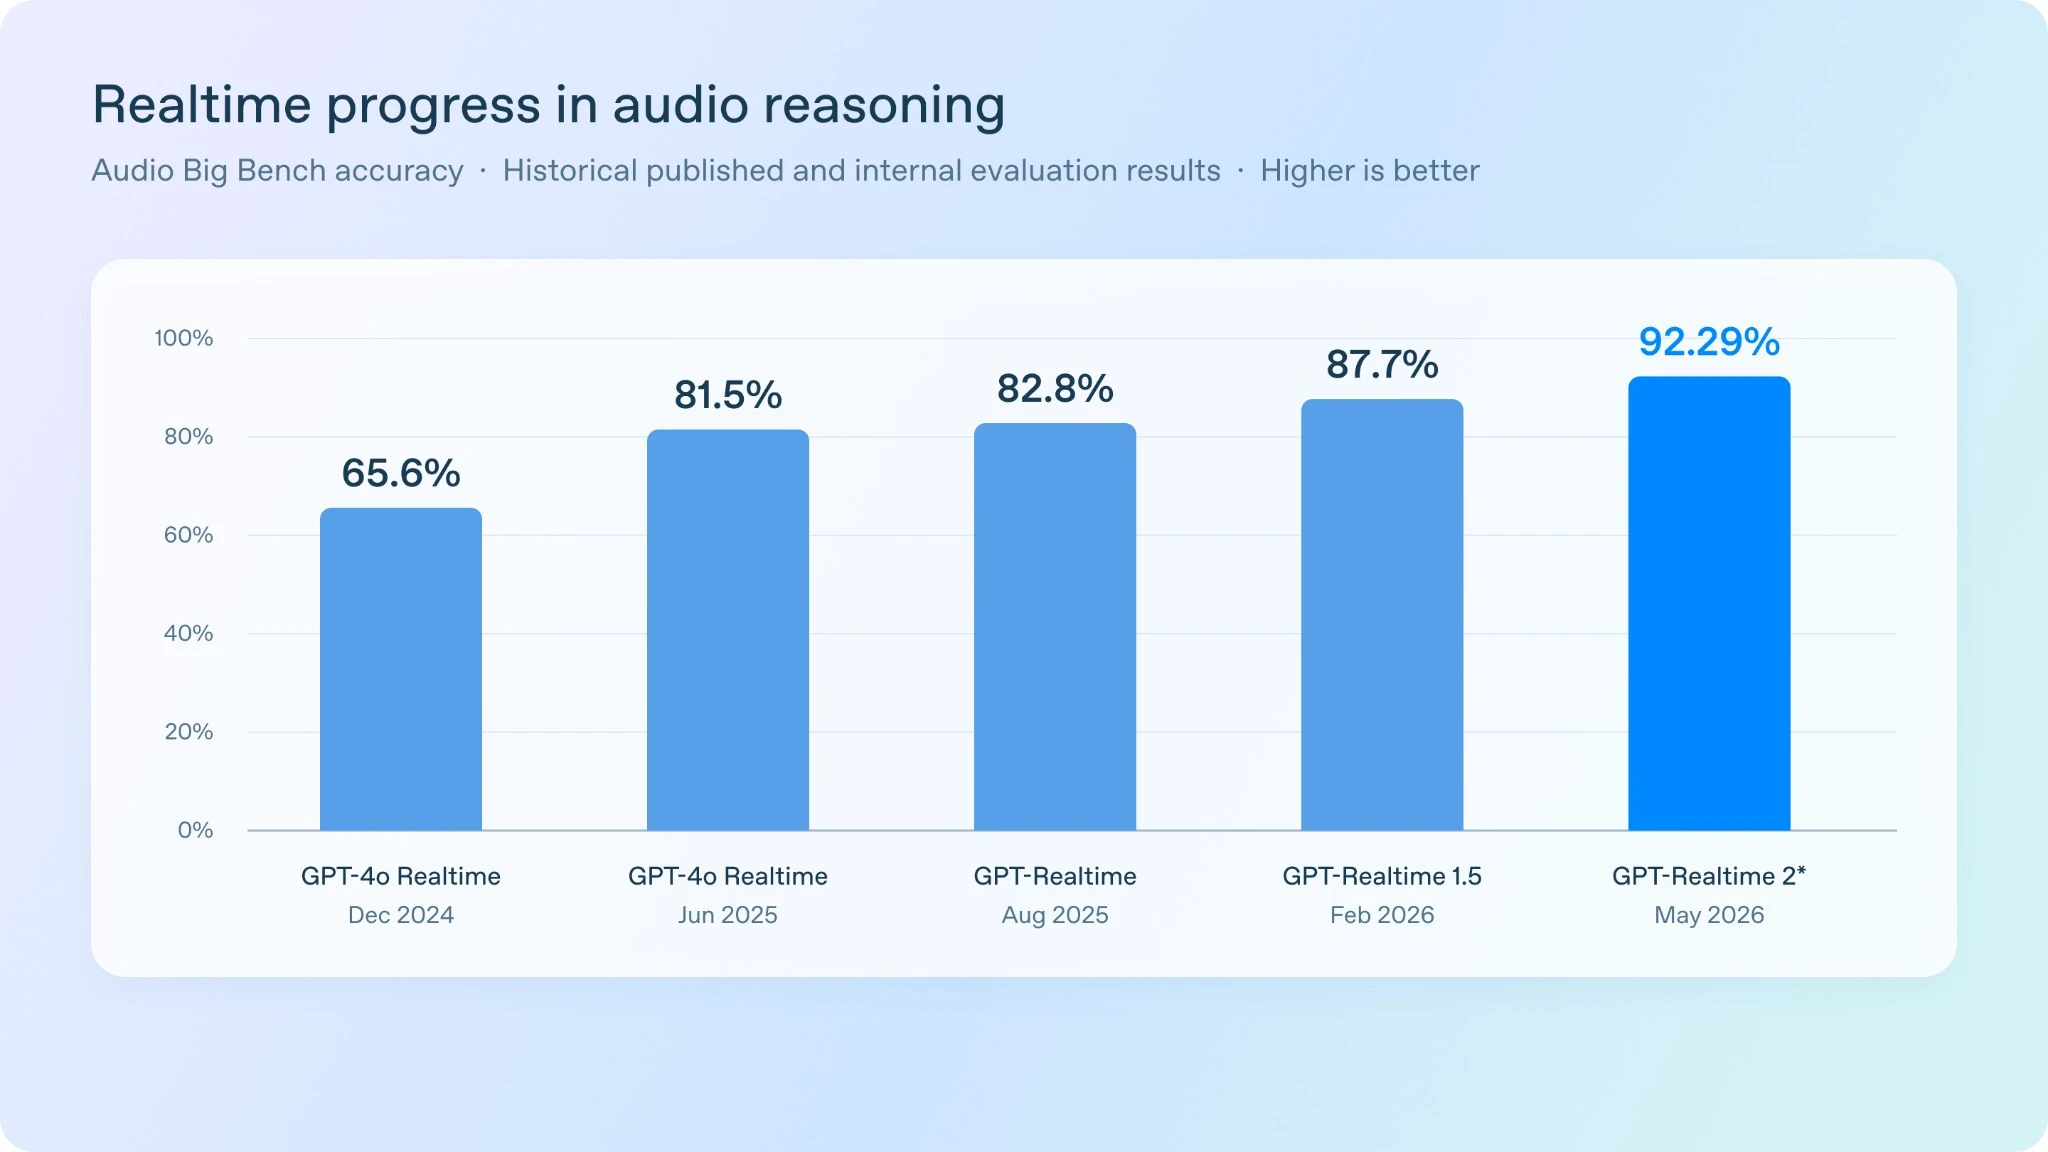
El modelo de voz resultante ahora sustenta la implementación de ese cliente, otras implementaciones personalizadas de atención al cliente y las implementaciones administradas a través de Presence. Un problema que encontramos en el negocio de un cliente ayudó a identificar mejoras que podrían servir a muchos otros.
Cada parte fue importante. El cliente se comprometió a trabajar en un problema que el modelo aún no podía resolver. Los ingenieros de implementación para clientes mantuvieron una colaboración estrecha para definir el problema, construir la plataforma e impulsar el proyecto de principio a fin. Investigación mejoró las capacidades del modelo subyacente.
Esta es la otra forma de volvernos innecesarios: ayudar a transformar un problema que los modelos actuales no pueden resolver en una capacidad que los modelos futuros puedan ofrecer. Los beneficios de nuestro trabajo van más allá de las horas que dedicamos a un cliente en particular.
Me uní a OpenAI para ayudar a que la IA fuera útil en el trabajo cotidiano de las personas. Eso sigue guiando al equipo. A menudo le digo al equipo que, en la mayoría de los casos de desarrollo de LLM, se aplica la navaja de Occam: la solución más simple es la mejor. En una empresa que se define por su investigación de vanguardia y en una industria marcada por las exageraciones, queremos crear soluciones que funcionen de manera confiable y en las que puedan apoyarse quienes las usan en la práctica.
La meta es que cada proyecto mejore lo que viene después: un producto más fácil de implementar, un modelo capaz de abordar una tarea más difícil o menos trabajo personalizado para el siguiente cliente.
Si tienes un problema difícil que quieres resolver, nos encantaría trabajar contigo. Si quieres ayudar a resolver esos problemas, nos encantaría que te unieras a nosotros.
Entonces, ¿qué hacemos cuando Codex puede encargarse del trabajo que nos tomó meses desarrollar?
Buscamos un problema más difícil.