మా మోడళ్ల సామర్థ్యాలను ఖచ్చితంగా కొలవడం, OpenAI యొక్క ప్రిపేర్డ్నెస్ ఫ్రేమ్వర్క్(కొత్త విండోలో తెరుచుకుంటుంది) కింద తీసుకునే నిర్ణయాలతో సహా, సముచితమైన అమలు మరియు భద్రతా నిర్ణయాలకు ముఖ్యమైనది. ప్రతి మోడల్ విడుదలతో, మోడల్ పురోగతిని ట్రాక్ చేయడానికి వివిధ బాహ్య, అంతర్గత బెంచ్మార్క్ల ఫలితాలను మేము నివేదిస్తాము. మూల్యాంకనాల్లో ఫలితాలను ప్రభావితం చేసే లోపాలు ఉంటే, అవి సామర్థ్యాలపై తప్పుడు అవగాహనను కలిగించవచ్చు, భద్రతా అంశాలను తప్పుగా చూపించవచ్చు, పరిశోధన ప్రాధాన్యాలపై ప్రభావం చూపవచ్చు.
విస్తృతంగా ఉపయోగించే కోడింగ్ బెంచ్మార్క్లలో ఒకటైన SWE-bench Verifiedలో ప్రాథమిక రూపకల్పన మరియు కలుషిత సమస్యలు ఎలా ఉన్నాయో మేము ఇటీవల పరిశీలించాము; ఆ మూల్యాంకనం ఇకపై సాఫ్ట్వేర్ అభివృద్ధి సామర్థ్యాలపై అర్థవంతమైన సంకేతాన్ని ఇవ్వడం లేదని కనుగొన్నాము. ఆ సమయంలో, విస్తృత సమాజం SWE-Bench Proకి మారాలని మేము ప్రోత్సహించాము.
ఎక్కువ వ్యవధులు మరియు మరింత వాస్తవికమైన కోడింగ్ టాస్క్లపై మోడళ్లను పరీక్షించడం ద్వారా ఏజెంటిక్ కోడింగ్ సామర్థ్యాలను మెరుగ్గా ట్రాక్ చేయడానికి, SWE-bench Verifiedను మెరుగుపరచేలా SWE-Bench Pro(కొత్త విండోలో తెరుచుకుంటుంది) రూపొందించబడింది. SWE-bench Verifiedలోలాగే, టాస్క్లు పబ్లిక్ మరియు ప్రైవేట్ రిపోజిటరీల సమితిలో ఫీచర్ మార్పుల చరిత్ర నుంచి ప్రోగ్రామాటిక్గా సేకరించబడతాయి. ఉన్న ఫంక్షనాలిటీని పాడుచేయకుండా, ఒక ఫీచర్ కోసం కొత్త పరీక్షల్లో ఉత్తీర్ణమయ్యే పరిష్కారాన్ని మోడళ్లు అమలు చేయాలి. 731-టాస్క్ పబ్లిక్ స్ప్లిట్లో, అత్యాధునిక మోడళ్లు ఎనిమిది నెలల్లో ఉత్తీర్ణత రేటును 23.3% నుంచి 80.3%కి మెరుగుపరచాయి.
ఆ తర్వాత మేము SWE-Bench Proపై కూడా ఇలాంటి ఆడిట్ నిర్వహించి, డేటాపాయింట్ విశ్లేషణ పైప్లైన్ను ఉపయోగించి డేటాసెట్ను సమీక్షించాము. సంభావ్య మూల్యాంకన లోపాలను గుర్తించడానికి, పైప్లైన్ టాస్క్పై మోడల్ ప్రయత్నాలు, టాస్క్ మెటాడేటా మరియు వైఫల్య ట్రేస్లను సమీక్షించింది. గుర్తించిన ప్రతి టాస్క్ను అనేక పరిశోధక-ఏజెంట్ దశల ద్వారా అంచనా వేసి, ఐదుగురు అనుభవజ్ఞులైన సాఫ్ట్వేర్ ఇంజినీర్లు స్వతంత్రంగా సమీక్షించారు; విభేదాలను మరింత దర్యాప్తుకు ఎస్కలేట్ చేశారు.
డేటాసెట్లో గణనీయమైన భాగంలో పని చేయని సమస్యల ఆధారాలు మాకు కనిపించాయి. మా డేటాపాయింట్ విశ్లేషణ పైప్లైన్ 200 (27.4%) పని చేయని టాస్క్లను గుర్తించగా, మానవ అనోటేషన్ ప్రచారం 249 (34.1%)ని గుర్తించింది.
సమస్యలు ప్రధానంగా నాలుగు వర్గాల్లోకి వచ్చాయి:
అతిగా కఠినమైన పరీక్షలు1 ప్రాంప్ట్లో పేర్కొనని నిర్దిష్ట అమలు వివరాలను అమలు చేయిస్తూ, కార్యపరంగా సరైన అనేక సమర్పణలను చెల్లనివిగా మారుస్తాయి.
తక్కువగా నిర్దేశించిన ప్రాంప్ట్లు2 దాచిన పరీక్షలు అమలు చేసే, అలాగే సమంజసంగా ఊహించలేని అవసరాలను వదిలేస్తాయి.
తక్కువ కవరేజ్ పరీక్షలు కోరిన ఫీచర్ను తగినంతగా తనిఖీ చేయవు, కాబట్టి అసంపూర్ణ సవరణలు ఉత్తీర్ణం కావచ్చు.
తప్పుదారి పట్టించే ప్రాంప్ట్ మోడళ్లను తప్పు ప్రవర్తన వైపు దారితీస్తుంది లేదా పరీక్షలు కోరేదానికి విరుద్ధంగా ఉంటుంది.
కఠినమైనప్పటికీ న్యాయమైన బెంచ్మార్క్లను ఎంపిక చేయడంలోని కష్టాన్ని, స్కేల్ చేయగల డేటా నాణ్యత తనిఖీల కోసం ఏజెంట్ల పెరుగుతున్న ప్రయోజనాన్ని మా కనుగొనింపులు చూపిస్తున్నాయి. ఈ ఫలితాల దృష్ట్యా, SWE-bench Pro టాస్క్లలో సుమారు ~30% పని చేయనివని మేము అంచనా వేస్తున్నాము, అలాగే మోడల్ డెవలపర్లు ఫలితాలను జాగ్రత్తగా పరిశీలించాలని సూచిస్తున్నాము.
టాస్క్ వైఫల్యాలు నిజమైన మోడల్ పరిమితులను ప్రతిబింబించడం, టాస్క్ విజయాలు ప్రాంప్ట్ అవసరాలకు పూర్తి మరియు చెల్లుబాటు అయ్యే పరిష్కారాలను ప్రతిబింబించడం నిర్ధారించడం మా లక్ష్యం. మూల్యాంకనంలో ఉపయోగించిన డేటా నాణ్యతను తనిఖీ చేయడానికి, ప్రతి డేటాపాయింట్ మోడల్ సామర్థ్యాలను ఖచ్చితంగా ప్రతిబింబిస్తుందో లేదో అంచనా వేసే నాణ్యత హామీ పైప్లైన్ను మేము సృష్టించాము.
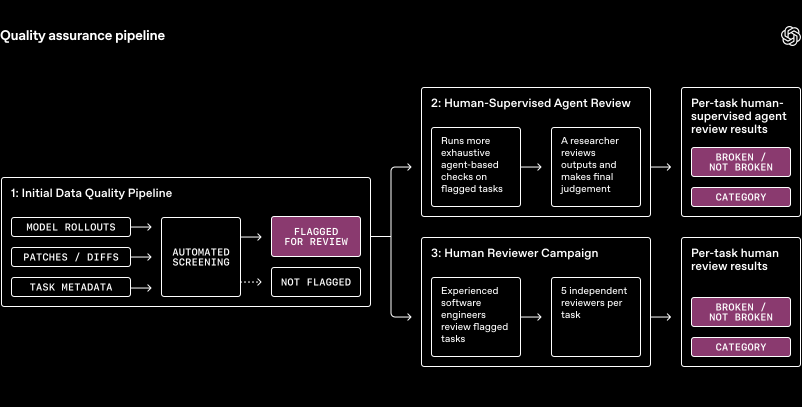
ప్రాథమిక డేటా నాణ్యత పైప్లైన్ సమీక్ష కోసం సమస్యలను గుర్తిస్తుంది. గుర్తించిన టాస్క్లపై మరింత లోతైన ఏజెంట్-సహాయక ఆడిట్తో, అలాగే అనుభవజ్ఞులైన ఇంజినీర్లతో కలిసి పనిచేసే మానవ అనోటేషన్ ప్రచారంతో మేము ధృవీకరిస్తాము.
ప్రారంభ ఆటోమేటెడ్ ఫిల్టర్ మోడల్కు ఇచ్చిన సూచనలు, టాస్క్ను పరిష్కరించడానికి మోడల్ చేసిన ప్రయత్నాలు, ఆ ప్రయత్నాలను గ్రేడ్ చేయడానికి ఉపయోగించిన పరీక్షలను సమీక్షించి, పని చేయని లేదా సమస్యాత్మకంగా ఉండే ఉదాహరణలను గుర్తిస్తుంది. ఈ ఫిల్టర్ పని చేయకపోవచ్చు అనిపించిన 286 టాస్క్లను గుర్తించింది. ఆ తర్వాత ఆ ఉపసమితిపై మేము రెండు విధాలుగా లోతైన సమీక్ష నిర్వహించాము: పరిశోధక ఏజెంట్లతో విస్తృత తనిఖీలు చేసి చివరికి మానవ తీర్పు ఇచ్చే మానవ-పర్యవేక్షిత ఏజెంట్ సమీక్ష; మరియు అనుభవజ్ఞులైన సాఫ్ట్వేర్ డెవలపర్లతో కలిసి పనిచేసే మానవ అనోటేషన్ ప్రచారం.
గుర్తించిన ప్రతి సమస్యను, టాస్క్ రిపోజిటరీ మరియు వాతావరణానికి యాక్సెస్ ఇచ్చిన Codex-ఆధారిత పరిశోధక ఏజెంట్లతో ఆడిట్ చేస్తారు. దీంతో సమీపంలోని కోడ్ మరియు రిపోజిటరీ సంప్రదాయాలను అధ్యయనం చేసి తరచుగా పరిష్కరించగల సమంజసమైన టాస్క్ అస్పష్టతను, నిజమైన తక్కువ నిర్దిష్టత నుంచి వారు వేరు చేయగలుగుతారు. ఏజెంట్ పరీక్షలను అమలు చేయగలదు, రిపోలోని ఫైళ్లను పరిశీలించగలదు, టాస్క్పై మోడల్ ప్రయత్నాలు మరియు వాటి సాధారణ వైఫల్య విధానాలను దర్యాప్తు చేయగలదు. ఈ లోతైన ఆడిట్లను స్వతంత్రంగా పలుమార్లు పునరావృతం చేసిన తర్వాత, ఒక పరిశోధకుడు సారాంశాలను సమీక్షించి, తుది నిర్ణయం తీసుకుని, సంభావ్య సమస్యలకు లేబుల్ వేశాడు.
ఇదే సమయంలో, గుర్తించిన ఉపసమితిపై మేము మానవ అనోటేషన్ ప్రచారాన్ని నిర్వహించాము. టాస్క్లను సమీక్షించే ముందు బెంచ్మార్క్ లక్ష్యాలు, సమస్యల వర్గీకరణ, ఎడ్జ్ కేసులపై శిక్షణ పొందిన అనుభవజ్ఞులైన సాఫ్ట్వేర్ ఇంజినీర్లతో మేము పనిచేశాము. ప్రతి టాస్క్ను ఐదుగురు ఇంజినీర్లు సమీక్షించారు.
పైప్లైన్ విశ్లేషణ లేదా ట్రాన్స్క్రిప్ట్ను సహాయక సందర్భంగా ఉపయోగించే ముందు, సమీక్షకులు కనిపించే సమస్య వివరణ, పరీక్షా సందర్భాలు, గ్రౌండ్-ట్రూత్ రిఫరెన్స్ పరిష్కారం (గోల్డ్ ప్యాచ్గా పిలుస్తారు) ఆధారంగా స్వతంత్ర తీర్పు ఏర్పరుచుకున్నారు. తర్వాత సమీక్షకులు స్పష్టమైన ఆధారాలపై ఆధారపడి లేబుల్ మరియు తీవ్రత రేటింగ్ను కేటాయించి, విభేదాలు లేదా తక్కువ నమ్మకం ఉన్న కేసులను మరింత సమీక్షకు ఎస్కలేట్ చేశారు.
పరిశోధక ఏజెంట్లతో పోలిస్తే మానవ సమీక్షకులు టాస్క్లను పని చేయనివిగా గుర్తించే అవకాశం ఎక్కువగా ఉంది. రెండు సమీక్ష మార్గాల మధ్య వర్గాలపై కొంత విభేదం కూడా ఉంది, కానీ గుర్తించిన ఏ టాస్క్లోనూ “పని చేస్తుంది” అనేది అత్యంత సాధారణ మానవ లేబల్ కాలేదు. ఏజెంట్ పైప్లైన్ గుర్తించిన వర్గాల్లో, సమీక్షకుల తీర్పులు 74% కేసుల్లో సరిపోలాయి.
ఏజెంట్ పైప్లైన్తో పోలిస్తే, మానవ సమీక్షకులు ఒక టాస్క్కు అనేక లేబల్లను ఎంచుకునే అవకాశం కూడా ఎక్కువగా ఉంది. అంటే టాస్క్లు అనేక రకాలుగా పని చేయనివిగా ఉన్నాయని లేదా ఒకే వర్గంలో స్పష్టంగా సరిపోవడం లేదని వారు గుర్తించారు. దీంతో ఏజెంట్-ప్లస్-సమీక్షకుల పైప్లైన్ జాగ్రత్తపూర్వక లేబులింగ్కు దారితీసిందని సూచిస్తుంది: మానవులు గుర్తించిన అదే విస్తృత వైఫల్య విధానాలను ఇది పట్టుకుంది, అయితే సమీక్షకులు అదనపు లేదా పరస్పరం మిళితమైన సమస్యలను చూసిన కేసులను తక్కువగా లెక్కించింది. అత్యధిక తేడా తక్కువ కవరేజ్ పరీక్షల్లో కనిపించింది; మానవులు బెంచ్మార్క్లో 9.4%కి దీన్నే అత్యంత సాధారణ సమస్యగా ఎంచుకోగా, ఏజెంట్ పైప్లైన్లో అది 4.1% మాత్రమే.
వైఫల్య విధానాలు
మేము గుర్తించిన సమస్యలు, SWE-bench Verifiedలోని ఇలాంటి కేసులతో కలిసి, బెంచ్మార్క్లను కఠినంగా తనిఖీ చేయడం ఎంత ముఖ్యమో చూపిస్తున్నాయి. ఓపెన్-సోర్స్ రిపోజిటరీలలోని ఇష్యూలు మరియు పుల్ రిక్వెస్ట్లు మొదట మానవ సహకారం కోసం సృష్టించబడ్డాయి; అవి తరచుగా మెయింటైనర్లు మరియు కాంట్రిబ్యూటర్ల మధ్య దీర్ఘ చర్చల ద్వారా రూపుదిద్దుకున్నాయి. ఫలితంగా, సమస్య వివరణలు, విలీనం చేసిన కోడ్, యూనిట్ పరీక్షలు మోడళ్లను విశ్వసనీయంగా మూల్యాంకనం చేయడానికి ఎప్పుడూ స్వచ్ఛమైన, విడిగా ఉండే టాస్క్లుగా సరిపోవు. ప్రత్యేకించి, పుల్ రిక్వెస్ట్లలో చేర్చిన పరీక్షలు అతిగా కఠినంగా ఉండవచ్చు; ఎందుకంటే అవి టాస్క్ను పరిష్కరించడానికి అమలుతో సంబంధం లేని ప్రమాణాన్ని నిర్వచించడానికి కాకుండా, నిర్దిష్ట మార్పును ధృవీకరించడానికి రాయబడతాయి.
అదే సమయంలో, మూల్యాంకన లోపాలను ఇప్పుడు గుర్తించడం, కొద్దికాలం క్రితం కంటే కూడా సులభమైంది. మోడల్ సామర్థ్యాలు మెరుగుపడుతున్న కొద్దీ, ప్రాంప్ట్లు, పరీక్షలు, ప్యాచ్లు, ట్రేస్లు, ఎడ్జ్ కేసులను మరింత లోతుగా మరియు స్థిరంగా పరిశీలించడానికి ఆ మోడళ్లను ఉపయోగించవచ్చు. దాంతో ముందుగా పెద్ద స్థాయిలో కనుగొనడం ఖరీదైనది లేదా ఆచరణీయం కానిది అయిన బెంచ్మార్క్ సమస్యలు బయటపడటానికి సహాయపడుతుంది.
మోడల్ సామర్థ్యాలను ప్రత్యేకంగా పరీక్షించేందుకు అనుభవజ్ఞులైన సాఫ్ట్వేర్ డెవలపర్లు నిర్మించిన కొత్త బెంచ్మార్క్లను విస్తృత మూల్యాంకన సమాజం అభివృద్ధి చేస్తుందని మేము ఆశిస్తున్నాము. ఆ విధానం మోడల్ సామర్థ్యాలను కొలవడంలో మనకు కావాల్సిన ఉన్నత ప్రమాణం మరియు వాస్తవికతను నిలబెట్టగలదు, అలాగే మొత్తం ప్రక్రియలో మెరుగైన మానవ పర్యవేక్షణకు వీలు కల్పిస్తుంది. ఈ విశ్లేషణలో బయటపడిన సమస్యలను దృష్టిలో ఉంచుకుని, SWE-Bench Proను స్వీకరించాలన్న మా మునుపటి సిఫార్సును మేము ఉపసంహరిస్తున్నాము.
చివరికి, ఒక మూల్యాంకనం గేమ్ చేయడం కష్టమైన, నమ్మడం సులభమైన, మోడల్ సామర్థ్యం లేదా అలైన్మెంట్ను నిజంగా ప్రతిబింబించే బెంచ్మార్క్ల ద్వారా అర్థవంతమైన సంకేతాన్ని ఇవ్వాలి. ఈ ఫలితాలు OpenAI యొక్క అమలు మరియు భద్రతా నిర్ణయాలకు సమాచారం అందిస్తాయి కాబట్టి, మేము ట్రాక్ చేసే మూల్యాంకనాలు చెల్లుబాటు అయ్యేవి మరియు ఉపయోగకరమైనవి కావాలి.


