Как Performance Factory от OpenAI помогает ChatGPT работать быстро
Наша система на базе Codex автоматизирует поиск и устранение проблем с производительностью.
Разработка с помощью агентов ускоряется настолько стремительно, что традиционные подходы к обеспечению производительности уже не справляются. Чтобы не отставать, мы создали Performance Factory — автономную систему, которая использует все возможности Codex и наших моделей для поиска и устранения регрессий с беспрецедентной скоростью. Performance Factory работает в облаке и автоматизирует расследование и устранение проблем с производительностью, позволяя нам выдерживать темп, заданный нашими амбициозными планами.
В Performance Factory инженеры задают рабочие процессы для регулярных задач и пишут инструкции для агентов Codex, которые их выполняют. В частности, процесс устранения регрессий создаёт задачу при срабатывании оповещения о проблеме с производительностью. Агент исследует замедление, записывает выводы в задачу и предлагает исправление на проверку инженеру. После развёртывания другой агент берётся за ту же задачу и проверяет, вернулась ли производительность к исходному уровню. Этот первый рабочий процесс в Performance Factory автоматизировал устранение регрессий целиком: от расследования и разработки исправления до проверки результата. За чуть более чем три месяца процесс устранения регрессий охватил свыше 1700 расследований и выявил первопричины более чем в 600 случаях. Это 17 автоматизированных расследований в день.
Здесь мы расскажем, как наше использование Codex привело к созданию Performance Factory, разберём первый запущенный рабочий процесс и поделимся первыми уроками разработки и эксплуатации агентных процессов в рабочей среде.
По мере того как мы всё шире применяли Codex в работе над производительностью, мы замечали, как меняется работа команды. Надеемся, наш опыт пригодится командам других сервисов при внедрении агентных процессов в своих областях.
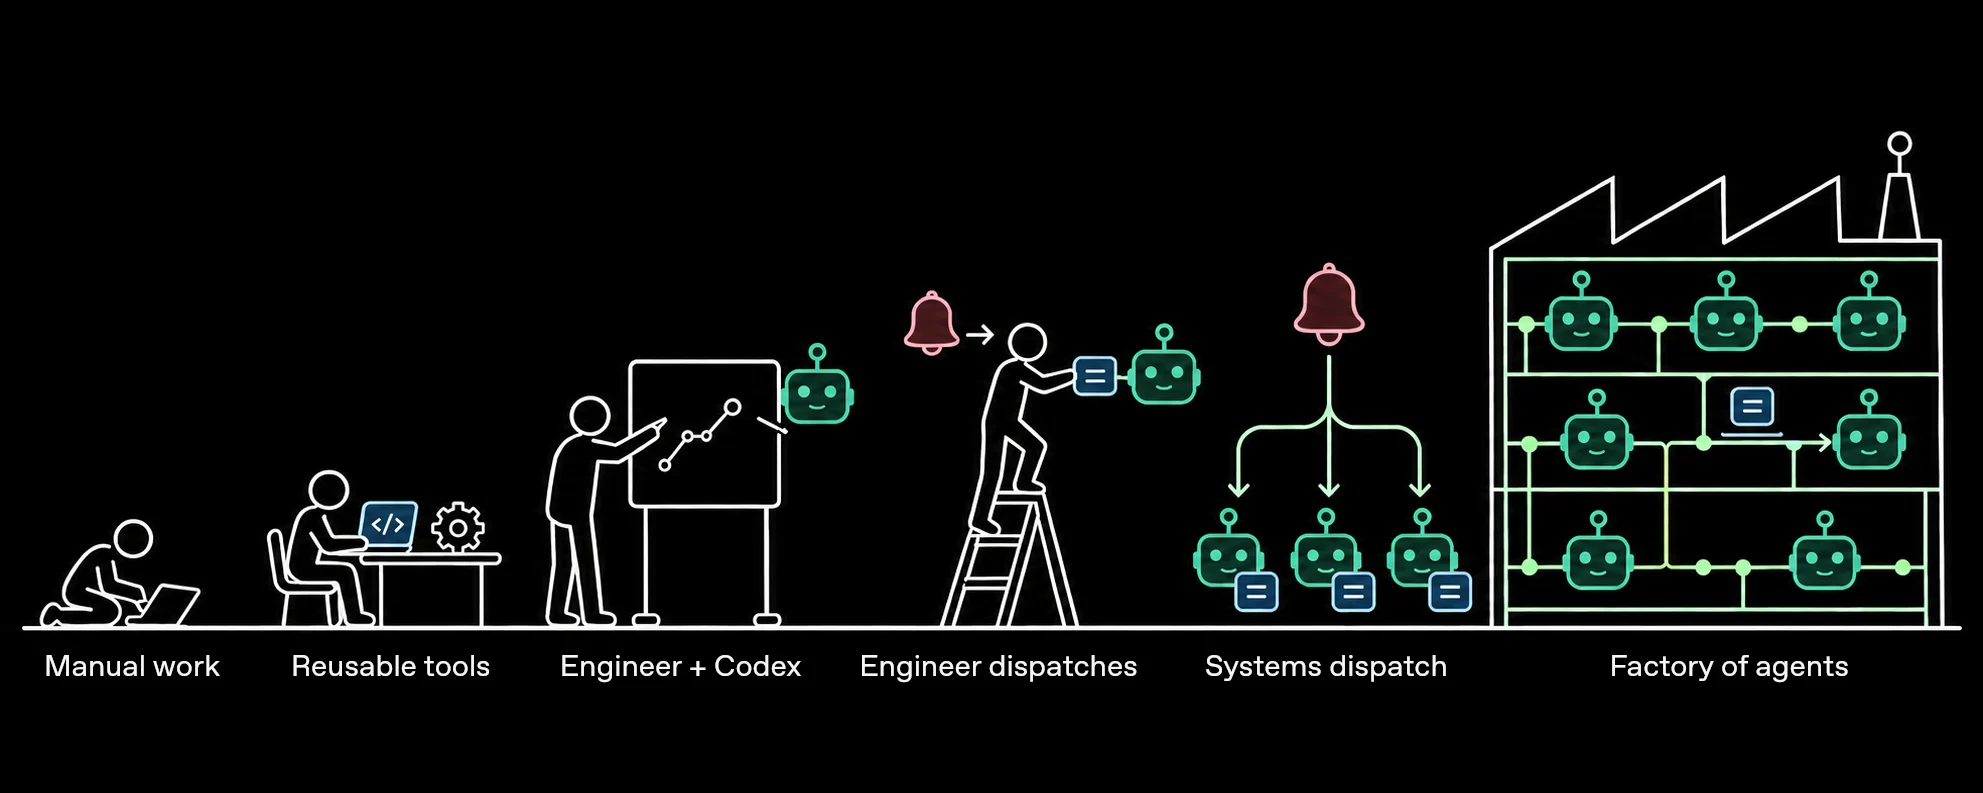
Работа над ПО развивается от ручного труда к сотрудничеству с машинами, а затем — к фабрикам агентов.
1. До Codex. До появления Codex инженеры вручную изучали метрики и логи, сравнивали трассировки, отлаживали работающие машины и читали код, чтобы разобраться в причинах замедления. Это отнимало много времени, а чтобы понять, где искать причину, часто требовалось глубокое знание сервиса. Важные сигналы было легко пропустить. Когда одни и те же проблемы повторялись — например, росла задержка до первого токена в ChatGPT, — мы создавали продвинутые инструменты, такие как профилировщики CPU и выделения памяти, чтобы упростить расследования. Со временем у нас накопилось более 30 инструментов для анализа производительности.
2. Codex как напарник. Когда нашим напарником стал Codex, инженеры могли спросить: «Почему это стало работать медленнее?» — и вместе с Codex разобраться в причинах, даже в незнакомой системе. Codex мог искать в больших кодовых базах, находить нужные метрики и трассировки, отслеживать взаимодействие сервисов и проводить подходящее профилирование, чтобы восстановить картину произошедшего. Но инженерам всё ещё приходилось руководить процессом: выбирать инструменты анализа производительности и направлять расследование. Больше людей получили возможность разбираться в сложных случаях, затрачивая меньше времени и не обладая столь глубокими знаниями.
3. Навыки для повторного использования. Для дальнейшей автоматизации мы описали процесс расследования нашей команды по производительности в общем навыке perf-forensics. Он объясняет Codex, какие инструменты доступны, когда их использовать и как исследовать замедление, чтобы подойти к решению с нескольких сторон:
Определить, когда началось замедление
Выявить затронутые запросы
Проверить, могут ли развёртывания или изменения конфигурации объяснить замедление
Мы тестировали и дорабатывали навык perf-forensics с помощью оценочных тестов на основе прошлых регрессий. Для тех видов регрессий, на которых мы сосредоточились — например, роста задержек и снижения доступности ChatGPT, — теперь было достаточно передать Codex оповещение и получить диагноз за один запуск, не направляя его на каждом шаге.
4. Человек-посредник. По мере добавления и улучшения навыков Codex для работы с производительностью, таких как perf-forensics, мы стали чувствовать себя посредниками между оповещениями и Codex. Срабатывало оповещение, и инженер просто копировал его в Codex, выбирал нужный навык, а затем переносил выводы в Slack.
5. Автоматизированные расследования. Затем мы перенесли расследования в облако, чтобы оповещение могло автоматически запускать сеанс Codex. Codex исследовал замедление и публиковал выводы в ветке Slack, но на этом ответе автоматизация заканчивалась. Инженеру всё ещё приходилось изучать диагноз, разрабатывать исправление и после развёртывания проверять, сработало ли оно. Оповещения накапливались, и даже для того, чтобы понять, какие регрессии требуют внимания, приходилось просматривать ветки Slack.
6. Фабрика. Мы создали Performance Factory, чтобы агенты могли выполнять весь цикл работ по обеспечению производительности. Система отслеживает следующий шаг для каждой активной задачи и назначает агента, когда этот шаг готов к выполнению. В каждой задаче сохраняются состояние и выводы, поэтому работу можно передавать между агентами и инженерами и возобновлять после проверки кода или развёртывания. В случае регрессии работа начинается с расследования по оповещению и заканчивается проверкой восстановления в рабочей среде. Мы можем превращать типовые оптимизации в рабочие процессы, регулярно запускаемые во всех наших сервисах. Процесс, обнаруживший возможность оптимизации, может создать задачу в другом процессе, чтобы проверить и реализовать её.
Performance Factory состоит из четырёх компонентов: трекера задач с настраиваемыми рабочими процессами, цикла диспетчеризации, который назначает агентам готовую к выполнению работу, API для запуска Codex в облаке и подписок, которые активируют агентов при изменениях — например, при появлении комментария к проверке кода в GitHub или завершении развёртывания.

Performance Factory состоит из сервиса задач, цикла диспетчеризации, облачной среды выполнения и подписок.
В сервисе задач инженеры задают рабочие процессы, добавляя файлы конфигурации и написанные в Markdown промпты с инструкциями для агентов. Конфигурация перечисляет возможные состояния задачи, допустимые переходы между ними и шаги, требующие участия инженера. Отдельные промпты объясняют агентам, что делать на каждом шаге.
Каждая работа становится задачей в определённом процессе, а все процессы видны в интерфейсе. Инженеры могут видеть открытые задачи, следить за ходом работы и делиться задачей с коллегой, который лучше знает контекст или может помочь на следующем шаге.
Цикл диспетчеризации периодически проверяет, какие задачи готовы к следующему шагу. Он назначает агента каждой задаче, запуская цикл работы Codex с инструкциями для её текущего состояния. Агент записывает ход работы в задачу и, завершив шаг, переводит её в следующее состояние.
Получив задачу, агенту нужна среда для её выполнения с доступом к тем же инструментам, которыми пользовался бы инженер. Мы создали внутренний API для программного запуска цикла работы Codex в облаке. Цикл работы Codex выполняется в среде внутри нашей сети с доступом к репозиториям кода и средствам наблюдаемости, которыми пользуются инженеры: метрикам, логам, трассировкам, профилям CPU и снимкам памяти.
Агент работает под служебной учётной записью, поэтому мы можем ограничивать его права и видеть, какие действия выполнили наши агенты по производительности. Перенос работы агентов в облако позволяет выполнять задачи параллельно: больше не нужно держать ноутбуки инженеров включёнными или вручную управлять отдельными облачными машинами для разработки.
Иногда работа должна дождаться человека или развёртывания; агенту незачем всё это время оставаться запущенным. Если задача должна ждать, для неё можно оформить подписку на события — например, комментарии к проверке кода или сбои проверок CI в pull request на GitHub, — чтобы получить уведомление, когда пора возобновить работу. Когда поступившее событие соответствует подписке, задача снова становится готовой к выполнению, и цикл диспетчеризации может назначить агента для продолжения работы.
Первым процессом, который мы создали в Performance Factory, стал поиск регрессий, определение их первопричин и устранение. Мы называем его процессом устранения регрессий. Регрессия производительности проходит несколько этапов: требуется расследование, первопричина найдена, исправление предложено и проблема решена. Мы построили автоматизированный процесс так, чтобы задача проходила те же этапы.
Когда срабатывает одно из настроенных оповещений о производительности, процесс устранения регрессий создаёт задачу, которую агенты берут в работу и проводят через эти этапы. Статус и ключевые выводы сохраняются в самой задаче, вне контекста отдельного агента, чтобы другие агенты или инженеры могли продолжить работу. Инженеры могут следить за работой в Slack или интерфейсе процесса устранения регрессий, добавлять контекст и проверять предлагаемые изменения. После развёртывания исправления агент проверяет, вернулась ли производительность к исходному уровню, и лишь затем закрывает задачу.
Процесс устранения регрессий в Performance Factory
Обнаружена регрессия.


- ОбнаруженоСистема
- Поиск первопричиныАгент
- Предложение исправленияАгент
- Проверка и развёртываниеИнженер
- Проверка восстановленияАгент
- Решено
Текущий этап: Обнаружено
Процесс устранения регрессий включает поиск первопричины, предложение исправления, проверку и развёртывание, а также подтверждение восстановления.
Поиск первопричины или нескольких причин — первый важный шаг процесса. Сначала агент выясняет, какие метрики ухудшились, когда они начали меняться и какие запросы к сервису были затронуты. Навык perf-forensics даёт Codex доступ к инструментам наших инженеров по производительности и инструкции по поиску ответов на эти вопросы.
Оповещение срабатывает, когда метрика пересекает порог, но регрессия могла начаться несколькими часами ранее. Агент просматривает более ранние данные, чтобы найти момент, когда метрика впервые ухудшилась. Затем он сравнивает группы запросов: похожие запросы действительно стали выполняться медленнее или мы начали обрабатывать больше запросов, которые и раньше были медленными? Эти варианты указывают на разные причины.
Определив, где и за какой период искать, агент изучает развёртывания и изменения флагов функций, а затем читает соответствующий код. Он проверяет, когда изменение фактически затронуло проблемные запросы, и по логам или трассировкам выясняет, может ли код объяснить произошедшее.
Поначалу агенты иногда останавливались на первом правдоподобном объяснении, и некоторые из этих диагнозов оказывались неверными. Чтобы выявлять такие ошибки, мы добавили критическую проверку: отдельный сеанс Codex, цель которого — опровергнуть предложенный диагноз. Проверяющий агент заново проверяет предположения и рассматривает контрфактические сценарии. Если замедление вызвано развёртыванием, продолжали ли похожие запросы, которых оно не затронуло, работать нормально? Если подозреваемое изменение откатили, восстановилась ли затронутая метрика?
В одном расследовании агент связал сбои в диалогах ChatGPT с ошибками загрузки изображений и отметил первопричину как найденную. Проверяющий агент Codex заметил, что внутренний сервис, отвечающий за определение местоположения файлов, уже восстановился, а запросы изображений всё ещё завершались ошибками. Диагноз не объяснял продолжающиеся сбои, поэтому ИИ-проверяющий возобновил расследование и записал, что ещё нужно установить.
Хорошие результаты даёт разделение крупных задач на отдельные циклы работы Codex с узкой целью. При ручной проверке 100 предложенных первопричин мы признали 70% точными, а 30% — требующими доработки или не полностью доказывающими причинно-следственную связь. В процессе устранения регрессий отдельные циклы посвящены расследованию, оспариванию диагнозов и предложению исправлений. Такая система сдержек и противовесов повышает точность.
Когда диагноз проходит критическую проверку, рабочий процесс поручает Codex реализовать исправление и открыть pull request. Инженер проверяет PR и решает, включать ли его в основную ветку. Мы приложили немало усилий, чтобы максимально упростить эту передачу работы. У каждой задачи есть отчёт с автоматически составленной сводкой о регрессии, её последствиях, первопричине и предлагаемом исправлении. Мы доработали сводки так, чтобы их было удобно просматривать: добавили временные ряды метрик, пламенные графики CPU и трассировки, которые помогают инженерам быстро понять выводы и проверить подтверждающие данные. Инженеры могут напрямую редактировать PR или использовать диагноз для написания собственного исправления. Если они оставляют комментарии к PR, рабочий процесс активирует агента, чтобы учесть замечания.
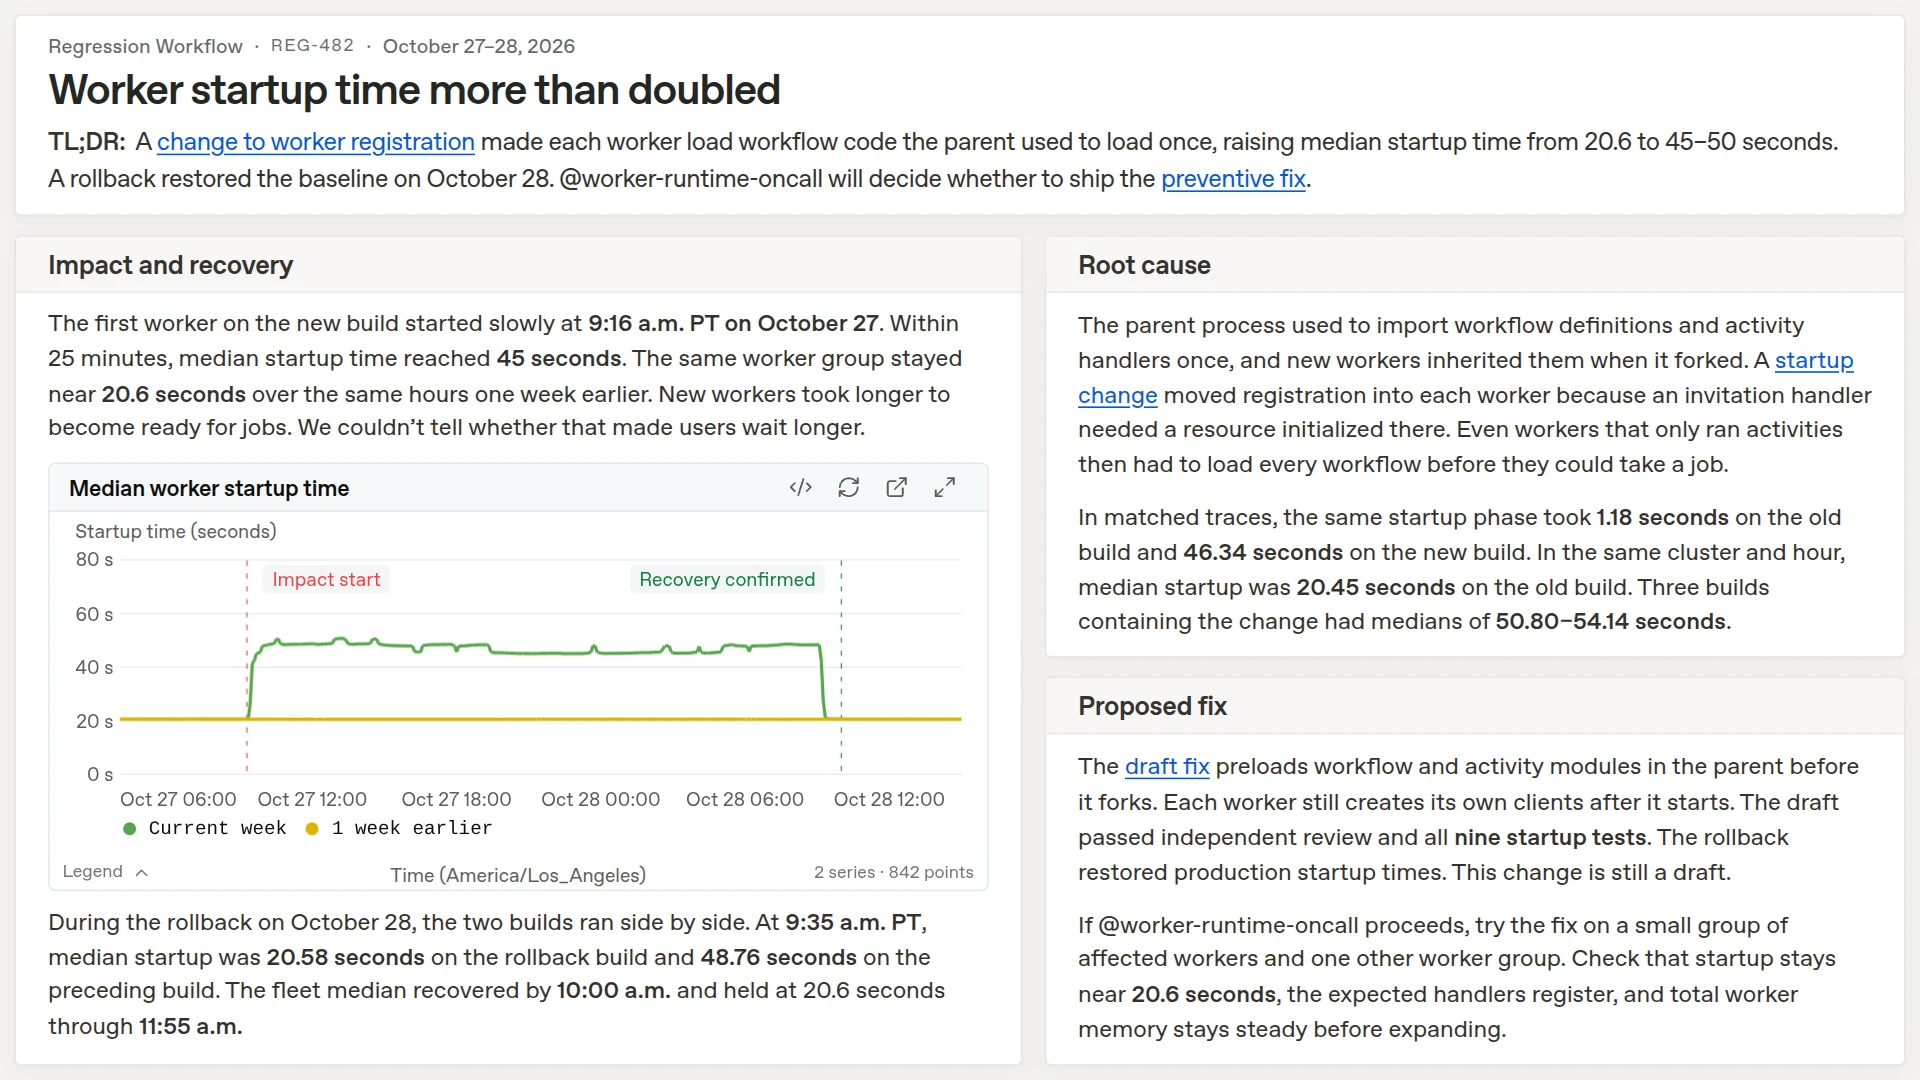
Пример отчёта по задаче о регрессии: ключевые сведения, первопричина и предлагаемое исправление.
После того как инженер развёртывает исправление, процесс активирует агента для проверки, вернулась ли производительность к прежнему базовому уровню. Если да, агент помечает задачу как решённую. Если производительность восстановилась лишь частично, агент закрывает исходную регрессию и создаёт новую задачу для оставшегося замедления, у которого может быть другая причина. Если улучшения нет, агент записывает результат и возвращает регрессию на расследование.
Разрабатывать верные исправления оказалось сложнее, чем находить причину. Например, мы видели случаи, когда предложенные агентом изменения были сложнее необходимого или создавали новые проблемы. Как и на этапе поиска первопричины, мы добавили критическую проверку каждого предложенного исправления: она помогает убедиться, что оно устраняет первопричину, и выявить ошибки или непредвиденные последствия. Некоторые исправления также требуют архитектурных решений более высокого уровня. Например, добавление кэша может повысить производительность, но привести к использованию устаревших данных. В таких изменениях полезно участие инженера, который знает сервис и может взвесить компромиссы.
На основе этих случаев мы выстраиваем цикл оценки и улучшения. Сравнивая исправления, предложенные агентами, с изменениями, которые инженеры в итоге включают в код, мы можем лучше понять недостатки предложений, создавать оценочные тесты и улучшать рабочий процесс. Мы также работаем над применением синтетических тестов производительности, чтобы агенты могли измерять эффект предлагаемых исправлений и дорабатывать их, прежде чем обращаться к инженеру за проверкой. Кроме того, мы изучаем, как агенты могут использовать другие наши агентные инструменты проверки для выявления изменений с низким риском и со временем выпускать такие исправления без участия человека.
Создание и эксплуатация Performance Factory многому научили нас в разработке и использовании агентных процессов в рабочей среде. Вот несколько уроков для команд, которые создают собственные агентные процессы.
Необработанный результат расследования Codex может оказаться стеной текста, в которой трудно разобраться. Нужно приложить усилия, чтобы понять утверждения агента и найти графики для проверки, подтверждаются ли они данными. Мы хотим, чтобы инженеры сосредоточились на решениях, а не восстанавливали ход работы агента.
Агенты могут расследовать больше регрессий, чем команда успеет изучить по отчётам. В первой версии инженеры получали интерфейс, полный результатов, но кому-то всё равно нужно было решать, какая информация важна. Одна регрессия также может выглядеть как несколько инцидентов в разных оповещениях, средствах мониторинга и каналах. Теперь рабочий процесс объединяет связанные инциденты, группирует их по важным для команд метрикам и ранжирует по предполагаемому влиянию. Инженеры могут сосредоточиться на добавлении контекста, оценке компромиссов и выборе изменений для выпуска.
Обновление навыка расследования или модели может улучшить диагностику одних случаев и ухудшить других, поэтому перед внедрением таких обновлений нужно проверять их влияние. Мы отдельно проверяем два аспекта: 1) насколько хорошо агент проводит расследование и 2) насколько его сводки полезны инженерам.
Качество расследований мы проверяем на прошлых инцидентах в рабочей среде. Мы превращаем эти инциденты в набор тестовых случаев, которые можно повторно запускать при изменении навыка. Агент Codex пытается расследовать и устранить инцидент, а мы сравниваем его действия с данными о том, как проблему решили в действительности. Каждый случай начинается с нового агента-расследователя Codex и исходного сигнала, из которого убраны детали, способные выдать ответ.
Тесты на исторических данных требуют осторожности. Срок хранения метрик и трассировок истекает, а данные, собранные после восстановления, могут выдать причину. Тест полезен только тогда, когда мы понимаем, какие данные были доступны расследователю. Агент может изучать код и запрашивать телеметрию рабочей среды в заданных пределах. Он не может использовать сохранённую память — заметки из предыдущих расследований, — читать отчёт об инциденте или видеть результаты прошлых запусков. После теста мы также просматриваем запись сеанса на предмет информации, которая могла исказить результаты.
Мы оцениваем точность определения времени начала проблемы, её масштаба и затронутых запросов. Также мы оцениваем, как агент использует данные, чтобы ранжировать возможные причины и объяснять, что остаётся неясным. Агент может верно определить время, но приписать проблему не тому развёртыванию, поэтому эти аспекты мы оцениваем отдельно.
Мы оцениваем сводки по задачам с помощью снимков сохранённых задач. Они особенно удобны для тестирования на исторических данных, поскольку составление сводок не зависит от внешних метрик или трассировок с ограниченным сроком хранения. Отдельный оценщик проверяет, сможет ли инженер, незнакомый с системой, понять, что произошло и почему это важно, сохранены ли полезные графики и подтверждают ли данные предлагаемый следующий шаг.
Наконец, нашим агентам мониторинг нужен не меньше, чем сервисам, которые они исследуют. Неработающий профилировщик или нехватка прав могут помешать агенту проверить причину замедления. Такие сбои бывает трудно заметить в итоговом отчёте, поэтому мы ежедневно запускаем агента, который просматривает сообщения и логи недавних запусков в поисках сбоев инструментов и ошибок доступа.
Мы используем Performance Factory для самовосстановления — устранения проблем, выявленных этой проверкой. Если одна и та же ошибка инструмента блокирует несколько расследований, агент создаёт задачу на её исправление. Если причина ясна, агент предлагает исправление, а инженер проверяет изменение и решает, включать ли его в основную ветку. После включения таких изменений мы также запускаем оценочные тесты, чтобы проверить, могут ли агенты пройти шаг, на котором раньше останавливались.
Процесс устранения регрессий — лишь один пример применения архитектуры фабрики агентов, в которой задачи проходят через явно заданные состояния. Агенты продвигают задачу, когда следующий шаг готов к выполнению; отдельные проверяющие агенты оспаривают выводы; инженеры подключаются, когда очередное решение требует экспертного суждения. Другие процессы могут использовать тот же механизм с иными состояниями, инструкциями и событиями.
От одного процесса ко многим. Performance Factory координирует агентов в разных рабочих процессах: агенты одного процесса могут создавать задачи для другого.
Сейчас наш процесс устранения регрессий запускается при срабатывании оповещения. Но мы работаем над более проактивными способами поиска замедлений и возможностей оптимизации в Performance Factory — даже когда оповещения не срабатывают. Мы хотим, чтобы агенты использовали большой объём подробных данных о производительности, которые мы уже собираем, для обнаружения регрессий, пропущенных оповещениями, и возможностей оптимизации. Сравнивая данные из разных релизов — наборы профилей CPU и памяти, дампы кучи и трассировки запросов, — агент может заметить небольшой рост затрат CPU на определённый запрос. Затем он может создать задачу в процессе устранения регрессий, чтобы найти причину роста, реализовать исправление и открыть PR на проверку инженеру.
В случаях, когда мы уже знаем, что искать, мы работаем над тем, чтобы использовать известные сигналы в большем числе рабочих процессов Performance Factory. Например, наш навык подбора ресурсов для сервисов помогает агентам находить настройки автомасштабирования, которые поддерживают больше работающих реплик, чем нужно сервису. Научившись распознавать такую закономерность, мы хотим создавать для неё рабочий процесс и регулярно запускать его во всех наших сервисах, постоянно оптимизируя их в быстро меняющейся среде. Благодаря Performance Factory опыт инженера, полученный при разборе одного замедления, может влиять на расследование и устранение следующего — даже спустя месяцы и в другом сервисе.
Если в следующий раз вы заметите замедление в ChatGPT, вполне вероятно, что Performance Factory уже выясняет его причину. Сегодня узким местом может быть ожидание инженера, который проверит исправление и включит его в основную ветку. Мы уже изучаем, могут ли агенты делать это самостоятельно. Codex продолжает ускорять разработку продуктов, и, чтобы не отставать, системы обеспечения производительности должны становиться всё более автономными и способными к самоулучшению. Codex уже помогает нам быстрее развивать ChatGPT. Теперь он помогает и самому ChatGPT работать быстро.