Как Amplitude улучшает продукт за 1–2 дня с OpenAI
Проактивный продуктовый агент Wave от Amplitude, работающий преимущественно на моделях OpenAI, определяет, что стоит разработать, помогает командам внедрять изменения с агентами программирования и измеряет эффект.
160%
Рост взаимодействия с агентом по сравнению с контрольной группой через один день
1–2 дня
Расчётное время выпуска улучшения продукта с Wave
51%
Снижение средней стоимости работы модели за запуск задания для GPT‑6.1 Sol при оценке агента анализа данных Amplitude.
1,34 $
Стоимость работы модели GPT‑6.1 Sol при оценке агента исследования возможностей Amplitude.
Amplitude всегда помогала командам понять, как люди на самом деле пользуются их продуктами. Её проактивный продуктовый агент Wave помогает командам превращать эти знания в реальные улучшения. По данным Amplitude, работа Wave примерно на 80% обеспечивается моделями OpenAI, включая GPT‑6.1 Sol, GPT‑6 Luna и GPT‑Image‑2.5 Flare. Wave превращает выводы о продукте в планы реализации, которые команды могут передавать агентам программирования, включая Codex, а затем измеряет эффект.
По оценке Amplitude, Wave может помочь командам сократить срок выпуска улучшений продукта примерно с месяца до 1–2 дней. На главной странице самой Amplitude Wave помог персонализировать карточки с подсказками, что увеличило число отправленных через них сообщений на 160%.
«Теперь ИИ может находить полезную работу, которую нам даже не приходило в голову ему поручать. Модели OpenAI могут исследовать проблему, писать и запускать код, а затем на основе результатов решать, что попробовать дальше».
Wave — проактивный продуктовый агент Amplitude. Команды задают ему область продукта, цели и метрики, которые хотят улучшить. Wave объединяет данные Amplitude, записи сеансов, отзывы клиентов и код, чтобы выявлять возможности и расставлять приоритеты, разрабатывать решения и координировать их реализацию с людьми и агентами программирования. Затем он отслеживает результаты и учитывает полученные знания при планировании следующего этапа улучшений.
Для разных задач в этом процессе Amplitude использует разные модели OpenAI. GPT‑6.1 Sol обеспечивает работу менеджера возможностей и глубокое исследование кода и данных. GPT‑6 Luna выполняет частые задачи с меньшими затратами, например сканирование кода и небольшие оценочные проверки. GPT‑Image‑2.5 Flare создаёт макеты продукта, используя скриншоты из записей сеансов как визуальные образцы.
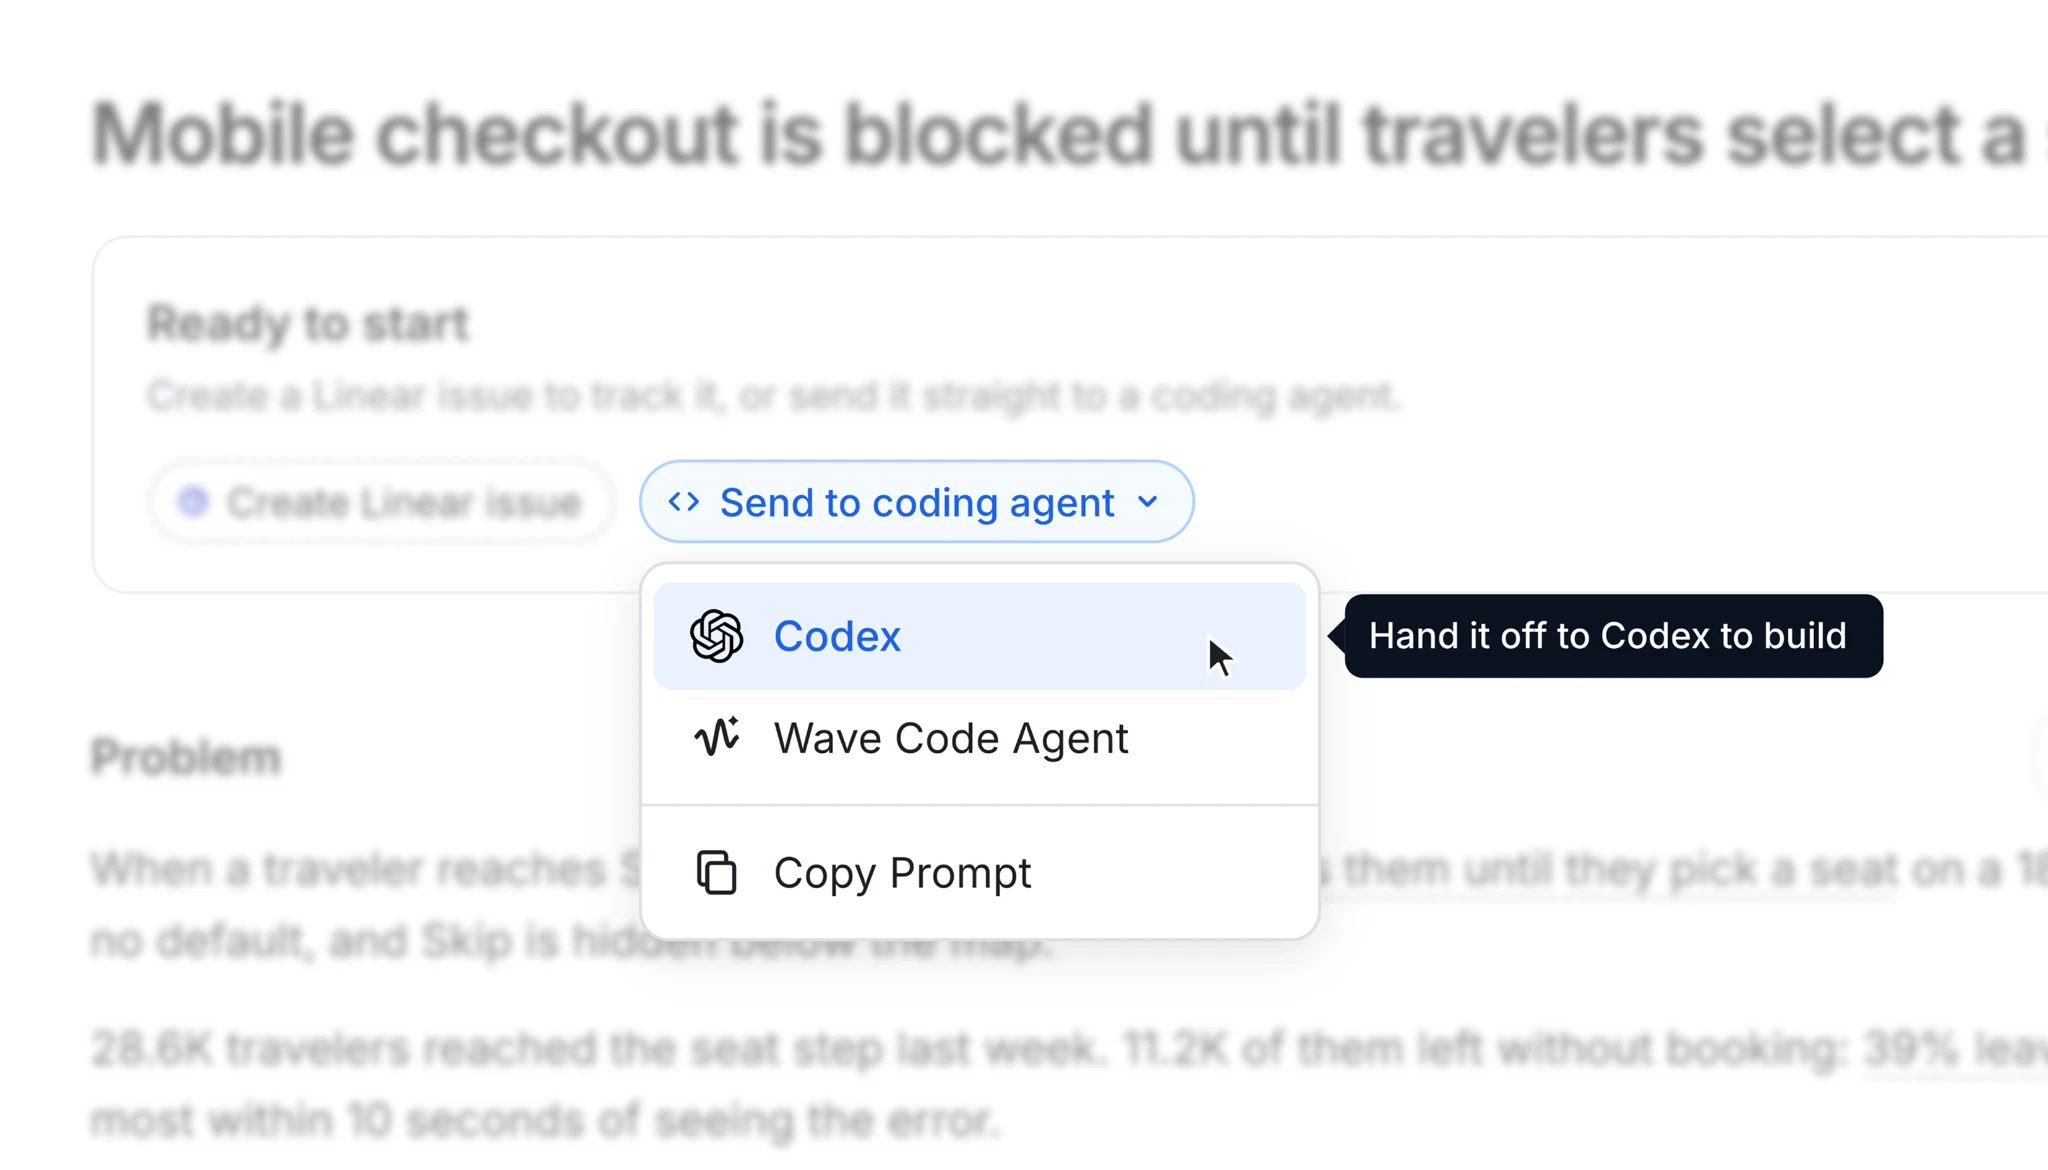
Когда возможность готова к реализации, команды могут передать её прямо из Wave агентам программирования, включая Codex, вместе с техническим планом и критериями приёмки.
«Идея Wave — единая платформа с агентами, которые изучают огромные объёмы записей сеансов, аналитики и кода, чтобы находить возможности для улучшения продуктов», — объясняет Джейкоб Ньюман, главный менеджер ИИ-продуктов Amplitude.
Amplitude протестировала Wave на собственной главной странице, где стандартные карточки с подсказками должны были помогать пользователям начинать разговор с ИИ-агентом. Wave обнаружил, что люди часто их игнорировали: в выборке из 100 записей сеансов 80 пользователей вводили собственные вопросы и лишь 12 выбирали подсказку.
Wave предложил персонализировать карточки на основе недавно просмотренных графиков, дашбордов или страницы, с которой пришёл пользователь. Он наглядно показал изменение и подготовил технический план, предусматривающий свободный ввод текста и стандартные подсказки на случай, когда контекст для персонализации недоступен. После короткой проверки команда передала работу агенту программирования и провела A/B-тестирование изменения.
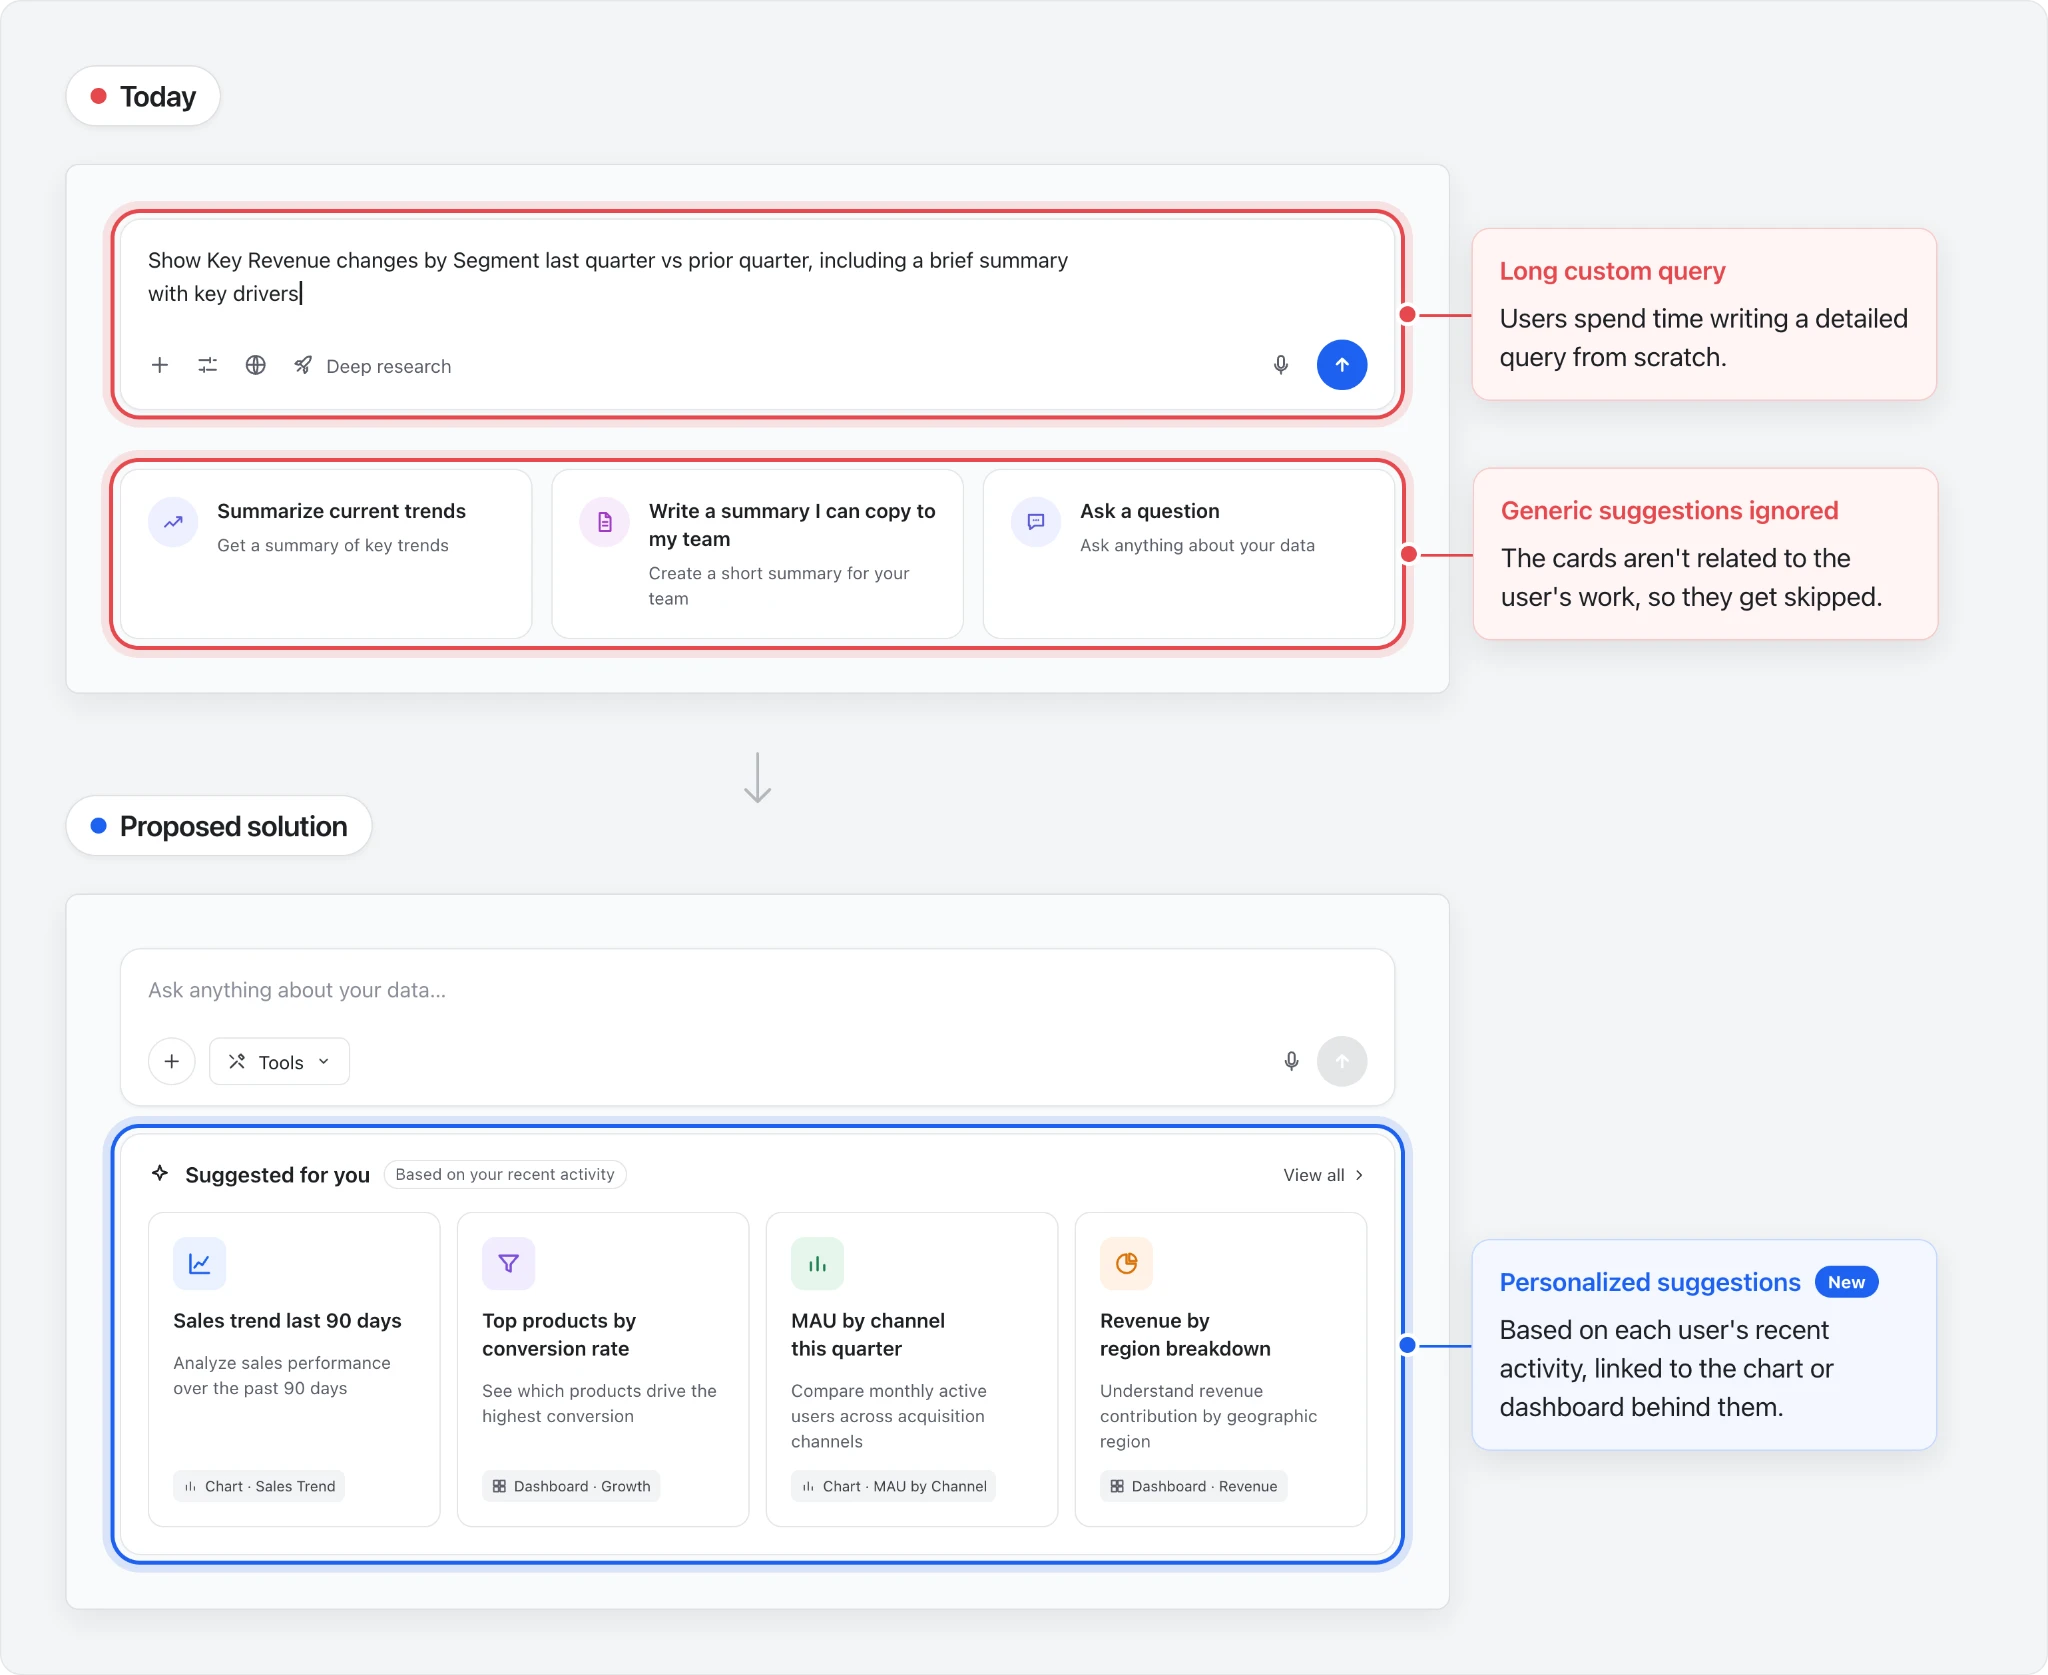
Согласно результатам эксперимента, которыми поделилась Amplitude, через один день число сообщений, отправленных через карточки с подсказками на главной странице, выросло на 160% относительно контрольной группы. «Это отличный пример того, как небольшие улучшения, которые обычно остаются без внимания, могут неожиданным образом увеличить использование функций», — объясняет Эрик Карлсон, старший главный инженер по ИИ в Amplitude.
Задачи Wave предъявляют разные требования к моделям. Для глубокого исследования нужны сильные способности к рассуждениям и хорошо обоснованные выводы. Небольшая проверка, повторяемая сотни раз, должна быть быстрой и недорогой. Amplitude оценивает качество, задержку и стоимость для каждой задачи и на этой основе выбирает модели.
«OpenAI предоставила нам и модели с сильными способностями к рассуждениям, и более компактные, быстрые модели. Это позволило нам найти баланс между качеством, задержкой и стоимостью инференса во всём продукте»
При оценке агента исследования возможностей Wave компания Amplitude проверяла, подтверждают ли модели свои выводы, избегают ли ложноположительных результатов, учитывают ли обратную связь от оценщика, восстанавливаются ли после сбоев инструментов и соотносят ли утверждения с доказательствами. GPT‑6.1 Sol получила общую оценку 4,06 из 5, тогда как три альтернативные модели — 3,62, 3,52 и 2,94. Она лидировала по всем пяти критериям исследования и показала наименьшее медианное время исследования — 54 минуты.
В отдельной оценке агента анализа данных Wave модель GPT‑6.1 Sol набрала 67,5 из 100 баллов против 69,3 у другой ведущей модели, при средней стоимости работы модели 1,28 $ против 2,63 $ за запуск задания. GPT‑6.1 Sol также получила более высокие оценки за соблюдение контрактов инструментов, оценивание и учёт неопределённости, а также за заземление на подтверждающих данных.
Для массовых задач, таких как сканирование кода и небольшие оценочные проверки, Amplitude использует GPT‑6 Luna, чтобы сохранять низкую задержку и небольшие затраты. Распределение работы между специализированными агентами позволяет команде использовать более дорогие рассуждения только там, где они особенно нужны.
В оценке создания каркасных и визуальных макетов модель генерации изображений OpenAI набрала 80,3 из 100 баллов за каркасные макеты решений, тогда как другая модель генерации изображений — 63,9. Amplitude оценивала ясность представления идей, соответствие продукту, соблюдение инструкций, читаемость текста и интерфейса, а также визуальную согласованность на примере 15 возможностей для улучшения.
Клиенты из разных отраслей уже используют бета-версию Wave, чтобы находить и внедрять улучшения продукта. Wave анализирует данные сеансов и аналитику, а затем формирует рекомендации с предлагаемым исправлением, техническим планом и критериями приёмки.
Далее команды сами выбирают уровень автоматизации. Большинство команд передают исправление ошибок прямо агентам программирования, а новые функции и более масштабные инициативы направляют на проверку людям.
Для изменений, которые доходят до запуска, путь от выявления возможности до реализации может быть коротким: среди запущенных клиентами экспериментов, флагов функций и руководств четверть стала доступна в тот же день, когда Wave выявил возможность, половина — менее чем за четыре дня, а две трети — в течение недели.
Интерполяция по предоставленным контрольным точкам; кривая приведена для наглядности и не отражает отдельные наблюдения.
«Вместе с OpenAI мы стремимся сделать самоулучшающиеся продукты стандартным подходом к разработке ПО в компаниях», — говорит Скейтс. По мере того как модели OpenAI совершенствуют способности к рассуждениям и программированию, команды смогут делегировать агентам больше работы по исследованию и реализации. В итоге более качественные продукты будут быстрее попадать к пользователям. Amplitude уже видит это на практике: агенты находят и помогают внедрять улучшения в её собственном продукте, пока команда занимается другими приоритетными задачами. «Думаю, команды удивятся тому, сколько они смогут сделать, когда их ПО будет работать вместе с ними над улучшением продукта».