Cum îmbunătățește Amplitude produse în 1–2 zile cu OpenAI
Bazat în principal pe modele OpenAI, Wave, agentul proactiv pentru produse al Amplitude, identifică ce trebuie dezvoltat, ajută echipele să lanseze modificări cu agenți de programare și măsoară impactul.
160%
Creșterea interacțiunii cu agentul față de grupul de control, după o zi
1–2 zile
Timp estimat pentru lansarea unei îmbunătățiri a produsului cu Wave
51%
Cost mediu al modelului mai mic per execuție pentru GPT‑6.1 Sol în evaluarea agentului de știința datelor realizată de Amplitude.
1,34 USD
Costul modelului GPT‑6.1 Sol în evaluarea investigatorului de oportunități realizată de Amplitude.
Amplitude a ajutat întotdeauna echipele să înțeleagă cum le folosesc oamenii produsele în realitate. Wave, agentul său proactiv pentru produse, ajută echipele să transforme aceste informații în îmbunătățiri lansate. Potrivit Amplitude, Wave se bazează în proporție de aproximativ 80% pe modele OpenAI, printre care GPT‑6.1 Sol, GPT‑6 Luna și GPT‑Image‑2.5 Flare. Wave transformă informațiile despre produs în planuri de implementare pe care echipele le pot trimite agenților de programare, inclusiv Codex, apoi măsoară impactul.
Amplitude estimează că Wave poate ajuta echipele să lanseze îmbunătățiri ale produselor în 1–2 zile, față de aproximativ o lună. Pe propria pagină principală a Amplitude, Wave a contribuit la personalizarea cardurilor cu sugestii, ceea ce a dus la o creștere de 160% a mesajelor trimise prin intermediul acestora.
„AI poate acum să găsească sarcini utile pe care nu ne-am gândit niciodată să i le atribuim. Modelele OpenAI pot să investigheze o problemă, să scrie și să ruleze cod și să folosească rezultatele pentru a decide ce să încerce în continuare.”
Wave este agentul proactiv pentru produse al Amplitude. Echipele îi indică o zonă a produsului, obiectivele urmărite și indicatorii pe care vor să îi îmbunătățească. Wave reunește date din Amplitude, înregistrări ale sesiunilor, feedback de la clienți și cod pentru a identifica și prioritiza oportunități, a dezvolta soluții și a coordona implementarea cu oamenii și agenții de programare. Apoi urmărește rezultatele și folosește lecțiile învățate pentru a orienta următoarea rundă de îmbunătățiri.
În spatele acestui flux de lucru, Amplitude folosește modele OpenAI diferite pentru sarcini diferite. GPT‑6.1 Sol susține componenta de gestionare a oportunităților și investigațiile aprofundate ale codului și datelor. GPT‑6 Luna gestionează sarcini frecvente, cu costuri mai mici, precum scanarea codului și efectuarea unor verificări de evaluare punctuale. GPT‑Image‑2.5 Flare generează machete de produs folosind capturi de ecran din înregistrările sesiunilor ca referințe vizuale.
Când o oportunitate este pregătită pentru implementare, echipele o pot trimite direct din Wave către agenți de programare, inclusiv Codex, împreună cu un plan tehnic și criterii de acceptare care să ghideze implementarea.
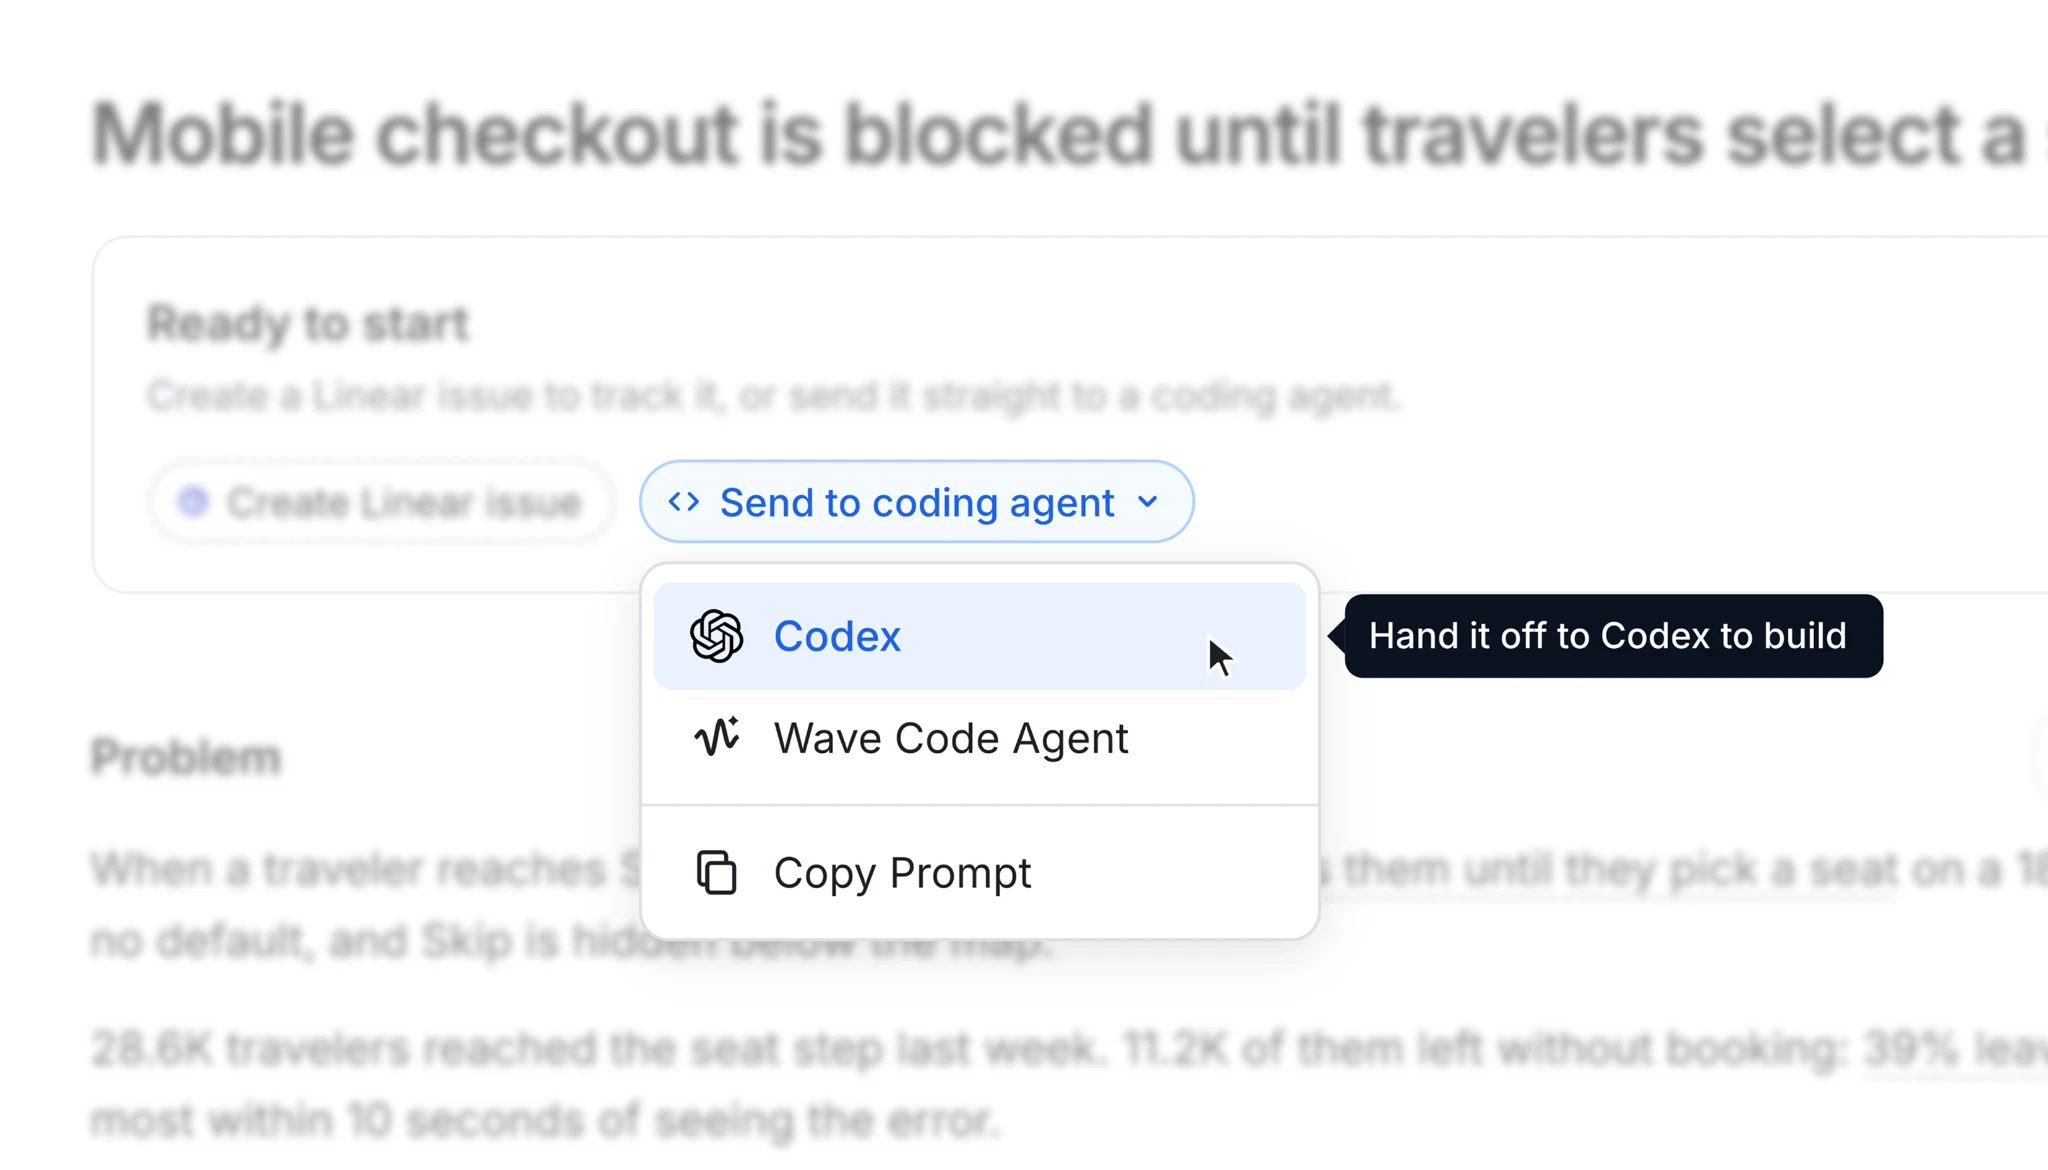
„Ideea din spatele Wave este să ai o platformă unificată, cu agenți care analizează în detaliu volume uriașe de înregistrări ale sesiunilor, date analitice și cod pentru a găsi oportunități de îmbunătățire a produselor”, explică Jacob Newman, manager principal de produs AI la Amplitude.
Amplitude a testat Wave pe propria pagină principală, unde cardurile cu sugestii generice aveau rolul de a ajuta utilizatorii să înceapă o conversație cu un agent AI. Wave a descoperit că oamenii le ignorau adesea: într-un eșantion de 100 de înregistrări ale sesiunilor, 80 de utilizatori și-au tastat propriile întrebări și doar 12 au selectat o sugestie.
Wave a propus personalizarea cardurilor pe baza graficelor și a tablourilor de bord recente sau a paginii de pe care venise utilizatorul. A ilustrat modificarea și a elaborat un plan tehnic, care prevedea inclusiv păstrarea posibilității de a tasta liber și afișarea sugestiilor generice când nu era disponibil contextul necesar personalizării. După o scurtă analiză, echipa a încredințat sarcina unui agent de programare și a efectuat un test A/B al modificării.
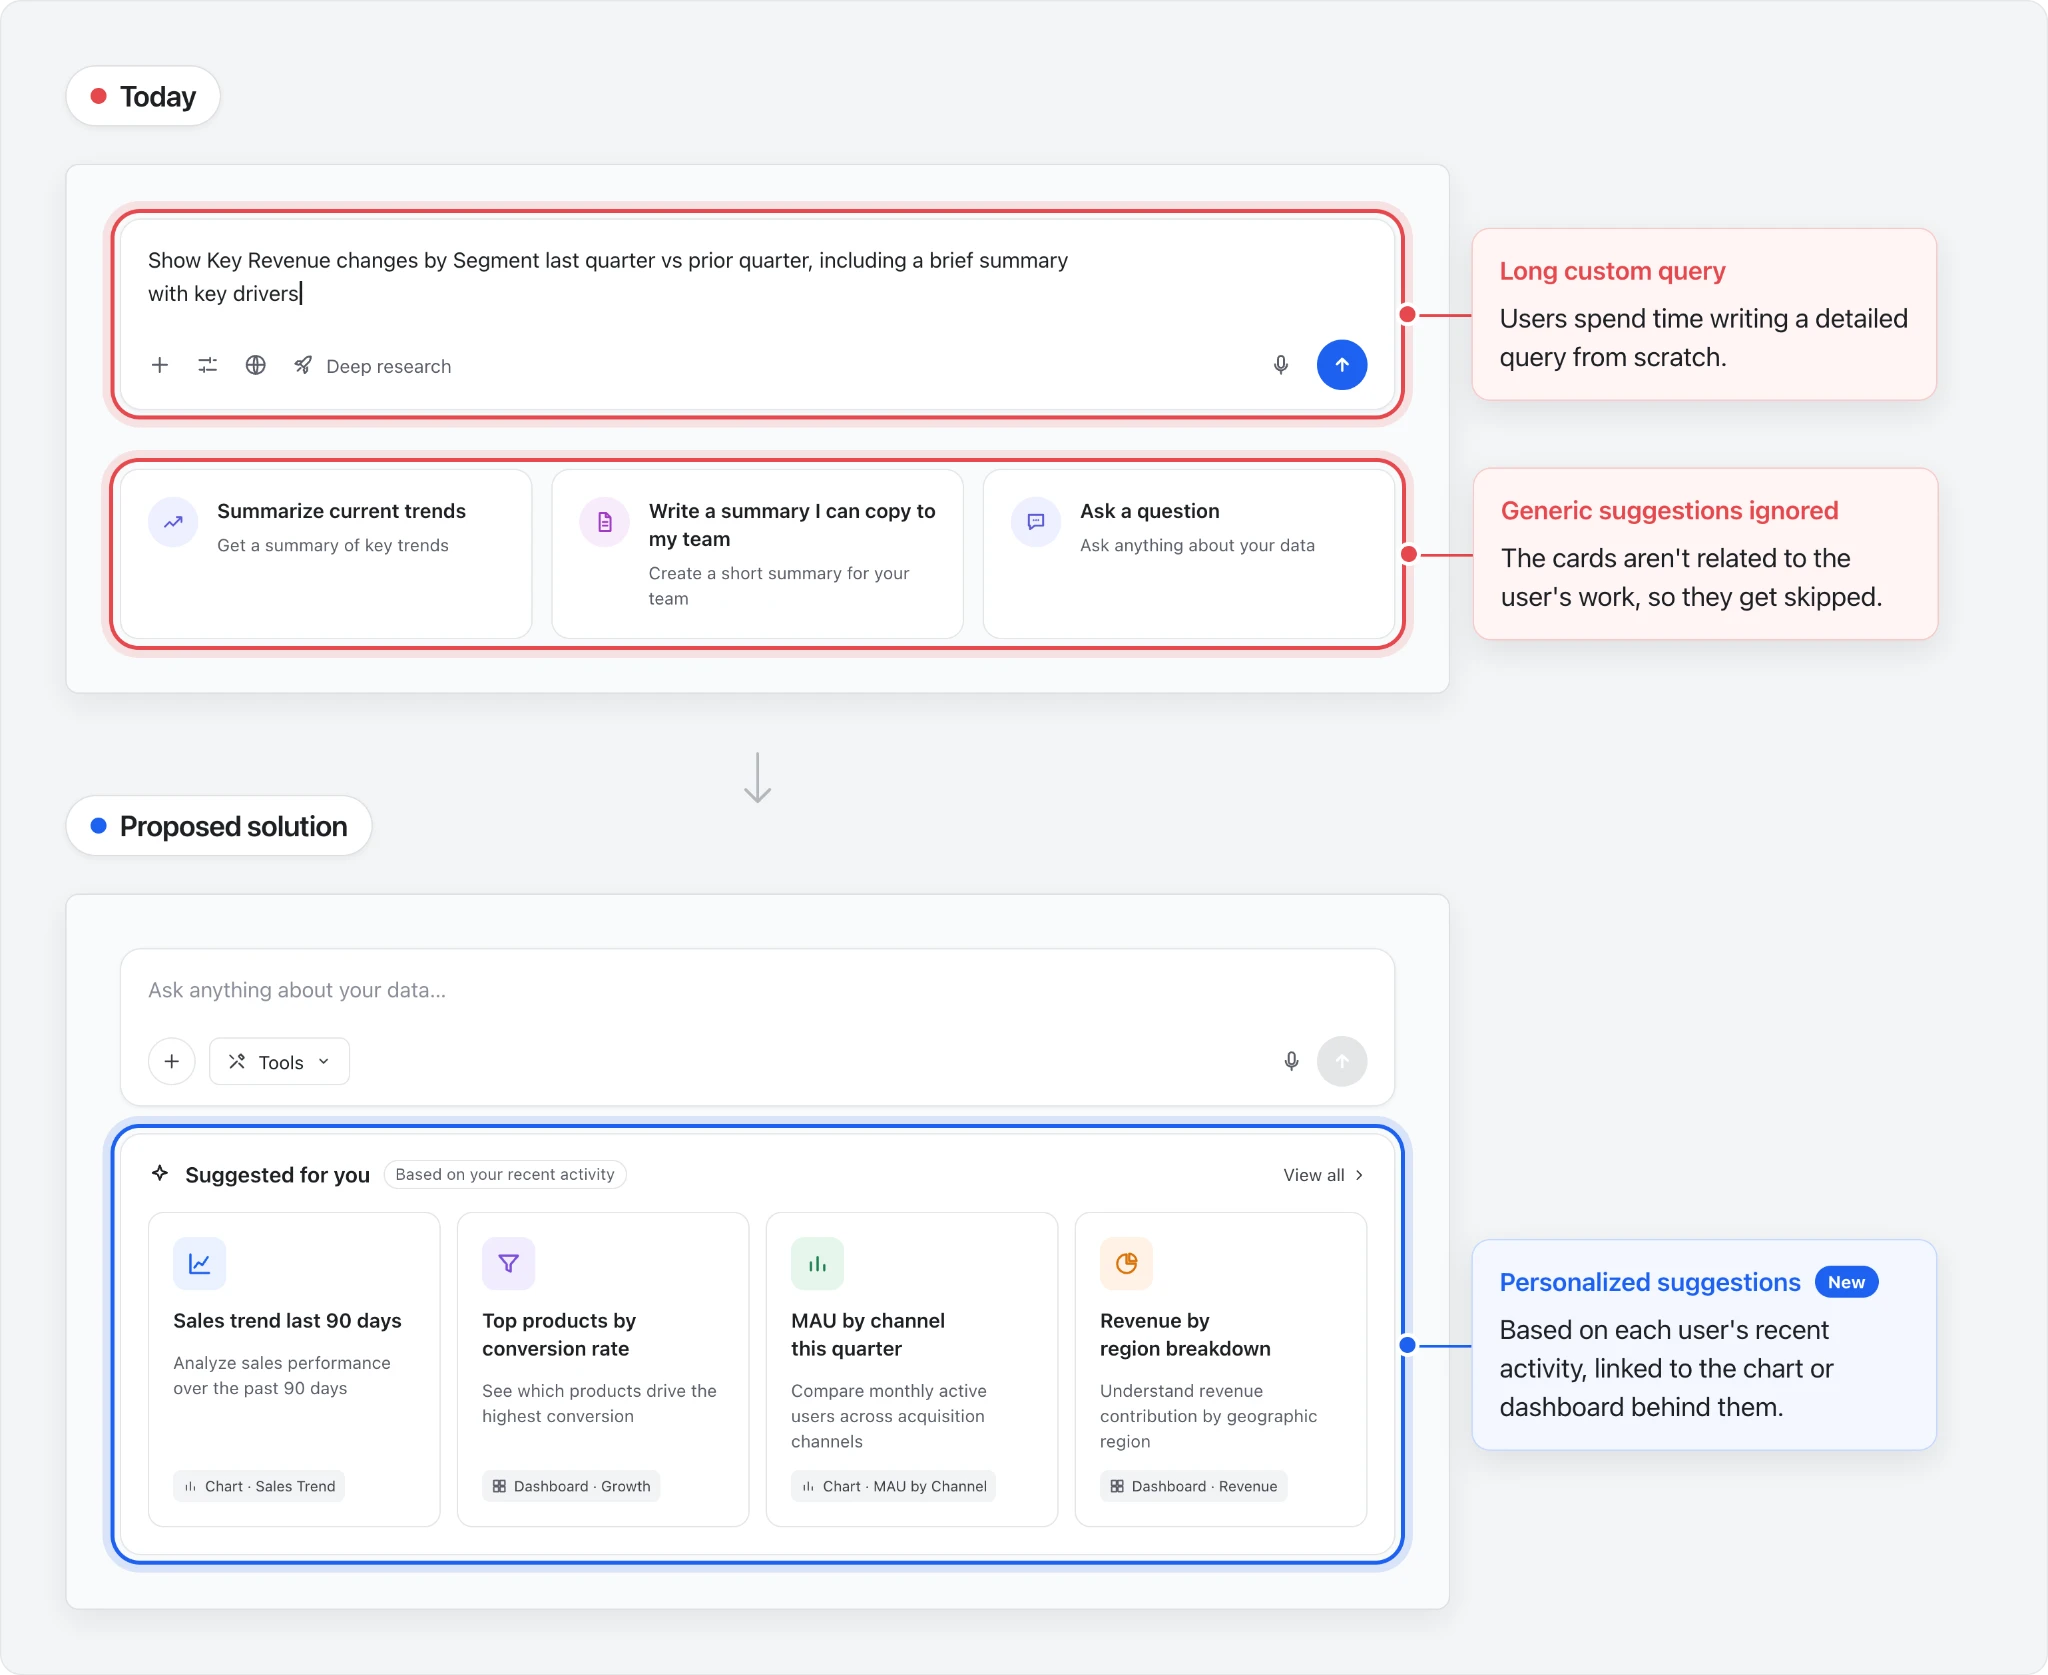
Potrivit rezultatelor experimentului comunicate de Amplitude, numărul mesajelor trimise prin cardurile cu sugestii de pe pagina principală a crescut cu 160% față de grupul de control, după o zi. „Este un exemplu excelent al modului în care lucruri deloc revoluționare, care sunt pur și simplu trecute cu vederea, pot crește utilizarea funcționalităților în moduri neașteptate”, explică Eric Carlson, inginer principal senior în AI la Amplitude.
Sarcinile Wave impun cerințe diferite modelelor sale. O investigație aprofundată necesită un raţionament solid și concluzii bine susținute. O verificare punctuală repetată de sute de ori trebuie să fie rapidă și ieftină. Amplitude evaluează calitatea, latența și costul pentru fiecare sarcină, apoi alocă modelele în consecință.
„OpenAI ne-a oferit atât modele cu capacități solide de raţionament, cât și modele mai mici și mai rapide, astfel încât am putut echilibra calitatea, latența și costul inferenței la nivelul întregului produs”
Pentru investigatorul de oportunități din Wave, Amplitude a evaluat dacă modelele confirmau constatările prin dovezi suplimentare, evitau rezultatele fals pozitive, integrau feedbackul evaluatorului, se redresau după erori ale instrumentelor și mențineau afirmațiile în concordanță cu dovezile. GPT‑6.1 Sol a obținut un scor general de 4,06 din 5, față de 3,62, 3,52 și 2,94 pentru trei modele alternative. A ocupat primul loc la toate cele cinci criterii de investigare și a avut cea mai scurtă durată mediană a investigației: 54 de minute.
Într-o evaluare separată a agentului de știința datelor din Wave, GPT‑6.1 Sol a obținut un scor de 67,5 din 100, față de 69,3 pentru un alt model de top, la un cost mediu al modelului de 1,28 USD, față de 2,63 USD per execuție. GPT‑6.1 Sol a obținut scoruri mai mari și pentru respectarea contractelor de utilizare a instrumentelor, estimare și incertitudine, precum și pentru folosirea dovezilor ca temei.
Pentru sarcinile cu volum mare, precum scanarea codului și efectuarea unor verificări de evaluare punctuale, Amplitude folosește GPT‑6 Luna pentru a menține latența și costurile scăzute. Distribuirea muncii între agenți specializați permite echipei să rezerve capacitățile de raţionament mai costisitoare pentru sarcinile care au cea mai mare nevoie de ele.
La generarea de schițe și machete, modelul OpenAI de generare de imagini a obținut un scor de 80,3 din 100 pentru schițele soluțiilor, față de 63,9 pentru un alt model de generare de imagini. Evaluarea Amplitude a vizat calitatea comunicării, fidelitatea față de produs, respectarea instrucțiunilor, lizibilitatea textului și a interfeței și coerența vizuală, pentru 15 oportunități.
Clienți din diverse industrii folosesc deja Wave în versiune beta pentru a identifica și a lansa îmbunătățiri ale produselor. Wave analizează datele sesiunilor și datele analitice, apoi elaborează recomandări însoțite de o soluție propusă, un plan tehnic și criterii de acceptare.
Din acel punct, echipele pot controla nivelul de automatizare. Majoritatea echipelor trimit remedierea erorilor direct către agenții de programare, în timp ce funcționalitățile noi și inițiativele mai ambițioase sunt analizate de oameni.
Pentru modificările care ajung să fie lansate, drumul de la descoperire la execuție poate fi scurt: dintre experimentele, indicatoarele de funcționalități și ghidurile lansate de clienți, unul din patru a fost lansat în aceeași zi în care Wave a identificat oportunitatea, jumătate în mai puțin de patru zile și două din trei în decurs de o săptămână.
Interpolare pe baza reperelor furnizate; curba este ilustrativă și nu reprezintă observații individuale.
„Ambiția noastră, alături de OpenAI, este ca produsele care se îmbunătățesc singure să devină modul obișnuit în care companiile dezvoltă software”, spune Skates. Pe măsură ce modelele OpenAI își îmbunătățesc capacitățile de raţionament și programare, echipele vor putea delega agenților mai multe sarcini de investigare și implementare, astfel încât produse mai bune să ajungă mai repede la utilizatori. Amplitude vede deja acest lucru: agenții identifică și ajută la implementarea îmbunătățirilor propriului produs, în timp ce echipa se ocupă de alte priorități. „Cred că echipele vor fi surprinse de câte pot realiza atunci când software-ul lor lucrează alături de ele pentru a îmbunătăți produsul.”