Nauka rozumowania z użyciem modeli LLM
Przedstawiamy OpenAI o1 — nowy duży model językowy wytrenowany metodą uczenia przez wzmacnianie. o1 przed udzieleniem odpowiedzi na pytanie użytkownika przeprowadza złożone rozumowanie. Zanim odpowie, myśli i może stworzyć długi wewnętrzny łańcuch myśli.
Model o1 firmy OpenAI plasuje się na 89. percentylu w pytaniach z zawodów w programowaniu (Codeforces), plasuje się wśród 500 najlepszych uczniów w USA w kwalifikacjach do Olimpiady Matematycznej w USA (AIME) i przewyższa poziom dokładności człowieka wymagany na poziomie doktoratu w testach rozwiązywania problemów z zakresu fizyki, biologii i chemii (GPQA). Chociaż wciąż trwają prace nad zapewnieniem tak łatwego korzystania z tego modelu, jak w przypadku obecnych modeli, udostępniamy jego wczesną wersję, OpenAI o1‑preview. Już teraz mogą z niej korzystać użytkownicy ChatGPT i korzystający z interfejsów API (zaufani użytkownicy)(otwiera nowe okno).
Nasz algorytm uczenia przez wzmacnianie na dużą skalę uczy model skutecznego myślenia przy użyciu łańcucha myśli, stosując proces trenowania wymagający małej ilości danych. Odkryliśmy, że wyniki modelu o1 stale poprawiają się wraz z rosnącym zakresem zastosowania uczenia przez wzmacnianie (nakład obliczeniowy dla treningu), a także wraz z dłuższym czasem myślenia (nakład obliczeniowy dla testów). Ograniczenia dotyczące skalowania tego podejścia znacznie różnią się od ograniczeń dotyczących wstępnego trenowania modeli LLM i nadal je badamy.
Wyniki o1 płynnie rosną wraz z nakładem obliczeniowym dla treningu i testów
Aby uwydatnić poprawę rozumowania w stosunku do modelu GPT‑4o, przetestowaliśmy nasze modele przy użyciu zestawu różnych egzaminów dla ludzi i testów porównawczych ML. Wykazaliśmy, że model o1 znacznie przewyższa GPT‑4o w większości zadań wymagających intensywnego rozumowania. O ile nie określono inaczej, ocenę modelu o1 przeprowadziliśmy przy ustawieniu maksymalnego nakładu obliczeniowego dla testów.
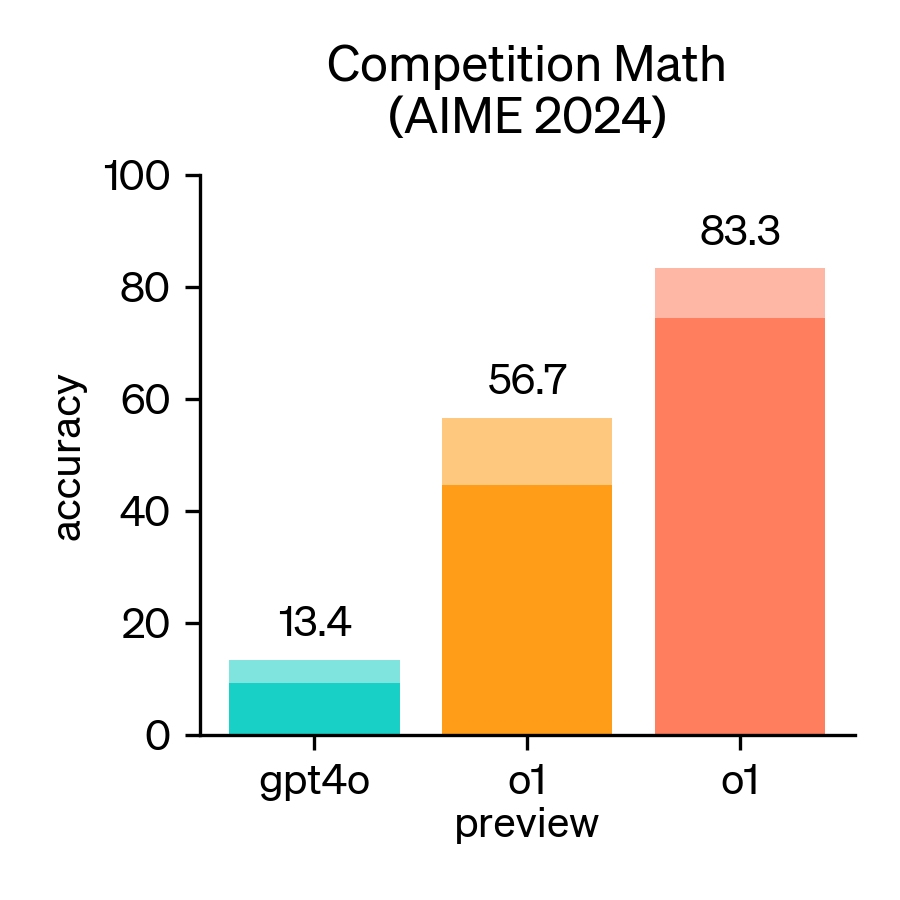
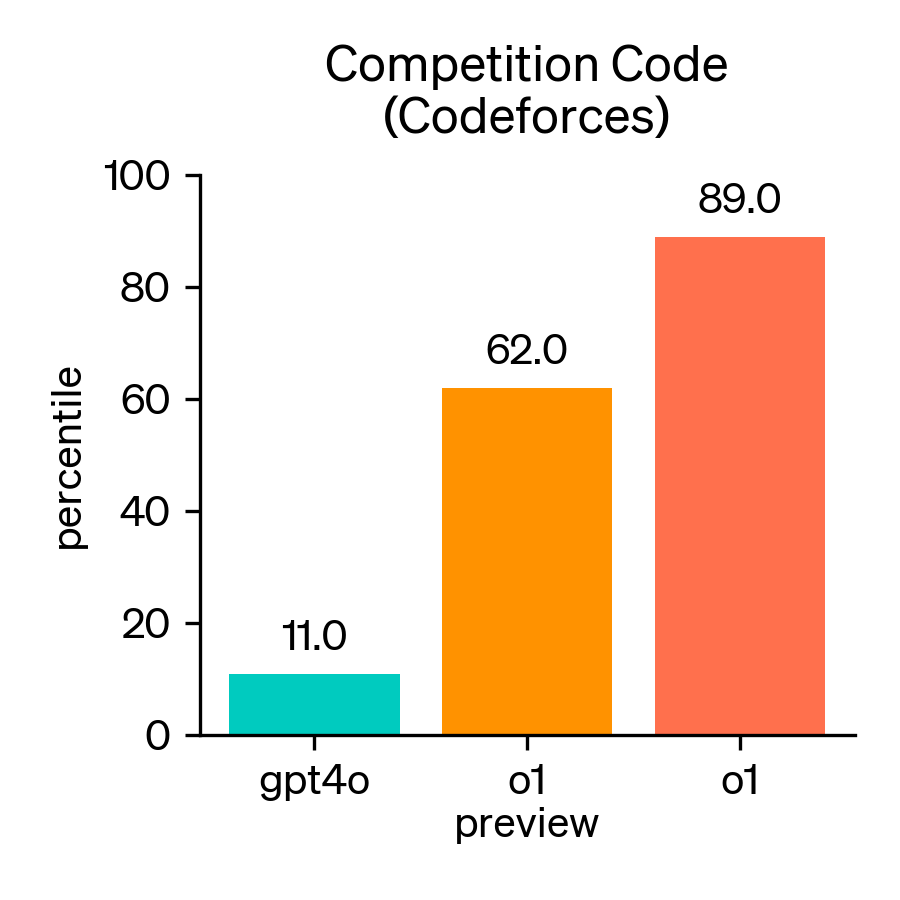
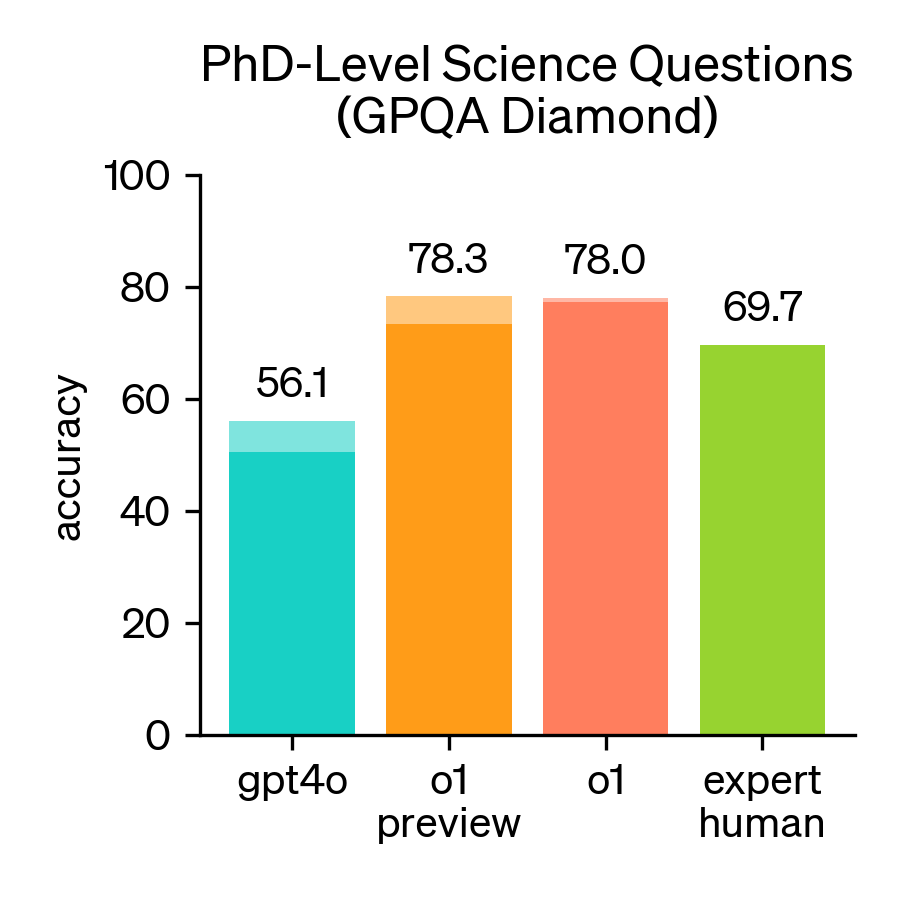
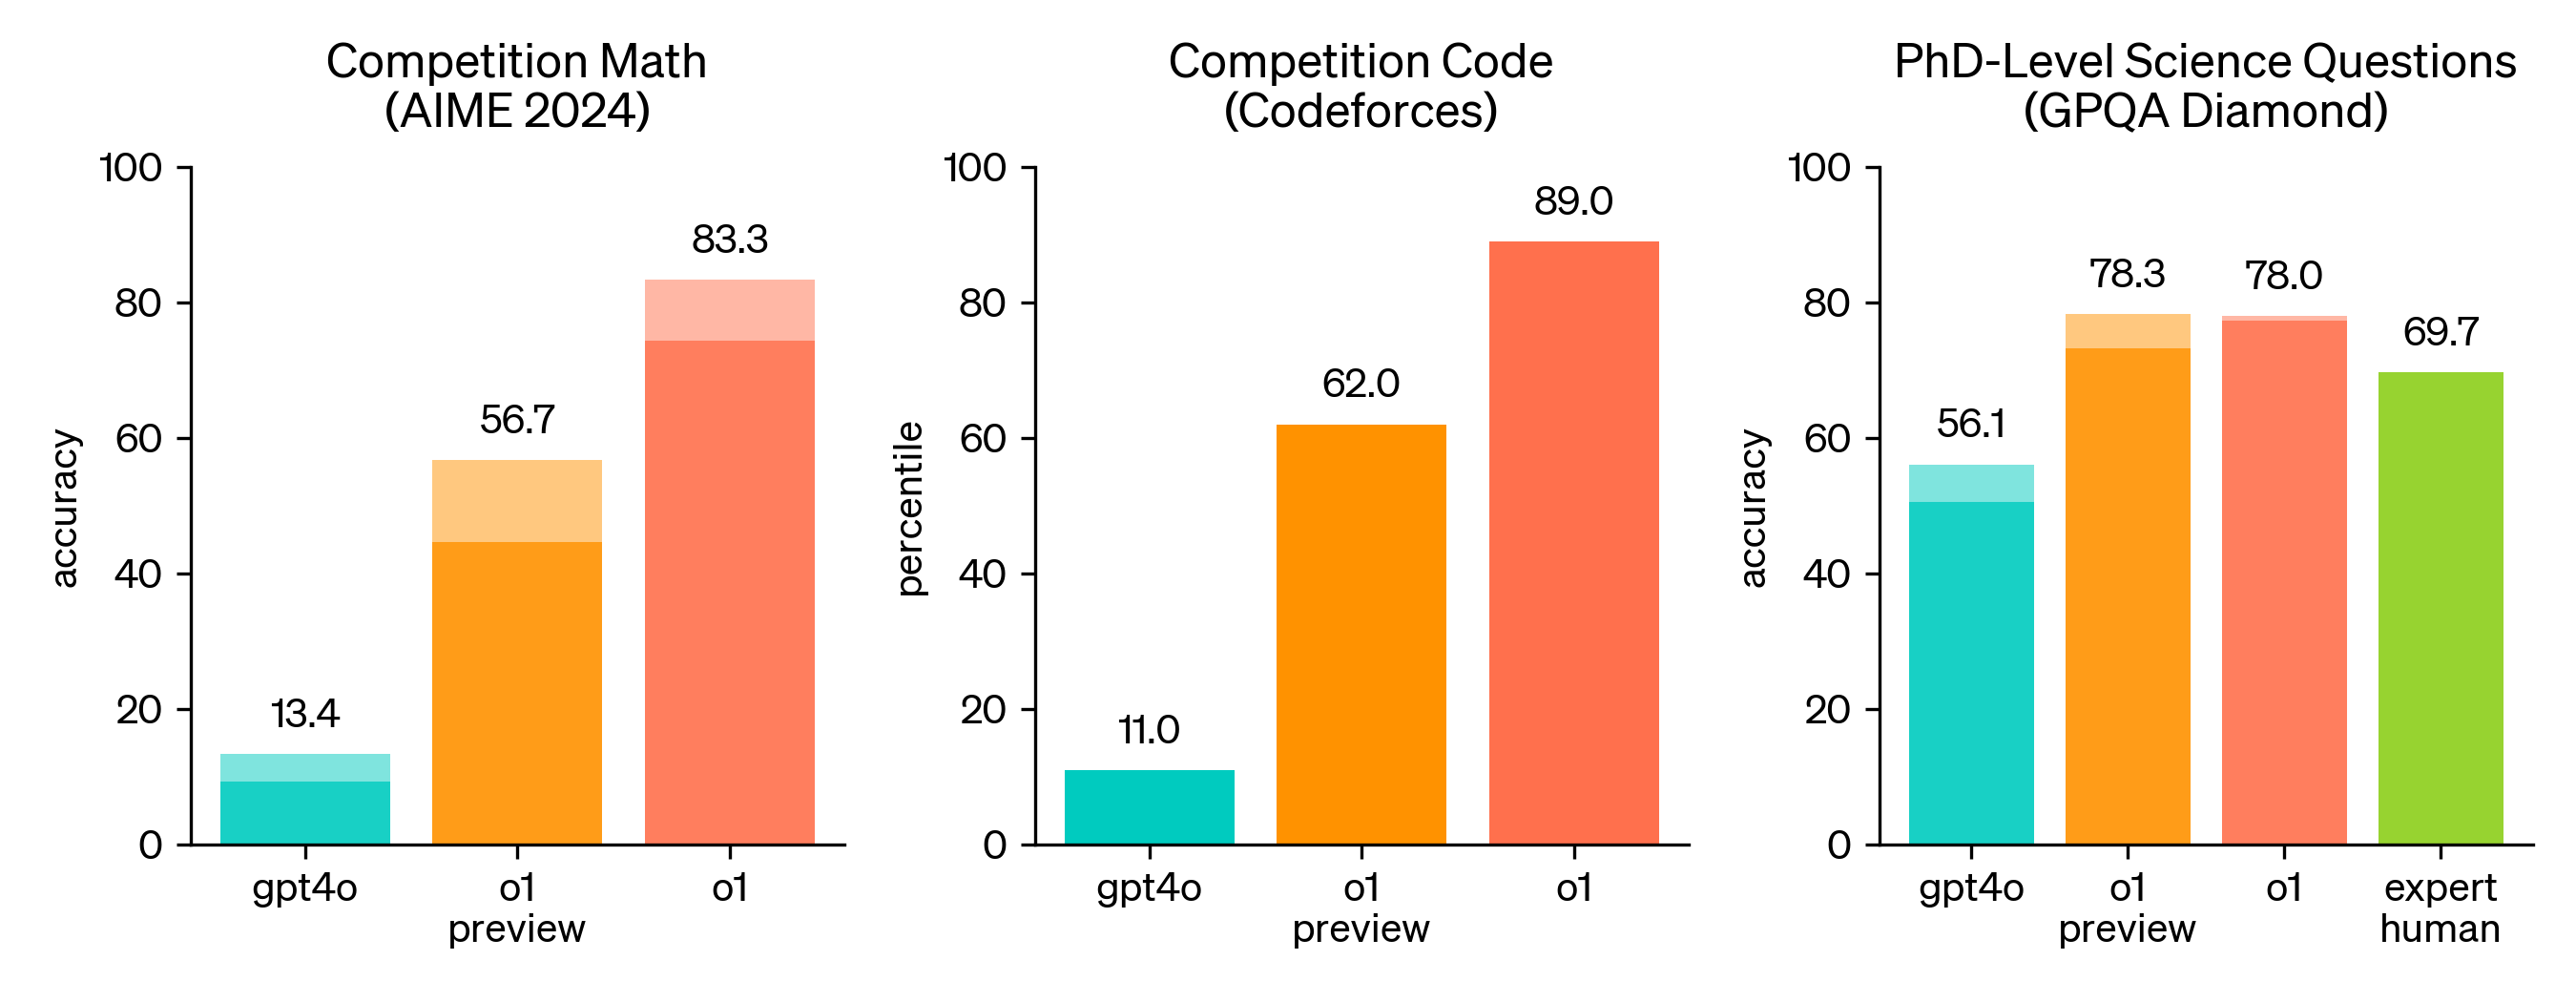
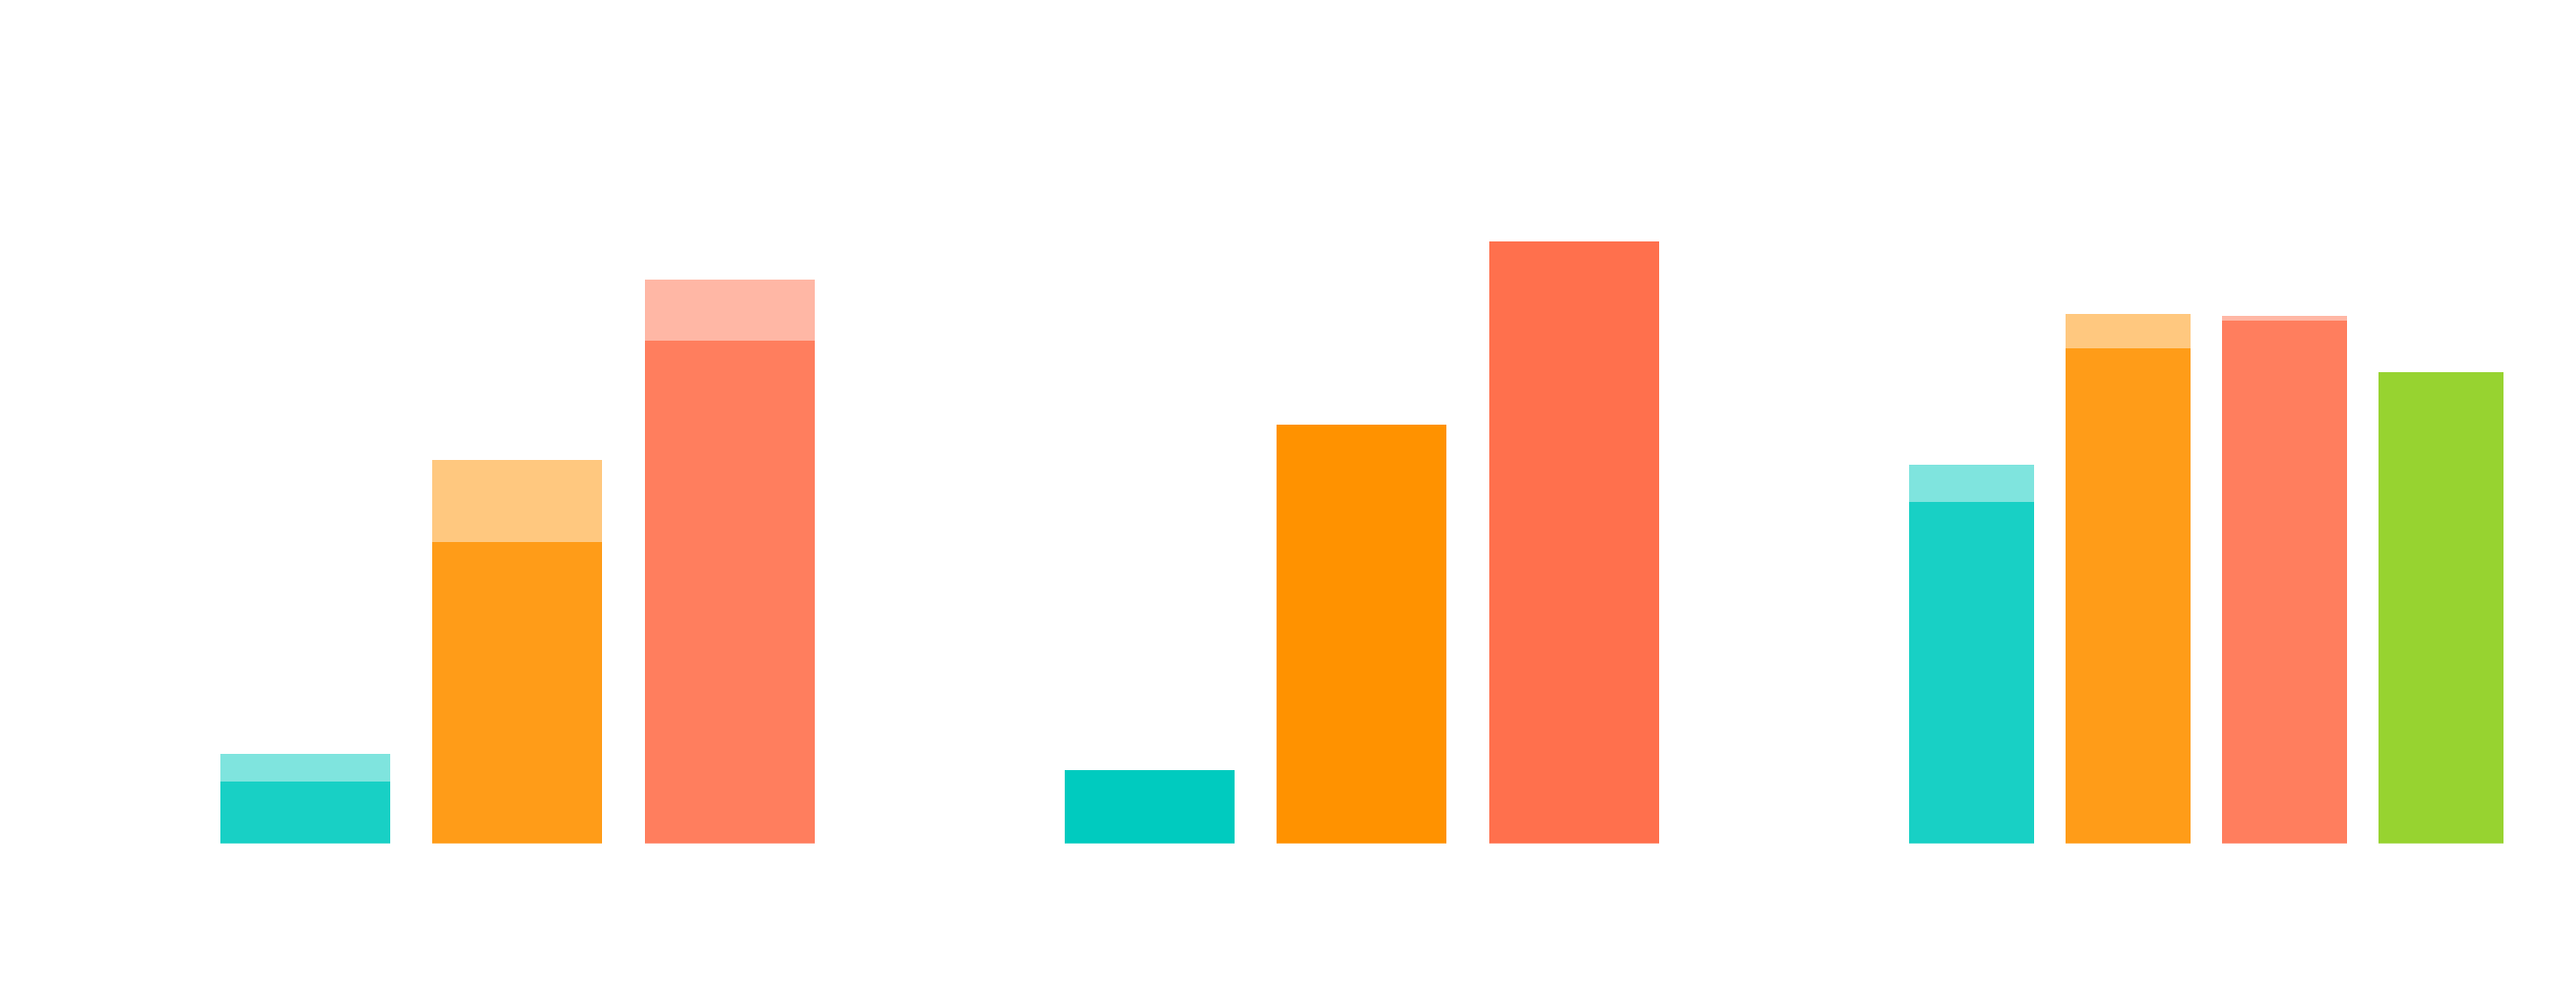
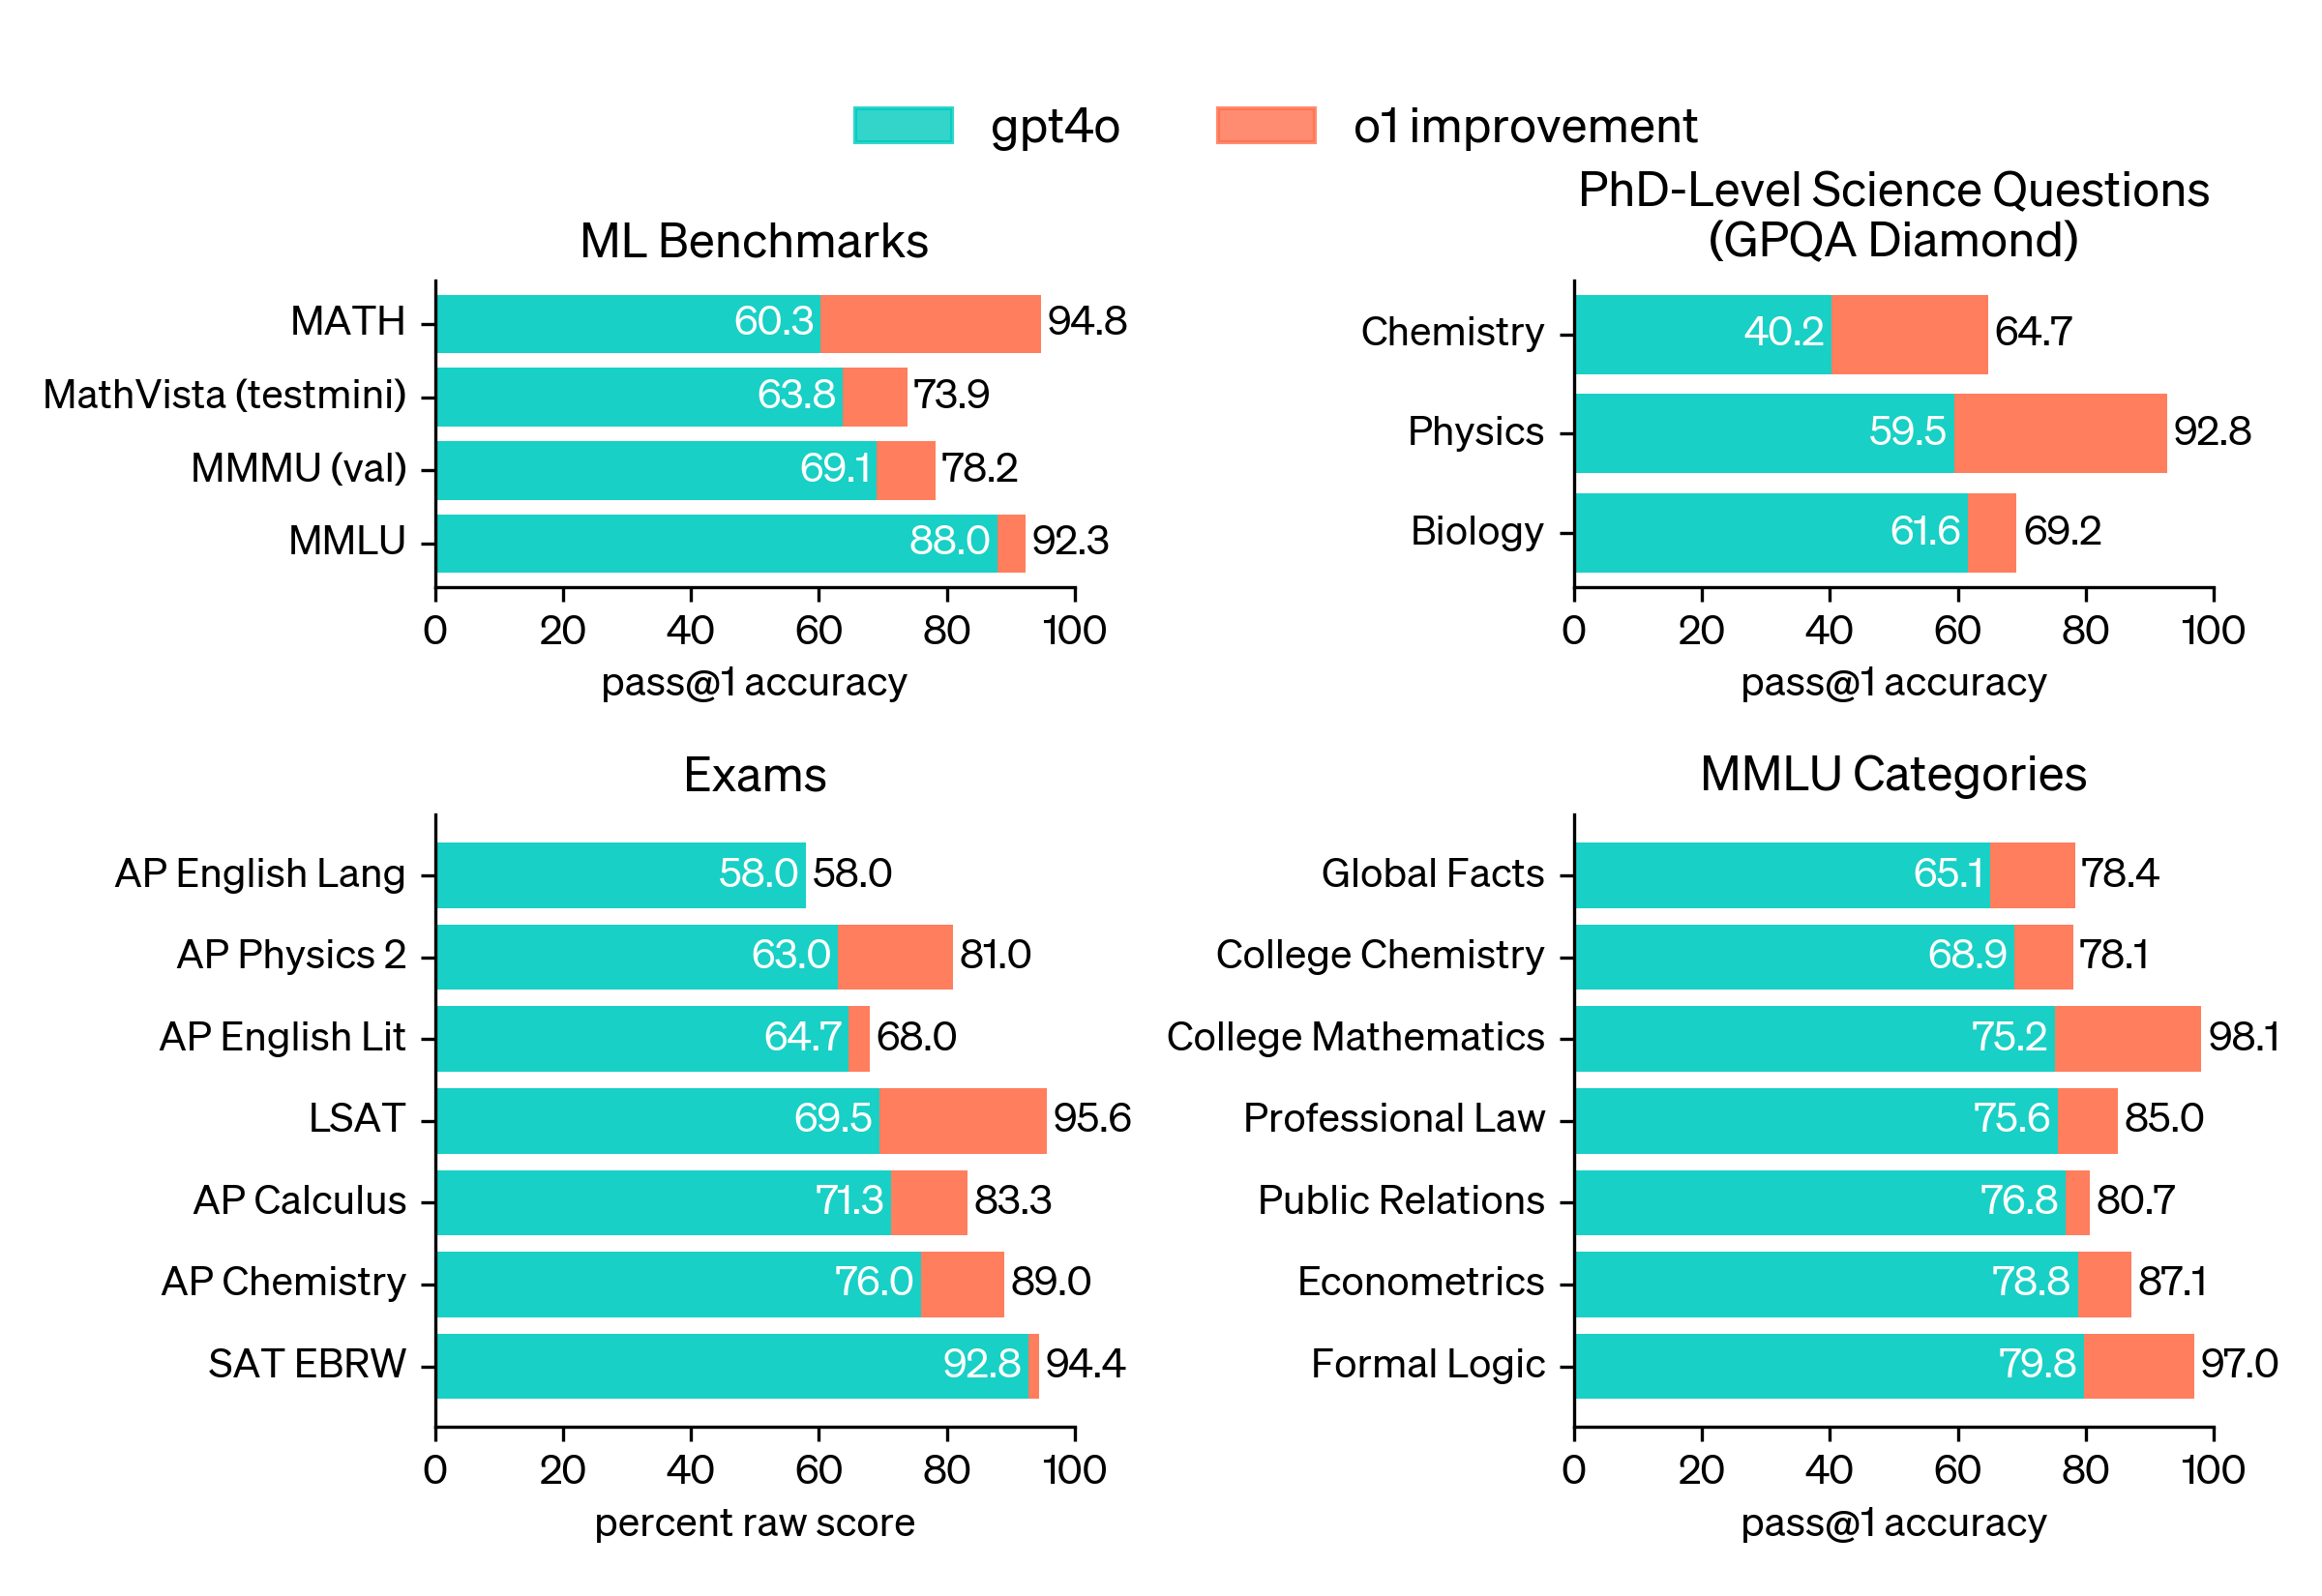
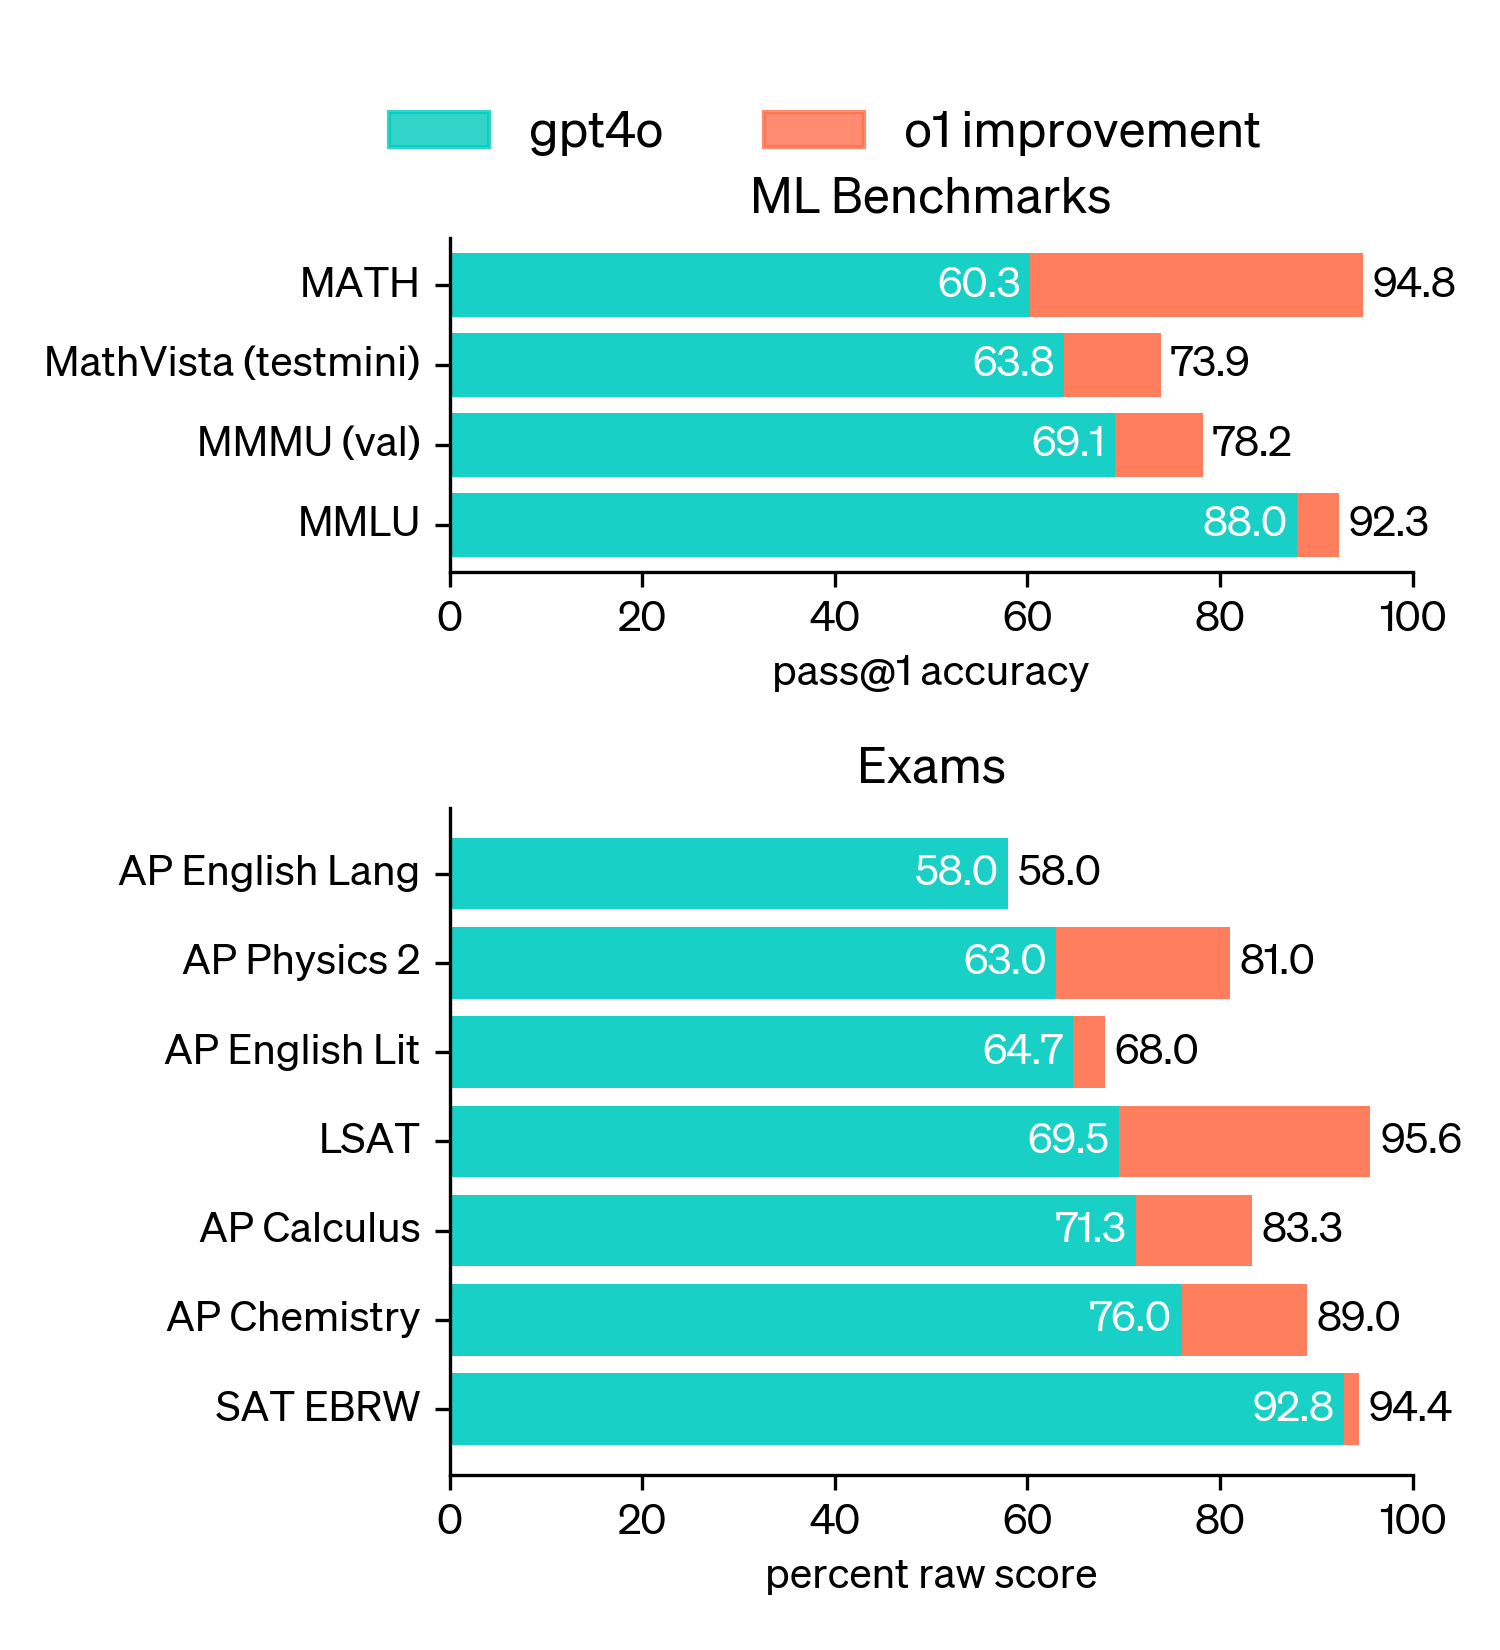
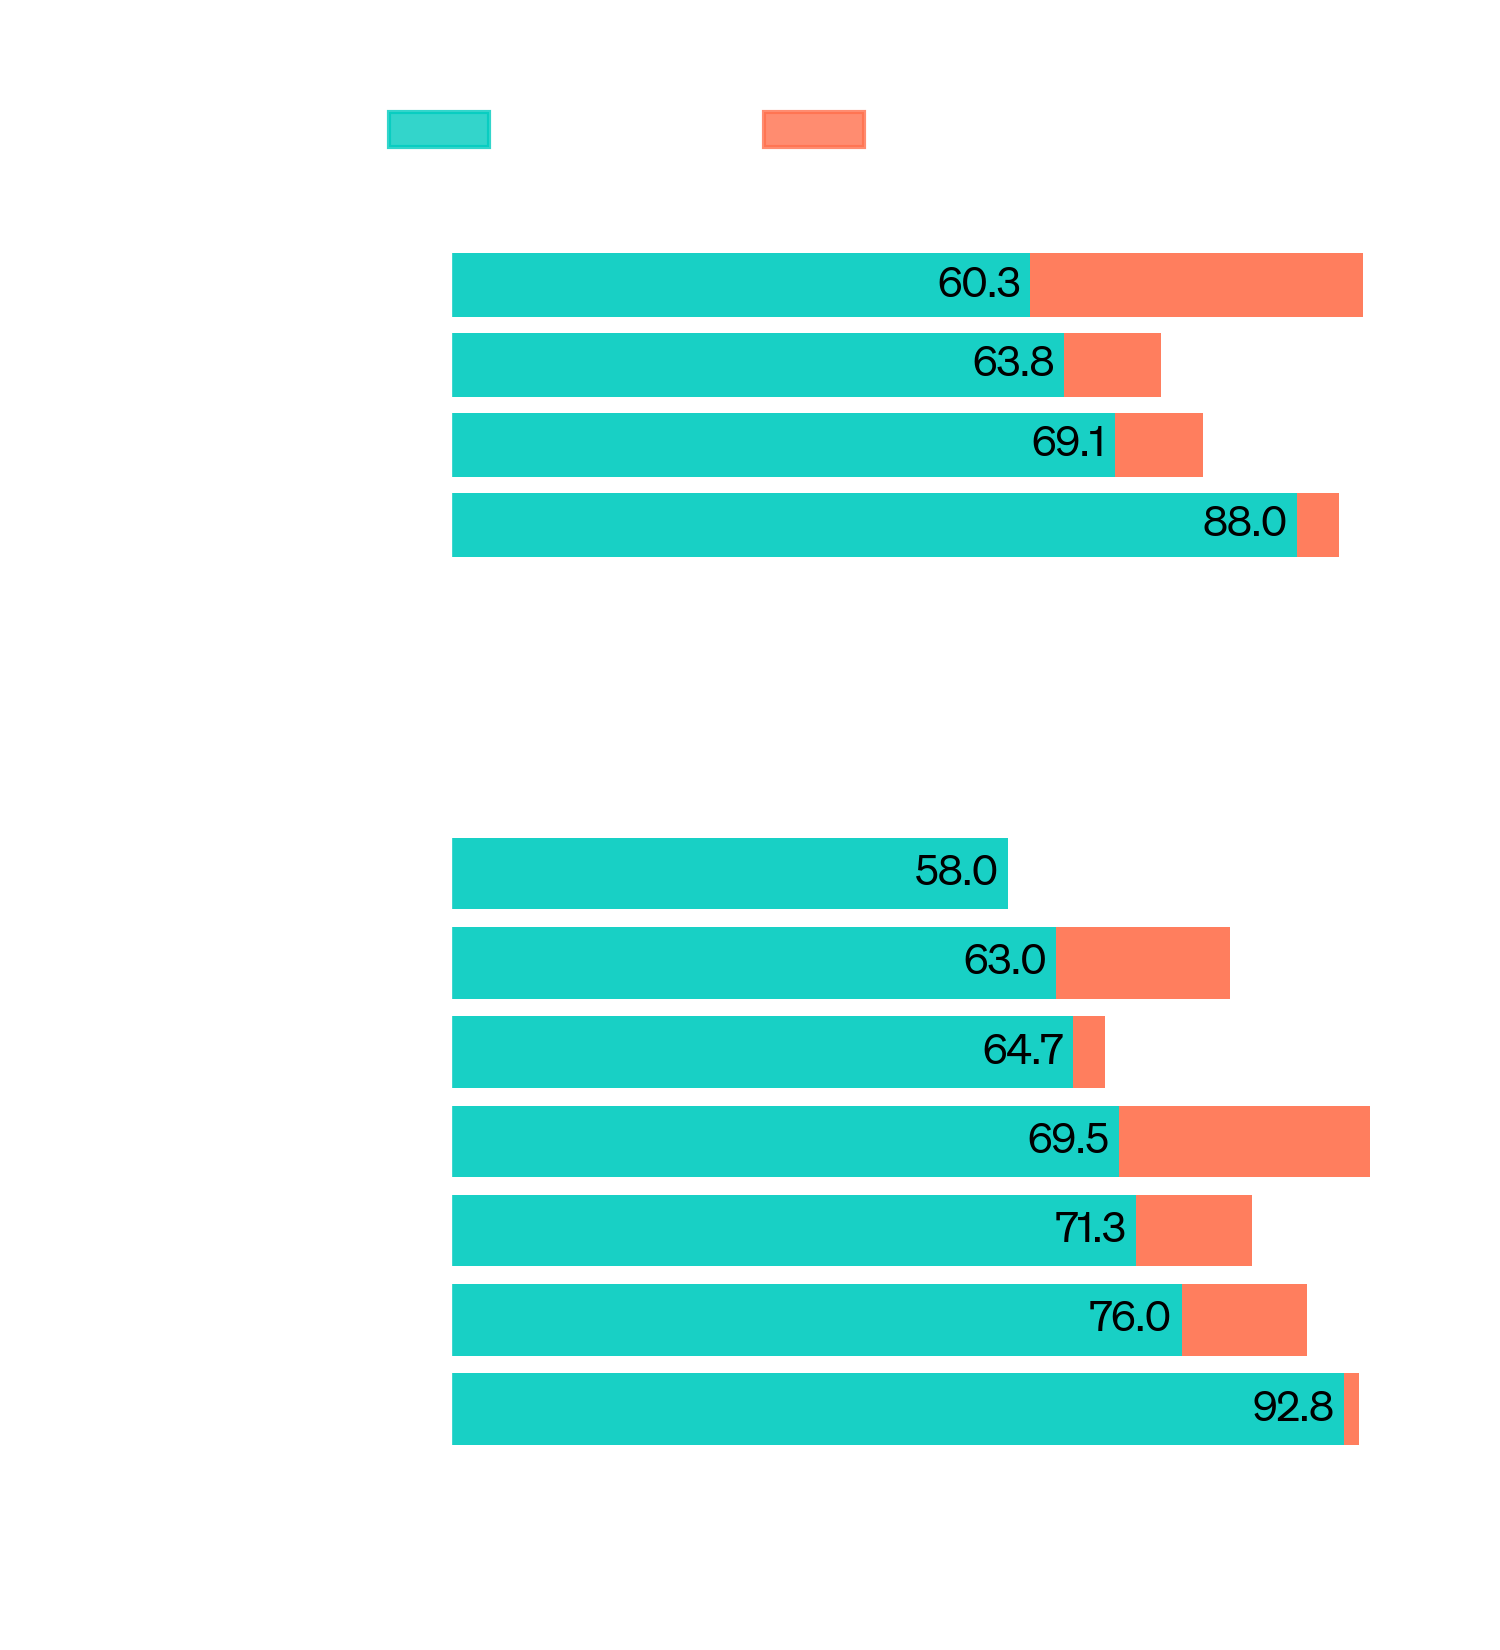
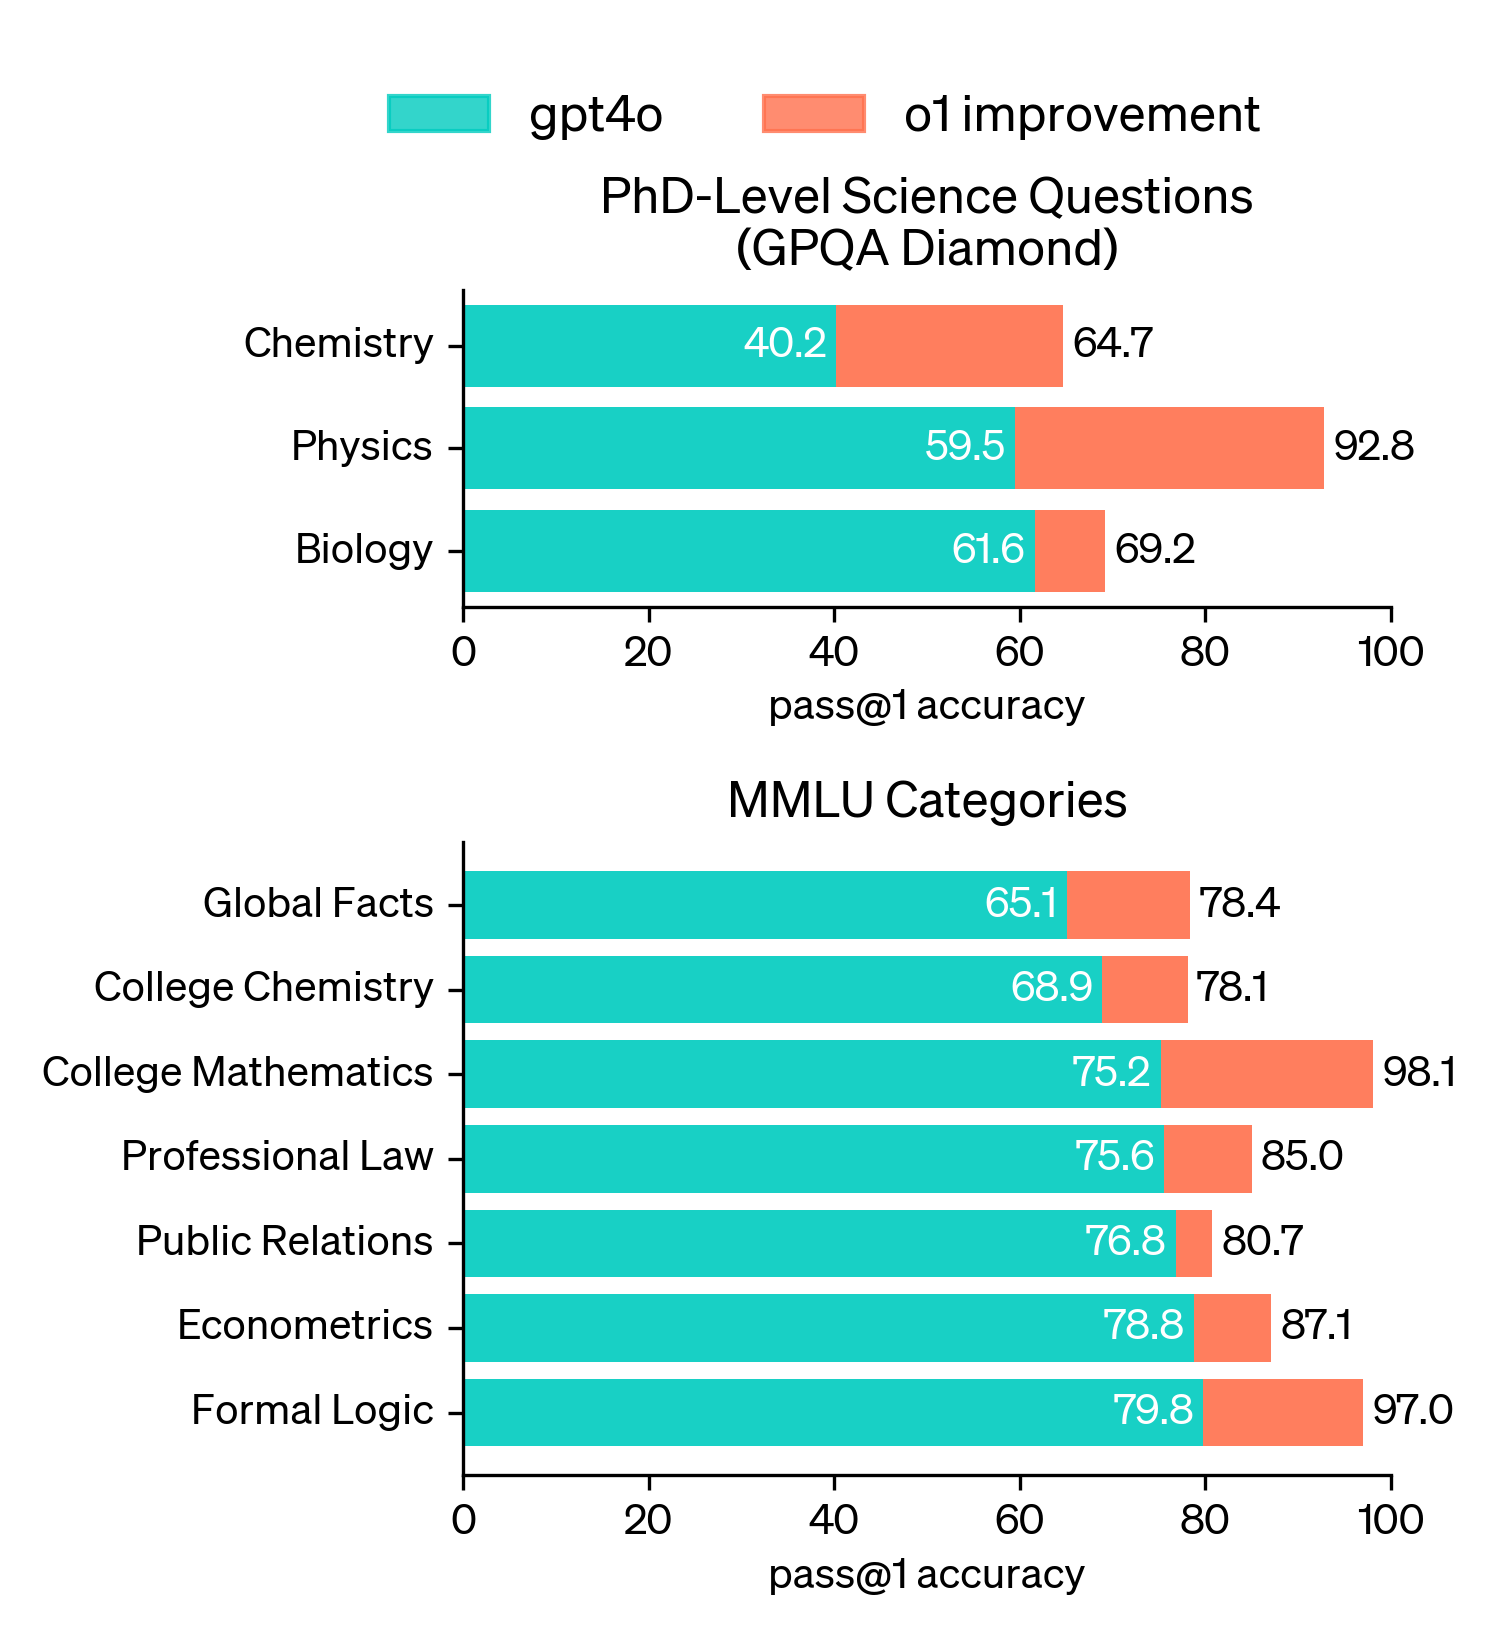
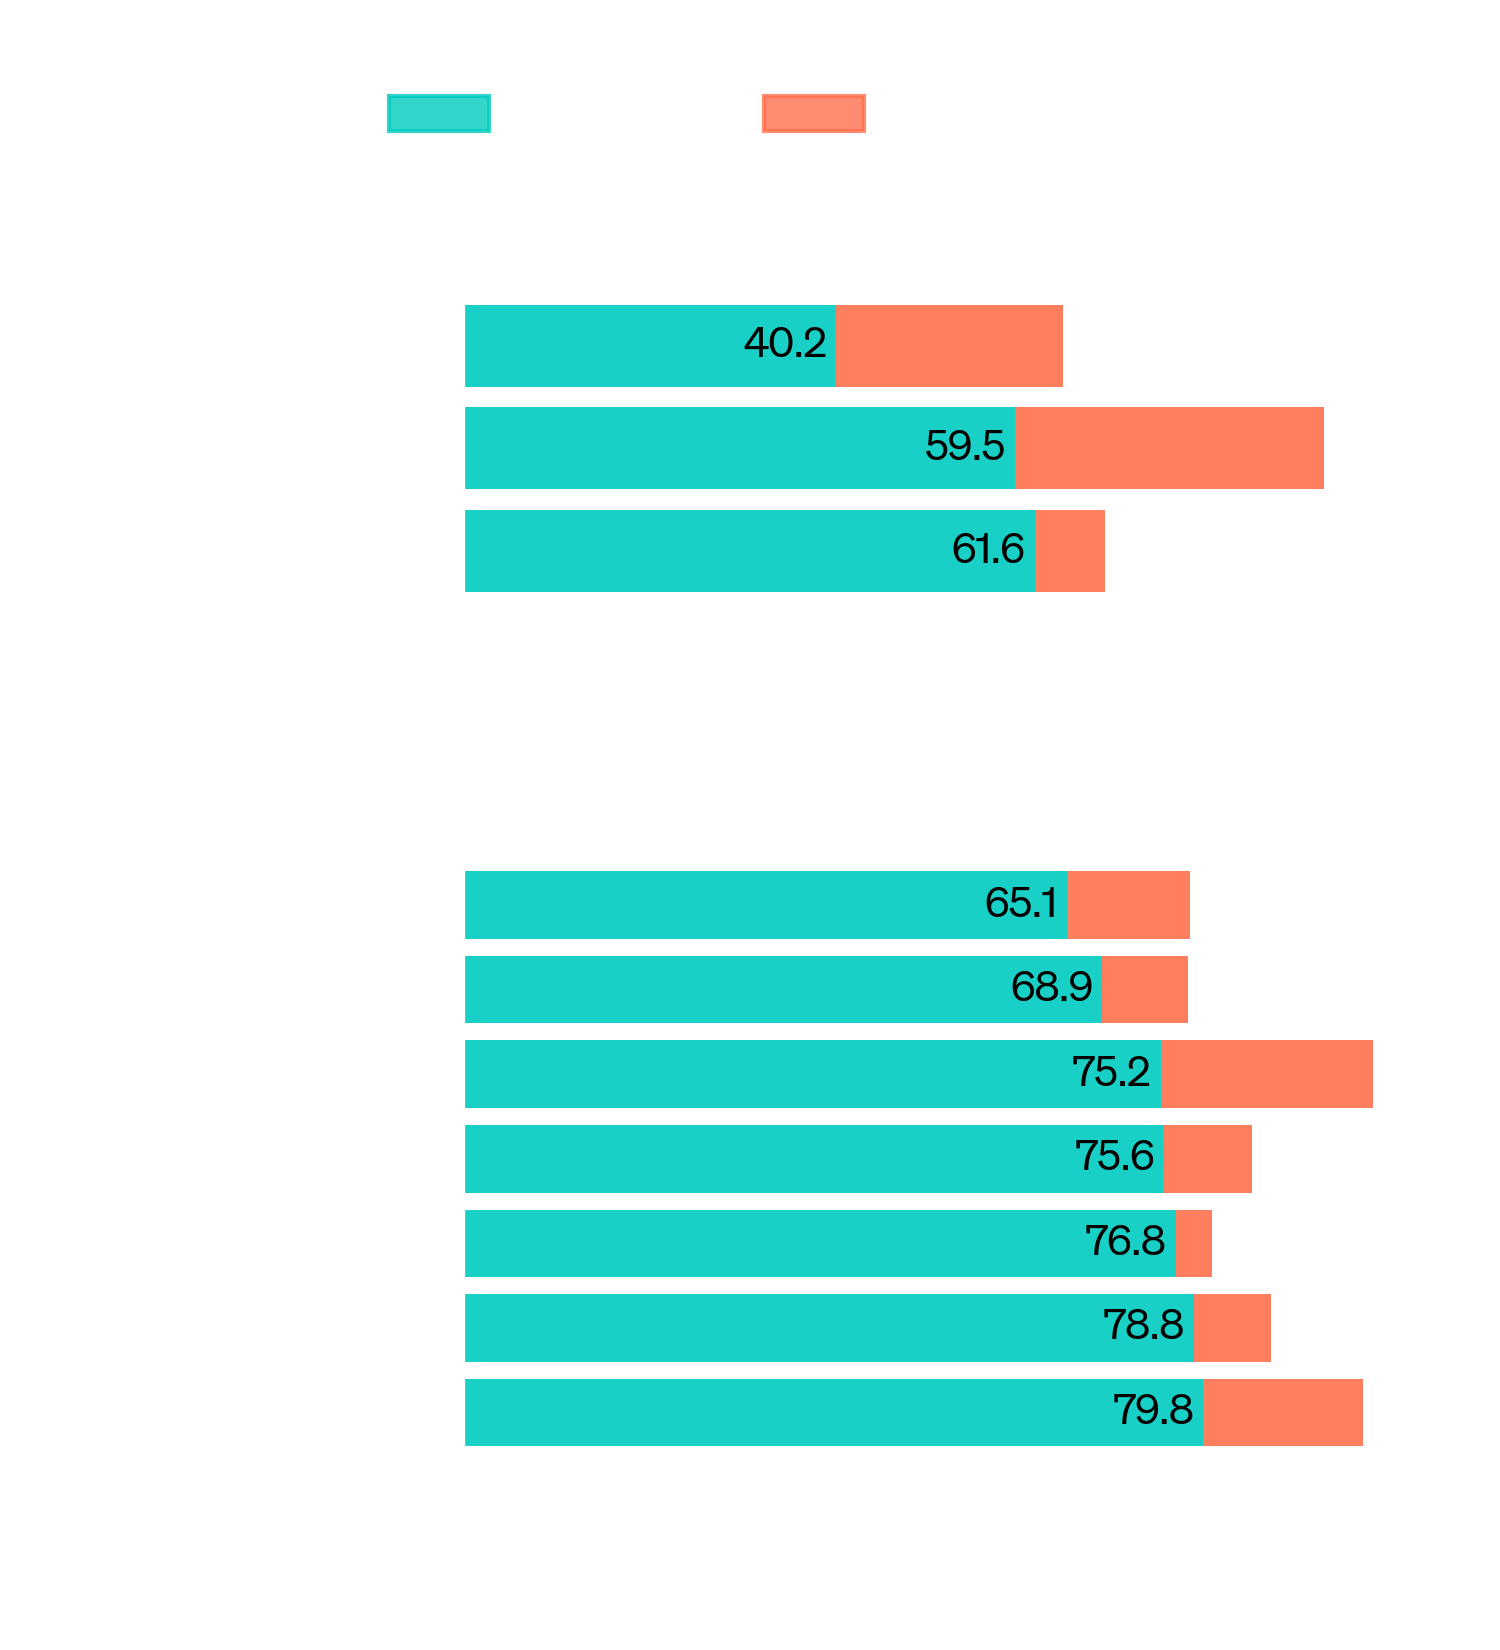
W wielu testach porównawczych wymagających intensywnego rozumowania model o1 dorównuje w wynikach ludziom będącym ekspertami. Najnowsze pionierskie modele1 osiągają tak dobre wyniki w testach MATH2 i GSM8K, że testy porównawcze nie umożliwiają już odróżnienia modeli. Oceny dotyczące matematyki przeprowadziliśmy przy użyciu egzaminu AIME przeznaczonego dla najzdolniejszych uczniów szkół średnich w Ameryce. W egzaminach AIME 2024 model GPT‑4o rozwiązał średnio tylko 12% (1,8/15) problemów. Model o1 miał średnią 74% (11,1/15) przy jednej próbce na problem, 83% (12,5/15) przy konsensusie 64 próbek i 93% (13,9/15) przy ponownym rankingu 1000 próbek przy użyciu wytrenowanej funkcji punktacji. Wynik 13,9 plasuje go wśród 500 najlepszych uczniów w kraju i powyżej progu kwalifikacyjnego do Olimpiady Matematycznej w USA.
Przeprowadziliśmy również ocenę o1 przy użyciu GPQA diamond, trudnego testu porównawczego sprawdzającego wiedzę z zakresu chemii, fizyki i biologii. Aby porównać modele z ludźmi, zatrudniliśmy ekspertów z tytułem doktora, którzy odpowiadali na pytania z testu GPQA-diamond. Odkryliśmy, że o1 miał lepsze wyniki od tych ekspertów. To pierwszy model, który osiągnął takie wyniki w tym teście porównawczym. Wyniki te nie sugerują, że model o1 jest pod każdym względem lepszy od osoby z tytułem doktora — wskazują jedynie, że model ten radzi sobie lepiej w rozwiązywaniu niektórych problemów, których rozwiązania oczekuje się od osoby z tytułem doktora. W kilku innych testach porównawczych ML model o1 osiągnął lepsze wyniki niż najnowocześniejsze do tej pory rozwiązania. Przy włączonych zdolnościach przetwarzania informacji wizualnych model o1 uzyskał wynik 78,2% w teście MMMU, stając się pierwszym modelem, który może konkurować z ludźmi posiadającymi wiedzę ekspercką. Osiągnął również lepsze wyniki niż model GPT‑4o w 54 z 57 podkategorii MMLU.
Model o1 używa łańcucha myśli, próbując rozwiązać problem — podobnie jak człowiek myślący przez dłuższy czas nad odpowiedzią na trudne pytanie. Model o1 uczy się doskonalić swój łańcuch myśli i ulepszać stosowane przez niego strategie przy użyciu uczenia przez wzmacnianie. Uczy się w ten sposób rozpoznawać i poprawiać swoje błędy. Dzielić trudne kroki na prostsze. Próbować zastosować inne podejście, gdy obecne się nie sprawdza. Znacznie poprawia to zdolność modelu do rozumowania. Aby zilustrować uzyskany dzięki temu znaczny postęp, poniżej przedstawiamy łańcuch myśli modelu o1‑preview dotyczący kilku trudnych problemów.
Wytrenowaliśmy model, który uzyskał 213 punktów i uplasował się na 49. percentylu podczas Międzynarodowej Olimpiady Informatycznej (International Olympiad in Informatics, IOI) w 2024 r., zaczynając od poziomu o1 i przeprowadzając dalsze trenowanie w celu poprawy zdolności programowania. Model ten wziął udział w IOI 2024 na takich samych warunkach jak ludzie. Miał dziesięć godzin na rozwiązanie sześciu trudnych zadań algorytmicznych i mógł zgłosić 50 odpowiedzi na każdy problem.
W przypadku każdego problemu nasz system próbkował wiele potencjalnych zgłoszeń i przesyłał 50 z nich na podstawie strategi selekcji w czasie testu. Zgłoszenia wybierano na podstawie wyników uzyskanych w publicznych testach IOI, testach wygenerowanych przez model oraz na podstawie wytrenowanej funkcji punktacji. Gdyby zamiast tego zgłoszenia były przesyłane losowo, średni wynik wynosiłby tylko 156 punktów, co sugeruje, że strategia ta pozwoliła uzyskać prawie 60 punktów więcej w warunkach konkursu.
Przy złagodzonych ograniczeniach dotyczących zgłoszeń stwierdziliśmy, że wyniki modelu znacznie się poprawiły. Przy 10 000 zgłoszeń na problem model osiągnął wynik 362,14 — przekraczający próg złotego medalu — nawet bez strategii selekcji podczas testów.
Wreszcie przeprowadziliśmy symulację zawodów w programowaniu organizowanych przez Codeforces, aby zademonstrować zdolności tego modelu dotyczące programowania. Nasze oceny były bardzo zbliżone do zasad zawodów i pozwalały na 10 zgłoszeń. Model GPT‑4o osiągnął ranking Elo3 wynoszący 808, co plasuje go na 11. percentylu wśród konkurentów ludzi. Wynik modelu znacznie przewyższył zarówno model GPT‑4o, jak i o1 — osiągnął ranking Elo wynoszący 1807, uzyskując wyniki lepsze niż 93% konkurentów.

Dalsza konfiguracja precyzyjna zawodów w programowaniu zwiększa zdolności modelu o1. Ulepszony model uplasował się na 49. percentylu w Międzynarodowej Olimpiadzie Informatycznej w 2024 r. zgodnie z zasadami konkursu.
Oprócz egzaminów i akademickich testów porównawczych przeprowadziliśmy również ocenę opartą na preferencjach człowieka, w ramach której porównaliśmy model o1‑preview z modelem GPT‑4o, stosując trudne, otwarte polecenia z szerokiego zakresu dziedzin. W ramach tej oceny trenerzy otrzymali anonimowe odpowiedzi na polecenie z modelu o1‑preview i GPT‑4o. Następnie musieli wybrać preferowaną przez nich odpowiedź. Model o1‑preview osiąga zdecydowanie lepsze wyniki niż model gpt-4o w kategoriach wymagających intensywnego rozumowania, takich jak analiza danych, programowanie i matematyka. Jednak model o1‑preview nie jest preferowany w przypadku niektórych zadań dotyczących języka naturalnego, co sugeruje, że nie sprawdzi się on do wszystkich zastosowań.

Rozumowanie oparte na łańcuchu myśli stwarza nowe możliwości w zakresie zgodności i bezpieczeństwa. Odkryliśmy, że zintegrowanie naszych zasad dotyczących zachowania modelu z łańcuchem myśli modelu rozumowania to skuteczny sposób na niezawodne przekazanie wartości i zasad człowieka. Ucząc model naszych zasad bezpieczeństwa i sposobu rozumowania na ich temat w kontekście, znaleźliśmy dowody na to, że zdolność rozumowania bezpośrednio wpływa na niezawodność modelu: o1‑preview osiągnął znacznie lepsze wyniki w najważniejszych ocenach obejścia zabezpieczeń oraz w naszych najtrudniejszych wewnętrznych testach porównawczych służących do oceny granic odmawiania odpowiedzi ze względów bezpieczeństwa. Uważamy, że stosowanie łańcucha myśli znacznie poprawia bezpieczeństwo i zgodność, ponieważ (1) umożliwia nam obserwowanie myślenia modelu w czytelny sposób, a (2) rozumowanie modelu dotyczące zasad bezpieczeństwa jest odporniejsze na scenariusze spoza rozkładu.
Aby przetestować nasze ulepszenia, przed wdrożeniem przeprowadziliśmy serię testów bezpieczeństwa i testów z pomocą zespołu czerwonego zgodnie z naszymi Ramami gotowości(otwiera nowe okno). Okazało się, że rozumowanie z użyciem łańcucha myśli przyniosło poprawę zdolności we wszystkich naszych ocenach. Na szczególną uwagę zasługują interesujące przypadki hakowania nagrody(otwiera nowe okno). Szczegółowe rezultaty tych ocen publikujemy w dołączonej karcie systemu.
| Metryka | GPT-4o | o1-preview |
|---|---|---|
| % bezpiecznych odpowiedzi w przypadku szkodliwych poleceń Standardowe | 0,990 | 0,995 |
| % bezpiecznych odpowiedzi w przypadku szkodliwych poleceń Trudne: obejścia zabezpieczeń i skrajne przypadki | 0,714 | 0,934 |
| ↳ Nękanie (poważne) | 0,845 | 0,900 |
| ↳ Treści o charakterze seksualnym oparte na wykorzystaniu osób | 0,483 | 0,949 |
| ↳ Treści o charakterze seksualnym z udziałem osób niepełnoletnich | 0,707 | 0,931 |
| ↳ Informacja dotyczące niewłaściwego postępowania bez użycia przemocy | 0,688 | 0,961 |
| ↳ Informacja dotyczące niewłaściwego postępowania z użyciem przemocy | 0,778 | 0,963 |
| % bezpiecznych odpowiedzi w przypadku 200 najlepszych wyników Moderation API dla kategorii w WildChat Zhao, et al. 2024 | 0,945 | 0,971 |
| Ocena obejścia zabezpieczeń Goodness@0.1 StrongREJECT Souly et al. 2024 | 0,220 | 0,840 |
| Obejścia zabezpieczeń stworzone przez ludzi | 0,770 | 0,960 |
| % Zgodność dotycząca wewnętrznych nieszkodliwych skrajnych przypadków “not over-refusal” | 0,910 | 0,930 |
| % Zgodność w przypadku nieszkodliwych skrajnych przypadków w XSTest “not over-refusal” Röttger, et al. 2023 | 0,924 | 0,976 |
Uważamy, że ukryty łańcuch myśli stwarza wyjątkową okazję do monitorowania modeli. Zakładając, że jest on wierny i czytelny, ukryty łańcuch myśli pozwala nam „czytać w myślach” modelu i zrozumieć jego proces myślowy. Na przykład w przyszłości możemy chcieć monitorować łańcuch myśli pod kątem prób manipulowania użytkownikiem. Aby jednak było to możliwe, model musi mieć swobodę wyrażania swoich myśli w niezmienionej formie, dlatego nie możemy przeprowadzać żadnego treningu egzekwującego zgodność z zasadami lub preferencje użytkownika w łańcuchu myśli. Nie chcemy również, aby niezgodny łańcuch myśli był widoczny bezpośrednio dla użytkowników.
W związku z tym po rozważeniu wielu czynników, w tym doświadczenia użytkowników, przewagi konkurencyjnej i możliwości monitorowania łańcucha myśli, zdecydowaliśmy się nie pokazywać użytkownikom nieprzetworzonych łańcuchów myśli. Zdajemy sobie sprawę, że ta decyzja ma swoje wady. Staramy się częściowo to zrekompensować, ucząc model odtwarzania wszelkich przydatnych pomysłów z łańcucha myśli w odpowiedzi. W przypadku serii modeli o1 pokazujemy wygenerowane przez model podsumowanie łańcucha myśli.
o1 to duży krok naprzód w dziedzinie nowatorskiego rozumowania AI. Planujemy wydawać ulepszone wersje tego modelu wraz z kolejnymi iteracjami. Oczekujemy, że nowe zdolności rozumowania poprawią zgodność modeli z ludzkimi wartościami i zasadami. Wierzymy, że model o1 — i jego następcy — umożliwią wiele nowych zastosowań AI w nauce, programowaniu, matematyce i dziedzinach pokrewnych. Cieszymy się, że użytkownicy i programiści korzystający z interfejsów API będą mogli odkryć sposoby, w jakie ten model może usprawnić ich codzienną pracę.
| Zestaw danych | Metryka | gpt-4o | o1-preview | o1 |
|---|---|---|---|---|
| Konkurs matematyczny AIME (2024) | cons@64 | 13,4 | 56,7 | 83,3 |
| pass@1 | 9,3 | 44,6 | 74,4 | |
| Zawody w programowaniu CodeForces | Elo | 808 | 1258 | 1673 |
| Percentyl | 11,0 | 62,0 | 89,0 | |
| GPQA Diamond | cons@64 | 56,1 | 78,3 | 78,0 |
| pass@1 | 50,6 | 73,3 | 77,3 | |
| Biologia | cons@64 | 63,2 | 73,7 | 68,4 |
| pass@1 | 61,6 | 65,9 | 69,2 | |
| Chemia | cons@64 | 43,0 | 60,2 | 65,6 |
| pass@1 | 40,2 | 59,9 | 64,7 | |
| Fizyka | cons@64 | 68,6 | 89,5 | 94,2 |
| pass@1 | 59,5 | 89,4 | 92,8 | |
| MATH | pass@1 | 60,3 | 85,5 | 94,8 |
| MMLU | pass@1 | 88,0 | 92,3 | 90,8 |
| MMMU (val) | pass@1 | 69,1 | Nie dot. | 78,2 |
| MathVista (testmini) | pass@1 | 63,8 | Nie dot. | 73,9 |
Autorzy
Przypisy
- 1
- 2
W naszych ocenach użyliśmy tego samego podziału 500 testów z problemami, który został opisany tutaj https://arxiv.org/abs/2305.20050(otwiera nowe okno)
- 3