Jak dwa ustawienia potroiły nasze wyniki w benchmarku ARC-AGI-3
Przyspieszone nagranie, na którym GPT‑5.6 Sol próbuje rozwiązywać łamigłówki benchmarku ARC-AGI-3 w oficjalnym otoczeniu operacyjnym (po lewej) oraz w naszym otoczeniu opartym na Responses API (po prawej), które zachowuje rozumowanie i włącza kompaktowanie. W rankingu tej gry(otwiera nowe okno) żaden pionierski model nie rozwiązuje poziomu wyższego niż pierwszy. W naszym otoczeniu GPT‑5.6 Sol rozwiązuje wszystkie sześć.
Gdy po raz pierwszy zobaczyliśmy niskie wyniki GPT‑5.6 Sol w benchmarku ARC-AGI-3(otwiera nowe okno), byliśmy zaskoczeni.
GPT‑5.6 Sol rozwiązał nierozstrzygnięte od dawna problemy matematyczne, takie jak hipoteza o podwójnym pokryciu cyklami(otwiera nowe okno), i pokonał gry takie jak Pokémon FireRed. Jednak w ARC-AGI-3, benchmarku złożonym z dwuwymiarowych gier logicznych, GPT‑5.6 Sol uzyskał zaledwie 7,8%, a GPT‑5.5 ledwo potrafił w nie grać i osiągnął marne 0,4%.
Czy dwuwymiarowe gry logiczne były wyjątkowo trudne dla naszych modeli? A może chodziło o coś innego?
Benchmarki rzadko mierzą modele AI w oderwaniu od innych czynników. Mierzą też mniej widoczne decyzje dotyczące ustawień API, projektu otoczenia operacyjnego i formułowania promptów. W przypadku ARC-AGI-3 odkryliśmy, że włączenie dwóch ustawień API używanych przez nas w ChatGPT i Codex—zachowywania rozumowania oraz kompaktowania—potroiło wyniki i sześciokrotnie zmniejszyło liczbę tokenów wyjściowych w publicznym zestawie zadań.
W oficjalnym otoczeniu operacyjnym GPT‑5.6 Sol uzyskał 13,3% w publicznym zestawie ARC-AGI-3. Po zachowaniu rozumowania i włączeniu kompaktowania uzyskał 38,3%. Wyniki mierzą względną efektywność działań człowieka (RHAE(otwiera nowe okno))—wskaźnik porównujący wydajność modelu z poziomem bazowym człowieka. Na podstawie oficjalnych dzienników rozgrywki(otwiera nowe okno) szacujemy, że testerzy uzyskiwali średnio 48%. Modele nie wiedzą, jak będą oceniane, i w trakcie gry nie widzą swojego wyniku—działania zwracają jedynie tekstową reprezentację każdej klatki oraz informację o bieżącym poziomie.
ARC-AGI-3 to benchmark służący do pomiaru zdolności agentów AI do uczenia się i rozumowania. Agenci eksplorują nieznane gry 2D i bez wyraźnych instrukcji ustalają zasady ich działania. W 25 gier demonstracyjnych można zagrać na stronie arcprize.org/tasks(otwiera nowe okno).
ARC-AGI-3 celowo korzysta z ogólnego otoczenia operacyjnego, bez narzędzi ani funkcji specjalnych. ARC kierowało się założeniem, że proste otoczenie operacyjne wyraźniej ukazuje niedoskonałości modeli i pozwala porównywać je w bardziej sprawiedliwy sposób. Twórcy rozwiązań komercyjnych optymalizują natomiast otoczenia operacyjne pod kątem funkcji i specyfiki poszczególnych modeli.
W grach GPT‑5.6 Sol pokonał Pokémon FireRed, korzystając z otoczenia operacyjnego opartego wyłącznie na obrazie (transmisja: GPT_Plays_Pokemon(otwiera nowe okno)), Slay the Spire, sterując komputerem za pomocą Codex (transmisja: EpochAI(otwiera nowe okno)), oraz pierwsze etapy Baba Is You (materiał udostępnili Piotr Migdał & Piotr Grabowski(otwiera nowe okno)). Co tak bardzo odróżniało ARC-AGI-3?
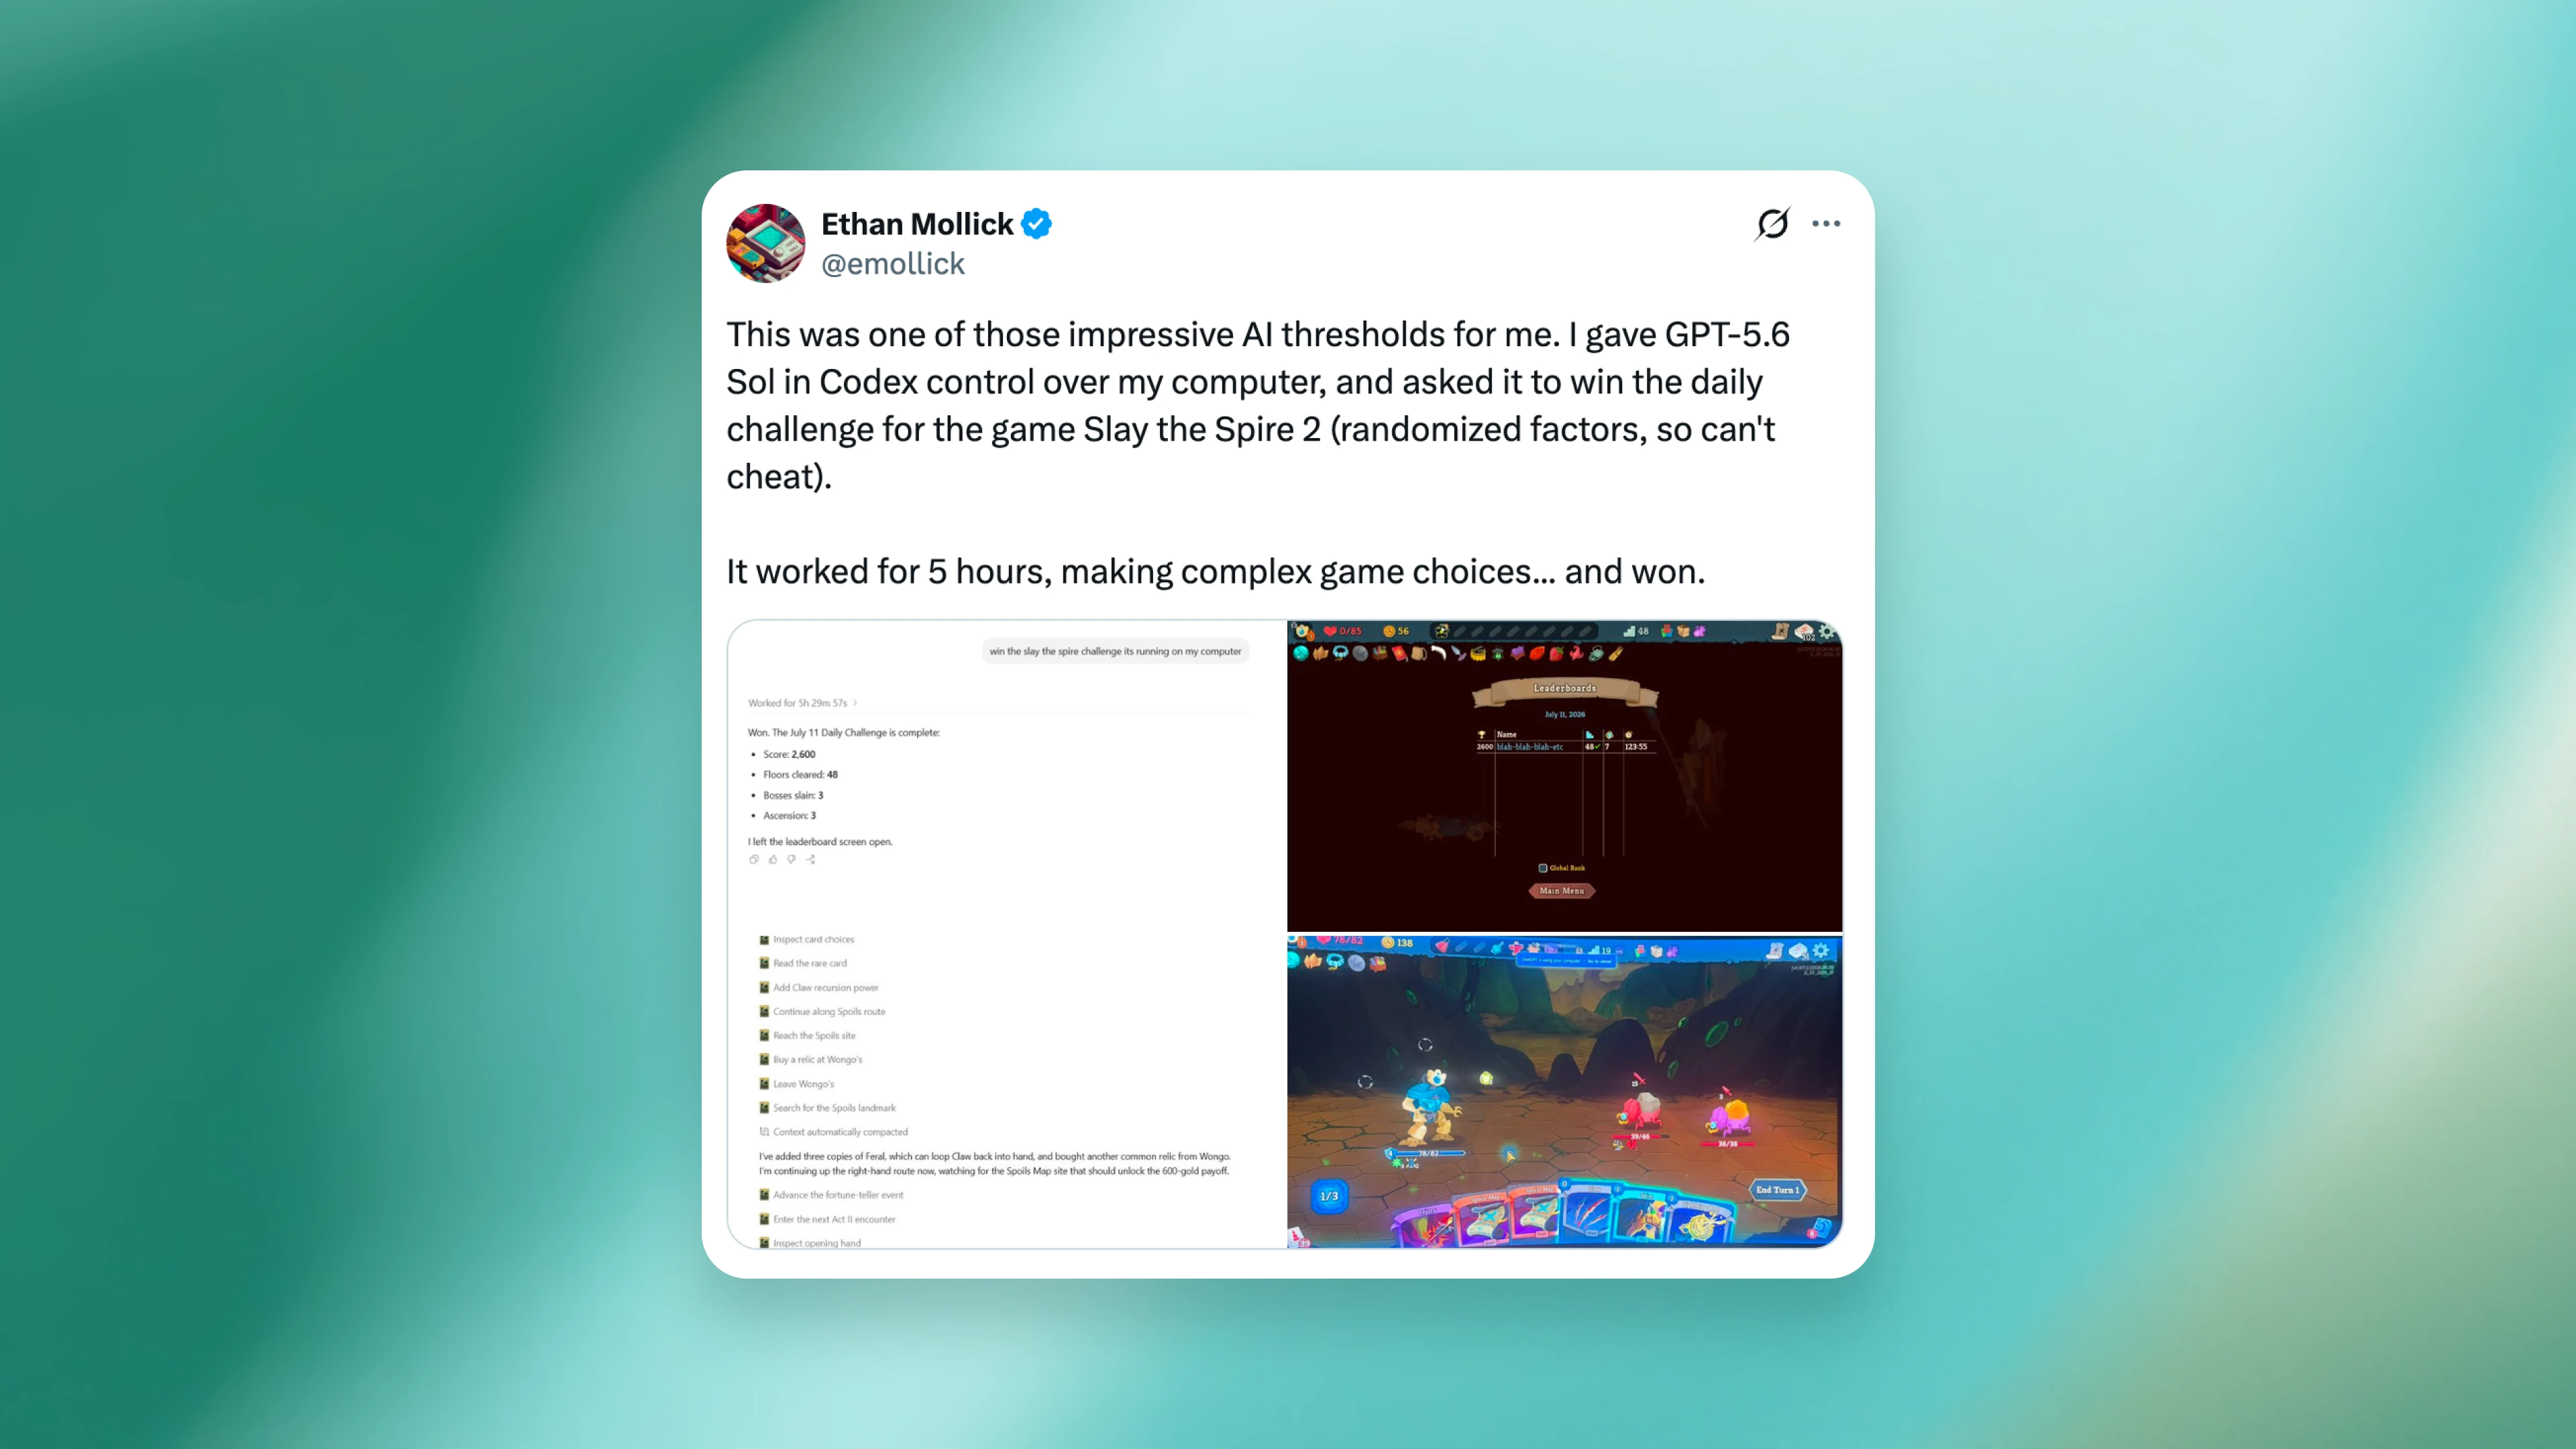
Ethan Mollick pokazuje(otwiera nowe okno), jak GPT‑5.6 Sol w Codex pokonuje losowe wyzwanie dnia w Slay the Spire 2—grze wydanej po dacie granicznej wiedzy GPT‑5.6 Sol.
Zainspirowani analizą niedoskonałości GPT‑5.5 przeprowadzoną przez ARC(otwiera nowe okno), przyjrzeliśmy się niektórym próbom GPT‑5.6 Sol. Podobnie jak ARC zauważyliśmy, że model nie sprawiał wrażenia zbyt bystrego. Długo zastanawiał się nad każdym działaniem i z trudem robił postępy.
Głębsza analiza wykazała jednak, że znaczna część dezorientacji modelu nie wynikała z jego natury, lecz z ustawień otoczenia operacyjnego.
Po pierwsze zauważyliśmy, że po każdym działaniu w grze całe prywatne rozumowanie było odrzucane. Oznaczało to, że przy każdym działaniu GPT‑5.6 Sol musiał na nowo rozgryzać grę, nie pamiętając swoich wcześniejszych przemyśleń. Model nadal widział zapis poprzednich ruchów i krótkie notatki, ale nie miał dostępu do planów, spostrzeżeń ani przemyśleń, które do nich doprowadziły.
Po drugie zauważyliśmy, że otoczenie operacyjne używało przesuwnego okna obcinania, przez co wraz z rozrastaniem się historii starsze działania przestawały być widoczne. GPT‑5.6 Sol nie tylko nie pamiętał więc wcześniejszych przemyśleń, lecz także tracił pamięć o poprzednich działaniach.
Te dwie cechy otoczenia operacyjnego—odrzucanie rozumowania i przesuwne obcinanie—pomogły wyjaśnić, dlaczego GPT‑5.6 Sol miał trudności z uczeniem się w miarę upływu czasu.
Nasze modele są trenowane tak, aby przed wygenerowaniem odpowiedzi lub wywołaniem narzędzia przeprowadzały rozumowanie w prywatnych komunikatach. Te prywatne komunikaty z przemyśleniami są zachowywane w historii rozmowy. Jeśli rozmowa staje się zbyt długa, podsumowujemy ją i kontynuujemy.

W ten sposób trenujemy nasze modele i tak też wdrażamy je w ChatGPT oraz Codex. Aby lepiej odwzorować nasze środowisko produkcyjne, wdrożyliśmy otoczenie operacyjne ARC-AGI-3 przy użyciu naszego Responses API(otwiera nowe okno). Nasze API ułatwia zarządzanie kontekstem: w przypadku GPT‑5.6 przekazanie identyfikatora poprzedniej odpowiedzi automatycznie zachowuje rozumowanie między wywołaniami narzędzi i turami rozmowy.
Po włączeniu zachowywania rozumowania zauważyliśmy dwie istotne zmiany. Po pierwsze GPT‑5.6 Sol krócej zastanawiał się przed każdym działaniem, ponieważ nie musiał już w każdej turze interpretować gry od początku. Po drugie możliwość zapamiętywania wcześniejszych przemyśleń sprawiła, że GPT‑5.6 Sol znacznie lepiej uczył się z czasem i stosował spójne strategie.
Kolejną poprawę przyniosło zastąpienie przesuwnego obcinania kompaktowaniem(otwiera nowe okno)—innym ustawieniem Responses API.
Otoczenie operacyjne ARC-AGI-3 radzi sobie z limitami kontekstu za pomocą przesuwnego obcinania. Gdy kontekst rozmowy przekracza 175 000 znaków, najstarsze komunikaty są odrzucane.
Przesuwne obcinanie ma dwie wady. Po pierwsze model traci wcześniejsze obserwacje i działania. Po drugie przez znaczną część zadań działa z bardziej zapełnionym oknem kontekstu, co może nieco obniżać wydajność.
Po włączeniu kompaktowania w ARC-AGI-3 GPT‑5.6 Sol lepiej zachowywał podczas dłuższych sesji wiedzę zdobytą o każdej grze i osiągnął wyższy wynik przy mniejszej liczbie tokenów wyjściowych.
Aby zilustrować wpływ zachowywania rozumowania i kompaktowania, przedstawiamy animację pokazującą, jak GPT‑5.6 Sol wykorzystuje okno kontekstu o pojemności 175 tys. podczas rozwiązywania serii łamigłówek ARC-AGI-3 w każdym z otoczeń operacyjnych.
Dwie środkowe kolumny pokazują, jak każde z otoczeń operacyjnych inaczej wykorzystuje okno kontekstu modelu. Dzięki lepszej pamięci wcześniejszych działań GPT‑5.6 Sol poświęca mniej czasu na rozumowanie przed każdym ruchem i działa znacznie szybciej. Uwaga: nasza implementacja stosuje limit 175 000 tokenów zamiast znaków, ale wartości te są dość zbliżone, ponieważ zdecydowana większość tekstu to siatki działań, które nasz tokenizer przetwarza w stosunku 1:1.
Łącznie zachowywanie rozumowania i kompaktowanie pozwalają GPT‑5.6 Sol (Maks) osiągnąć około trzykrotnie wyższy wynik przy sześciokrotnie mniejszej liczbie tokenów wyjściowych.
Mamy nadzieję, że te eksperymenty przypomną, iż ewaluacje rzadko mierzą modele w oderwaniu od innych czynników—uwzględniają też zestaw mniej widocznych decyzji dotyczących ustawień API, projektu otoczenia operacyjnego i formułowania promptów. To nie pierwszy raz, gdy zaskoczyły nas niskie wyniki w publicznym benchmarku, po czym odkryliśmy, że mechanizm ewaluacyjny korzystał z ogólnego otoczenia operacyjnego, które pomijało komunikaty z rozumowaniem.
Deweloperom API, którzy chcą maksymalizować wydajność, zalecamy korzystanie z tych samych ustawień, które wdrażamy w naszych produktach:
Korzystaj z naszego Responses API zamiast starszego API zakończenia czatu
Zachowuj rozumowanie
Korzystaj z kompaktowania
Jeśli zaś porównujesz modele, zalecamy opieranie się na ewaluacjach wykorzystujących powyższe ustawienia, ponieważ najlepiej odzwierciedlają one rzeczywiste zastosowania w ChatGPT i Codex.
Dziękujemy ARC za lata twórczej pracy nad ewaluacją AGI oraz za analizę, która zainspirowała nas do bliższego przyjrzenia się temu zagadnieniu.
Jeśli chcesz zmierzyć się z pionierskimi modelami, samodzielnie wypróbuj publiczne gry na stronie arcprize.org/tasks(otwiera nowe okno).