OpenAI o1 ਮੁਕਾਬਲਾਤੀ ਪ੍ਰੋਗ੍ਰਾਮਿੰਗ ਪ੍ਰਸ਼ਨਾਂ (Codeforces) ਵਿੱਚ 89ਵੇਂ ਪ੍ਰਤੀਸ਼ਤਕ ਵਿੱਚ ਰੈਂਕ ਕਰਦਾ ਹੈ, USA Math Olympiad (AIME) ਲਈ ਇੱਕ ਕਵਾਲੀਫਾਇਰ ਵਿੱਚ ਅਮਰੀਕਾ ਦੇ ਸਿਖਰਲੇ 500 ਵਿਦਿਆਰਥੀਆਂ ਵਿੱਚ ਥਾਂ ਬਣਾਉਂਦਾ ਹੈ, ਅਤੇ ਭੌਤਿਕ ਵਿਗਿਆਨ, ਜੀਵ ਵਿਗਿਆਨ ਅਤੇ ਰਸਾਇਣ ਵਿਗਿਆਨ ਦੀਆਂ ਸਮੱਸਿਆਵਾਂ ਦੇ ਇੱਕ ਬੈਂਚਮਾਰਕ (GPQA) 'ਤੇ ਮਨੁੱਖੀ PhD-ਪੱਧਰ ਦੀ ਸ਼ੁੱਧਤਾ ਤੋਂ ਵੱਧ ਜਾਂਦਾ ਹੈ. ਜਦੋਂ ਕਿ ਇਸ ਨਵੇਂ ਮਾਡਲ ਨੂੰ ਮੌਜੂਦਾ ਮਾਡਲਾਂ ਜਿੰਨਾ ਆਸਾਨੀ ਨਾਲ ਵਰਤਣਯੋਗ ਬਣਾਉਣ ਲਈ ਲੋੜੀਂਦਾ ਕੰਮ ਹਾਲੇ ਜਾਰੀ ਹੈ, ਅਸੀਂ ਇਸ ਮਾਡਲ ਦਾ ਇੱਕ ਸ਼ੁਰੂਆਤੀ ਸੰਸਕਰਨ, OpenAI o1‑preview, ChatGPT ਵਿੱਚ ਤੁਰੰਤ ਵਰਤੋਂ ਲਈ ਅਤੇ ਭਰੋਸੇਯੋਗ API ਯੂਜ਼ਰਾਂ(ਨਵੀਂ ਵਿੰਡੋ ਵਿੱਚ ਖੁੱਲ੍ਹਦਾ ਹੈ) ਲਈ ਜਾਰੀ ਕਰ ਰਹੇ ਹਾਂ.
ਸਾਡਾ ਵੱਡੇ ਪੱਧਰ ਦਾ ਰੀਇਨਫੋਰਸਮੈਂਟ ਲਰਨਿੰਗ ਐਲਗੋਰਿਦਮ ਮਾਡਲ ਨੂੰ ਇੱਕ ਬਹੁਤ ਹੀ ਡਾਟਾ-ਕੁਸ਼ਲ ਟ੍ਰੇਨਿੰਗ ਪ੍ਰਕਿਰਿਆ ਵਿੱਚ ਆਪਣੀ ਵਿਚਾਰ ਲੜੀ ਦੀ ਵਰਤੋਂ ਕਰਕੇ ਉਤਪਾਦਕ ਢੰਗ ਨਾਲ ਸੋਚਣਾ ਸਿਖਾਉਂਦਾ ਹੈ. ਅਸੀਂ ਪਾਇਆ ਹੈ ਕਿ o1 ਦਾ ਪ੍ਰਦਰਸ਼ਨ ਹੋਰ ਰੀਇਨਫੋਰਸਮੈਂਟ ਲਰਨਿੰਗ ਨਾਲ (ਟ੍ਰੇਨ-ਟਾਈਮ ਕੰਪਿਊਟ) ਅਤੇ ਸੋਚਣ ਲਈ ਵੱਧ ਸਮਾਂ ਦੇਣ ਨਾਲ (ਟੈਸਟ-ਟਾਈਮ ਕੰਪਿਊਟ) ਨਿਰੰਤਰ ਸੁਧਰਦਾ ਹੈ. ਇਸ ਪਹੁੰਚ ਨੂੰ ਸਕੇਲ ਕਰਨ ਉੱਤੇ ਪਾਬੰਦੀਆਂ LLM ਪ੍ਰੀਟ੍ਰੇਨਿੰਗ ਵਾਲੀਆਂ ਪਾਬੰਦੀਆਂ ਤੋਂ ਕਾਫ਼ੀ ਵੱਖਰੀਆਂ ਹਨ, ਅਤੇ ਅਸੀਂ ਉਨ੍ਹਾਂ ਦੀ ਜਾਂਚ ਜਾਰੀ ਰੱਖੇ ਹੋਏ ਹਾਂ.
o1 performance smoothly improves with both train-time and test-time compute
GPT‑4o ਨਾਲ ਤੁਲਨਾ ਵਿੱਚ ਰੀਜ਼ਨਿੰਗ ਵਿੱਚ ਸੁਧਾਰ ਨੂੰ ਉਭਾਰਨ ਲਈ, ਅਸੀਂ ਆਪਣੇ ਮਾਡਲਾਂ ਨੂੰ ਮਨੁੱਖੀ ਪਰੀਖਿਆਵਾਂ ਅਤੇ ML ਬੈਂਚਮਾਰਕਾਂ ਦੇ ਇੱਕ ਵਿਭਿੰਨ ਸੈੱਟ ਉੱਤੇ ਟੈਸਟ ਕੀਤਾ. ਅਸੀਂ ਦਿਖਾਉਂਦੇ ਹਾਂ ਕਿ o1 ਇਨ੍ਹਾਂ ਵਿੱਚੋਂ ਵੱਧਤਰ ਰੀਜ਼ਨਿੰਗ-ਭਾਰੀ ਟਾਸਕਾਂ ਵਿੱਚ GPT‑4o ਨਾਲੋਂ ਕਾਫ਼ੀ ਬਿਹਤਰ ਪ੍ਰਦਰਸ਼ਨ ਕਰਦਾ ਹੈ. ਜੇ ਹੋਰ ਤਰ੍ਹਾਂ ਨਿਰਧਾਰਤ ਨਾ ਕੀਤਾ ਗਿਆ ਹੋਵੇ, ਤਾਂ ਅਸੀਂ o1 ਦਾ ਮੁਲਾਂਕਣ ਅਧਿਕਤਮ ਟੈਸਟ-ਟਾਈਮ ਕੰਪਿਊਟ ਸੈਟਿੰਗ 'ਤੇ ਕੀਤਾ.
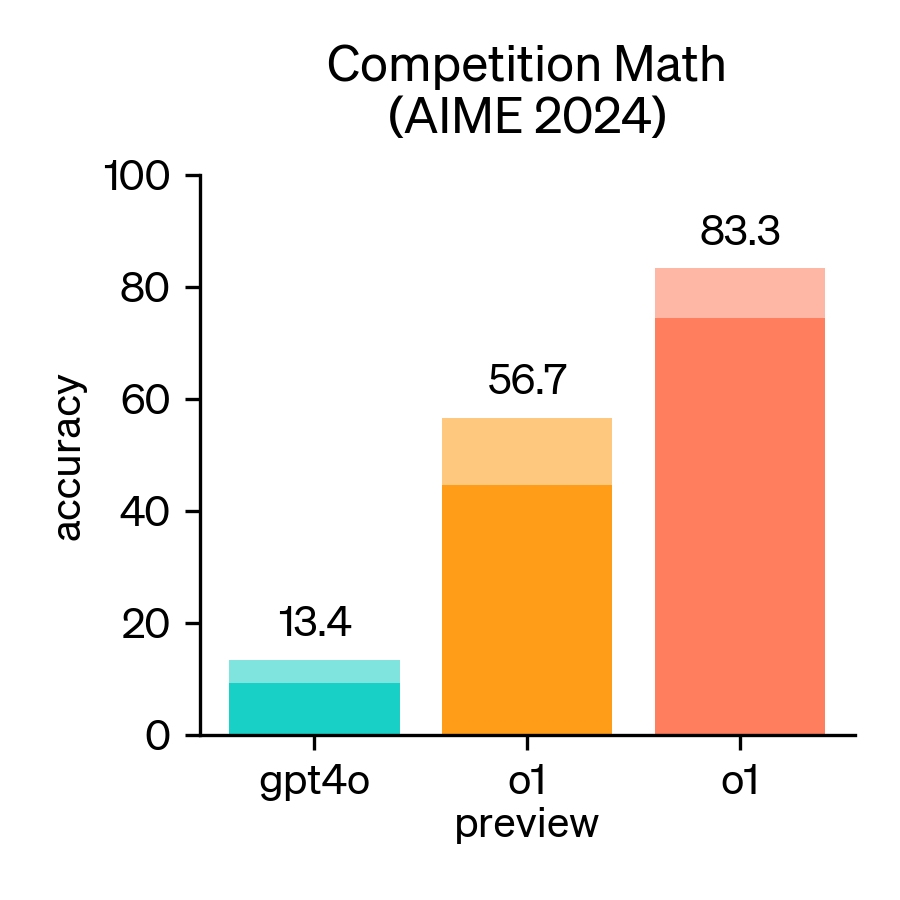
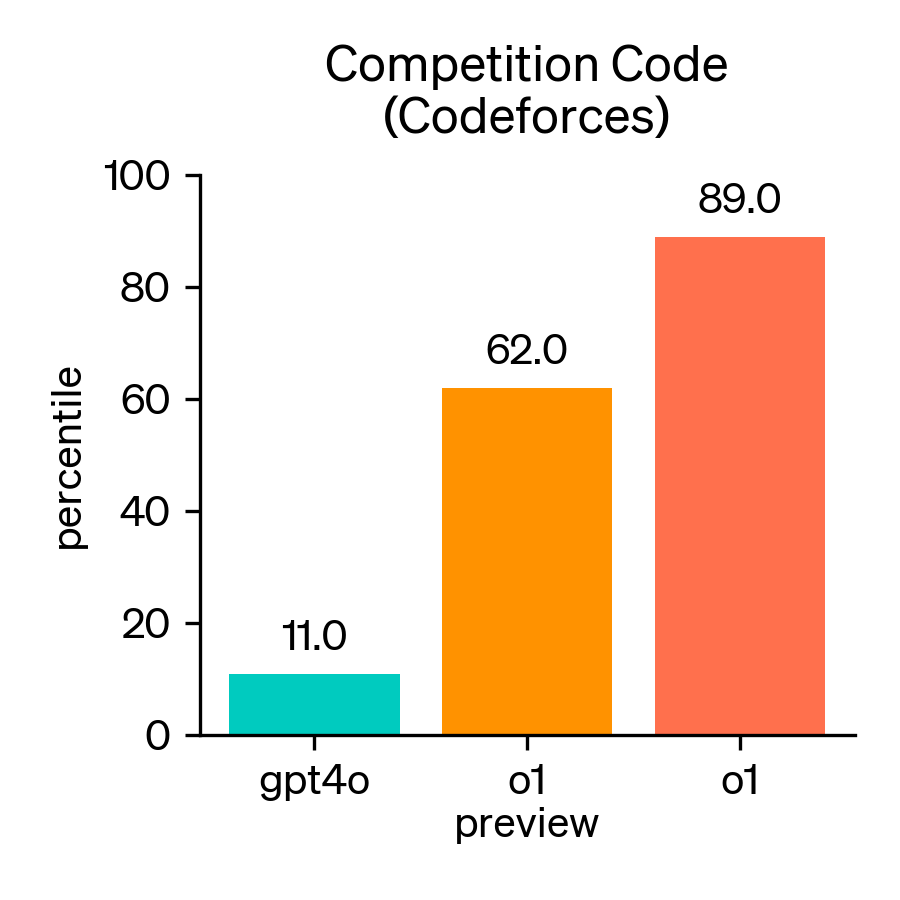
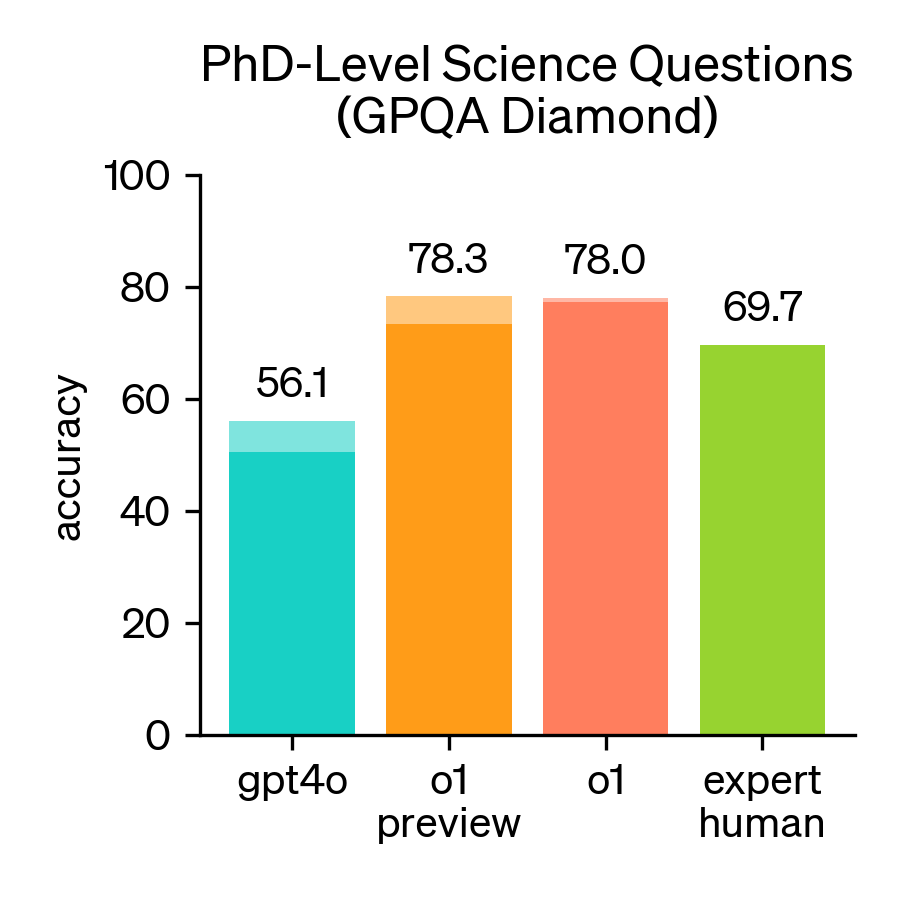
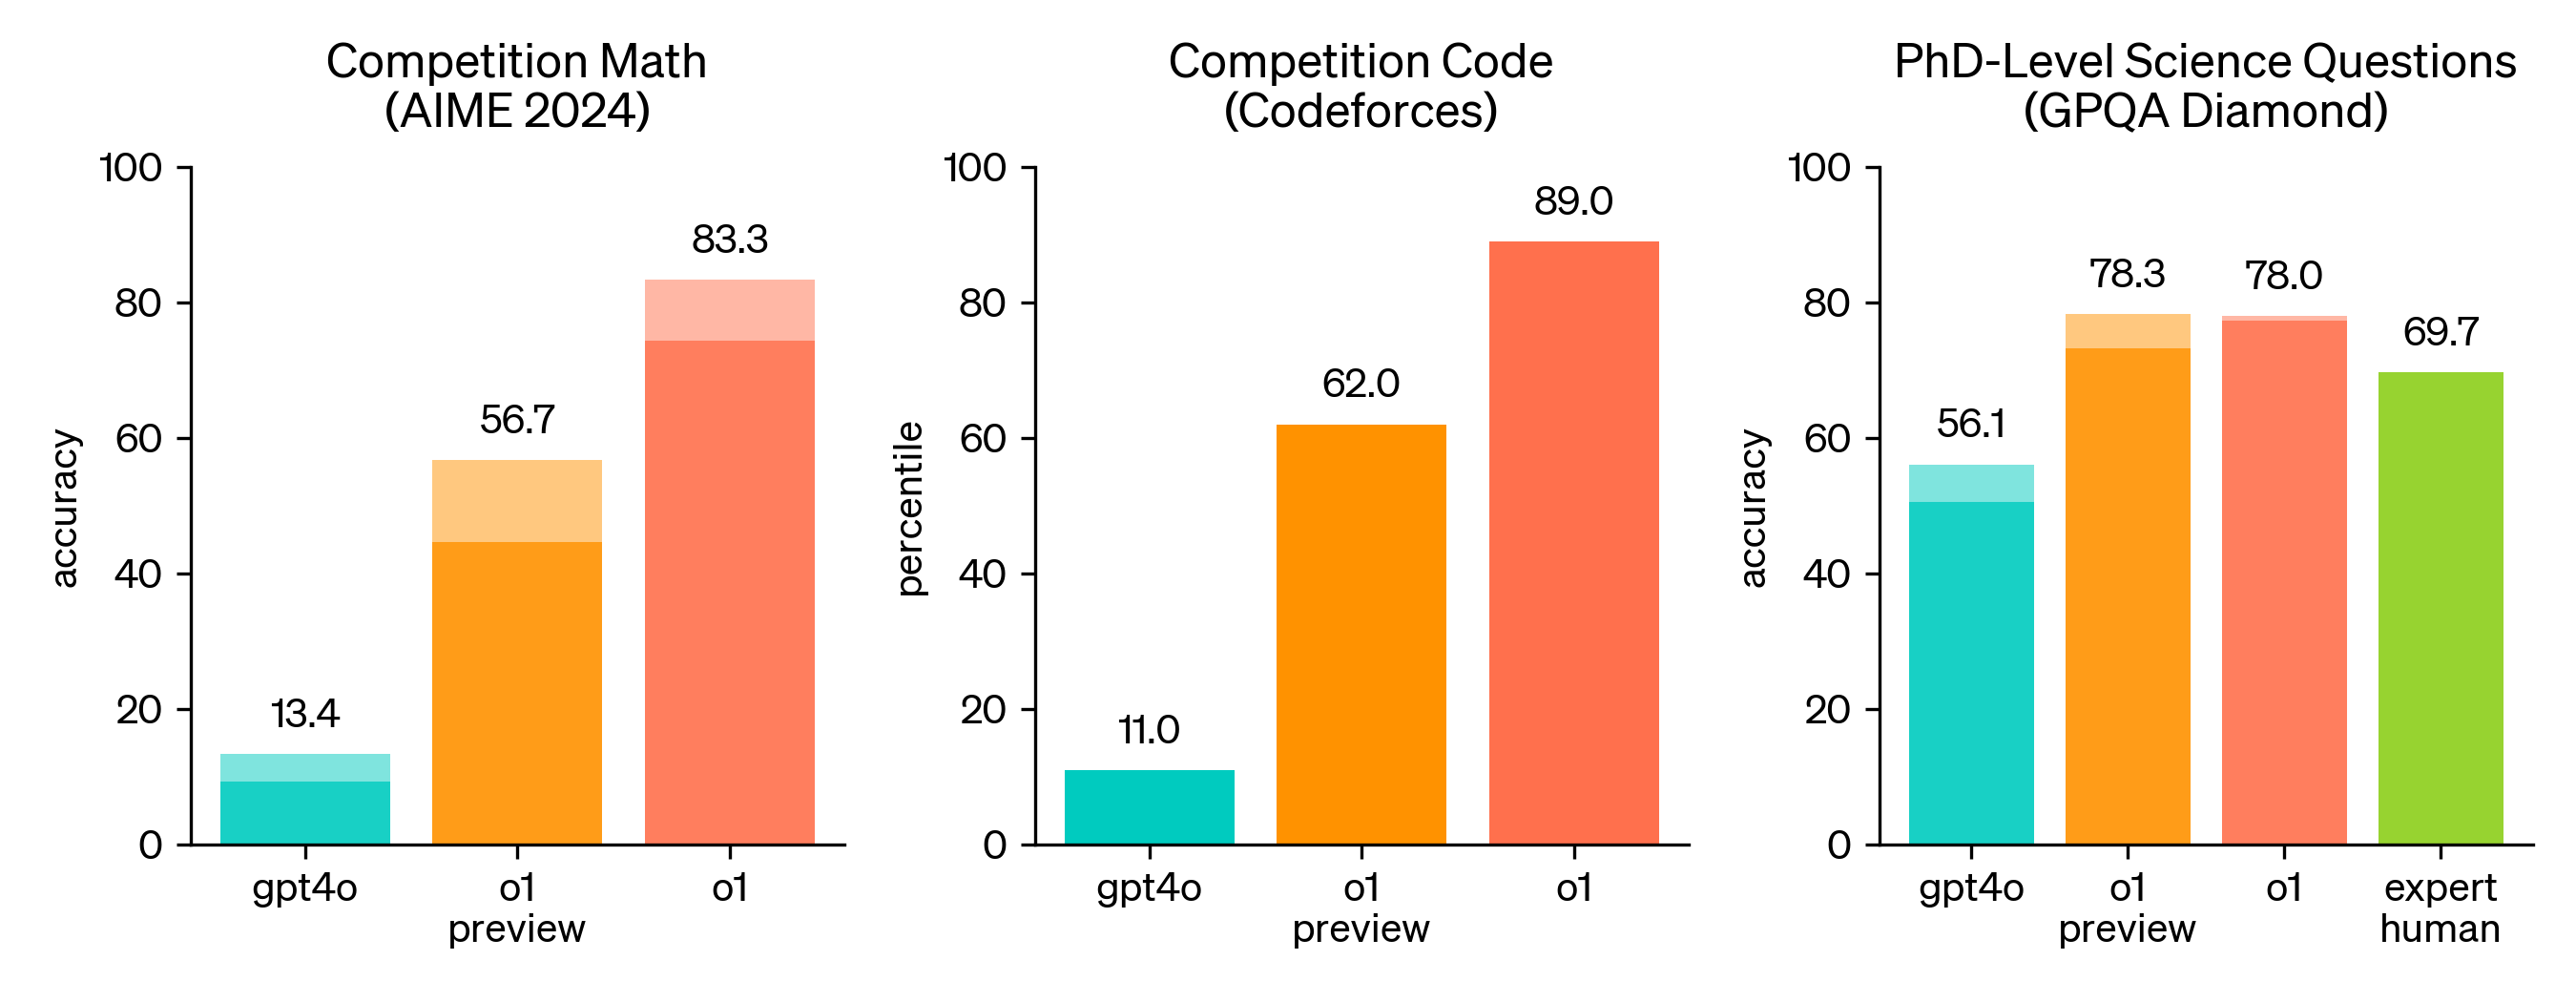
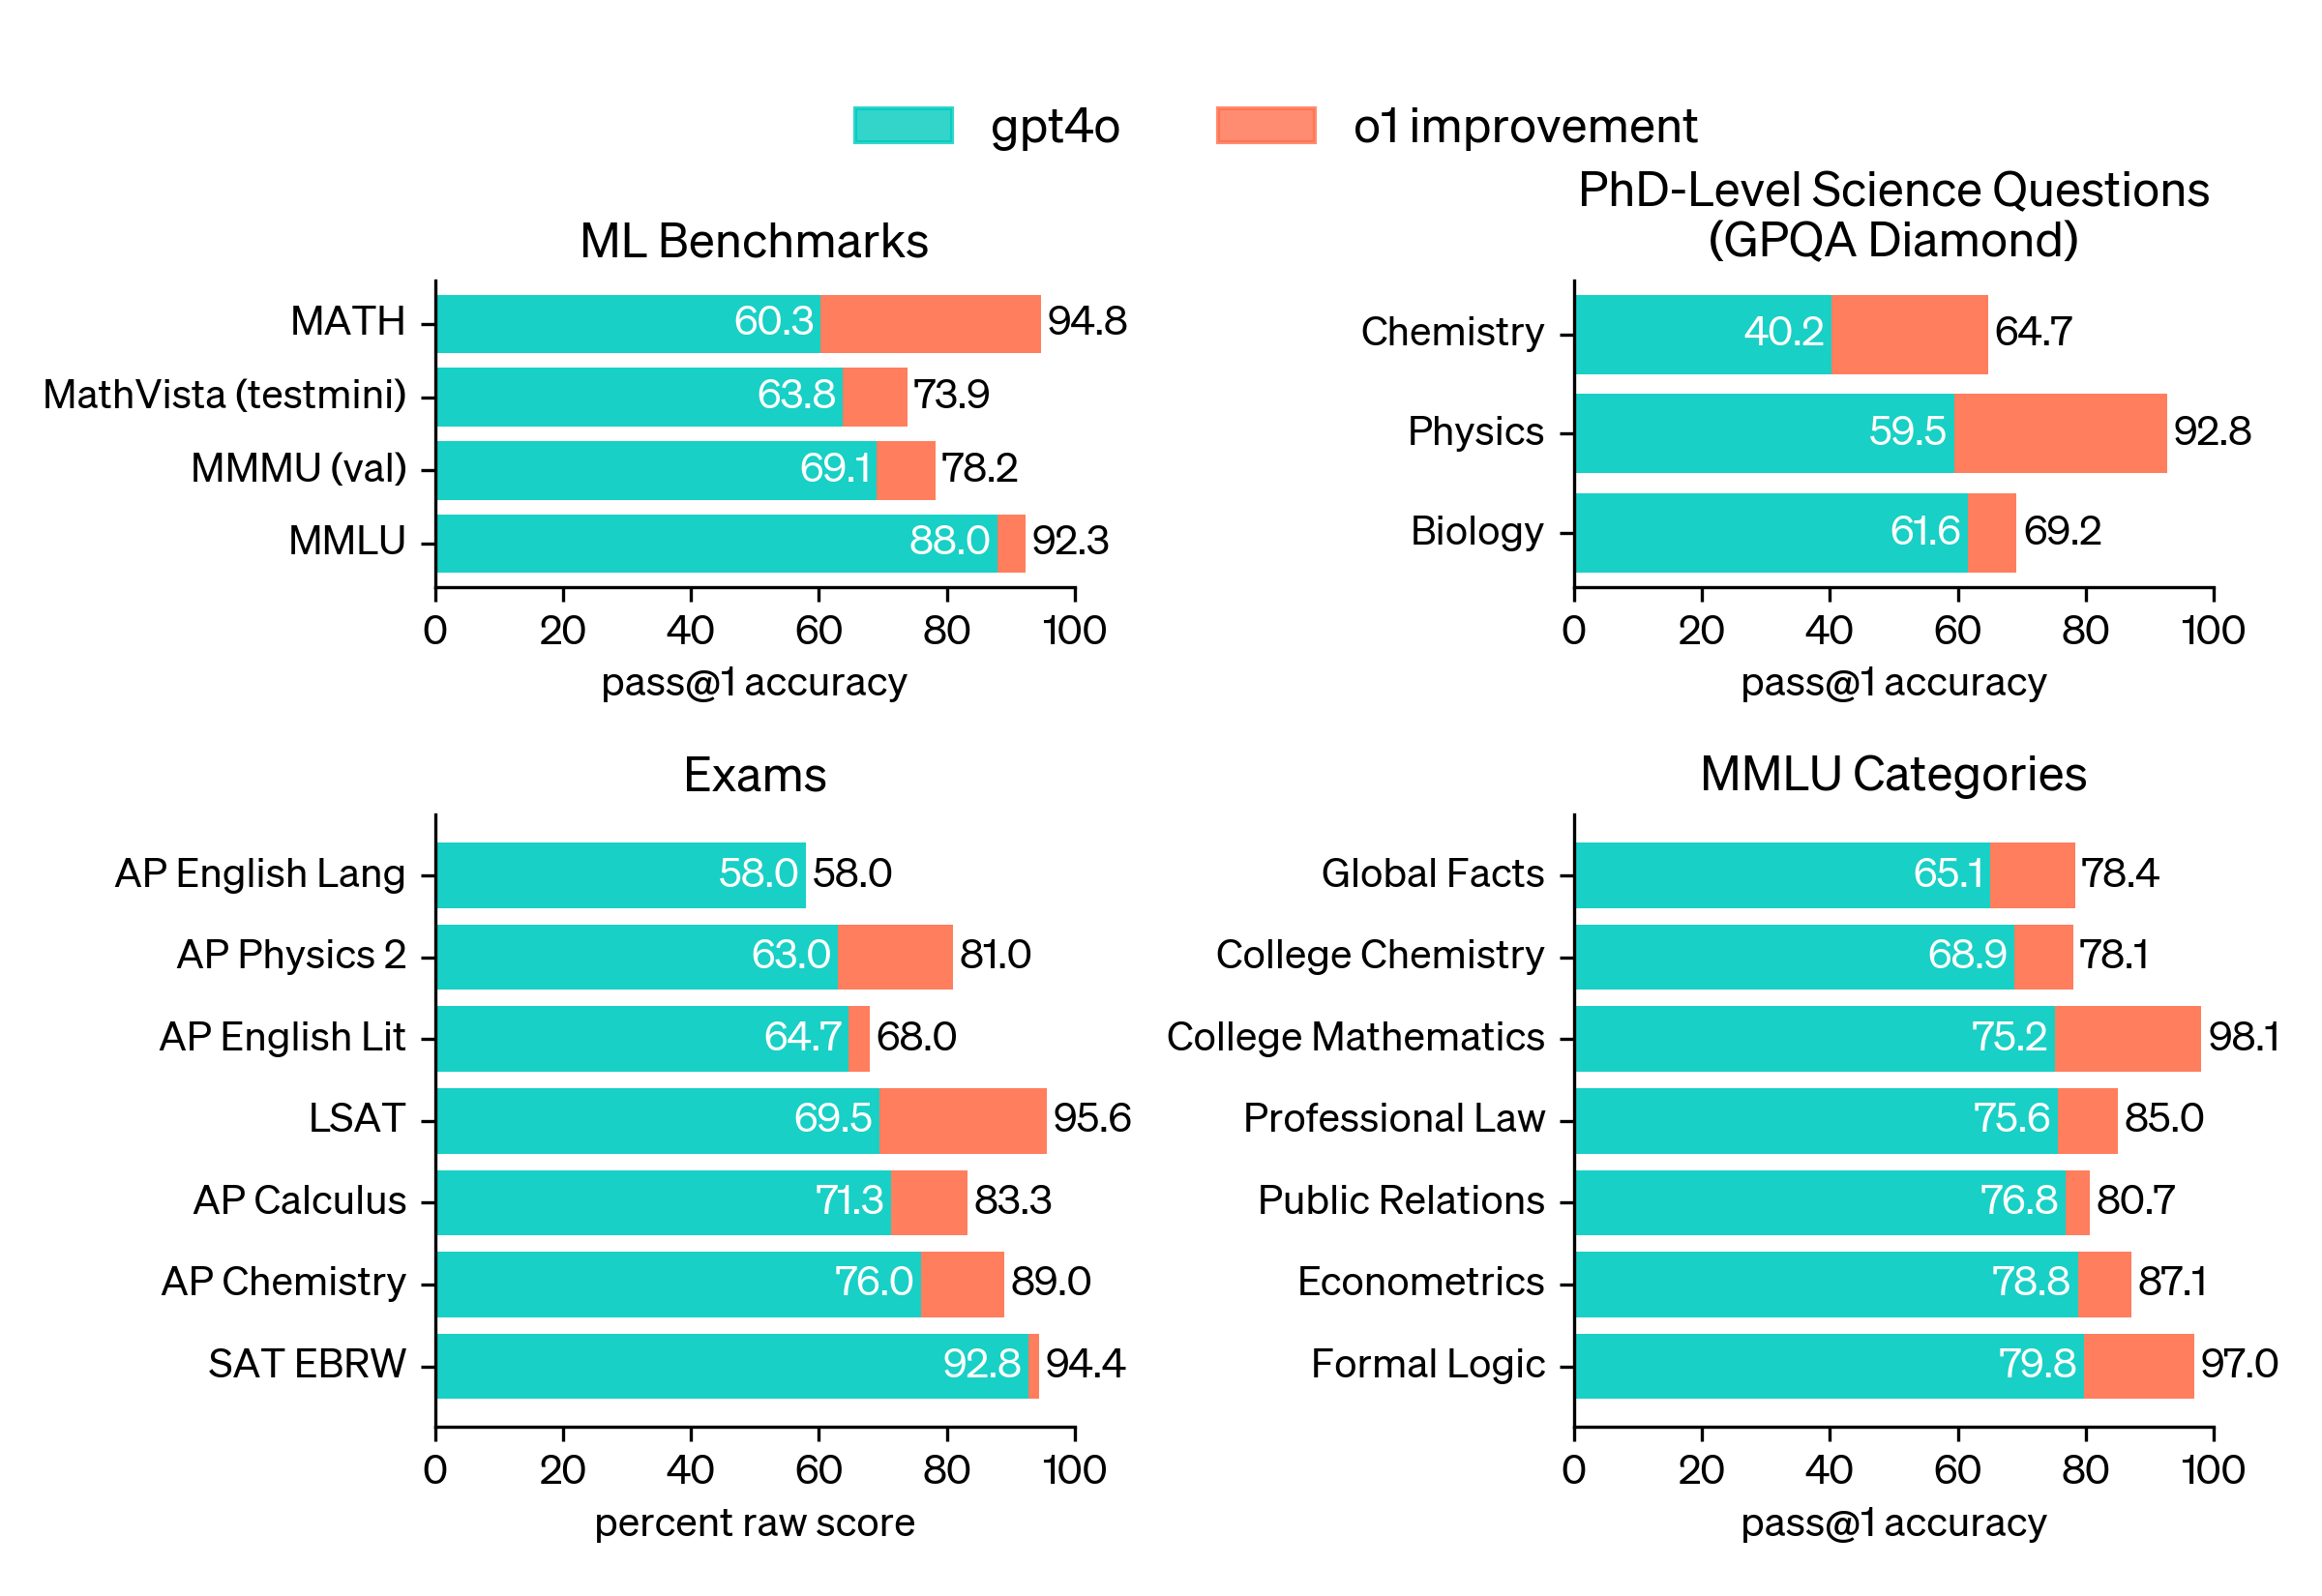
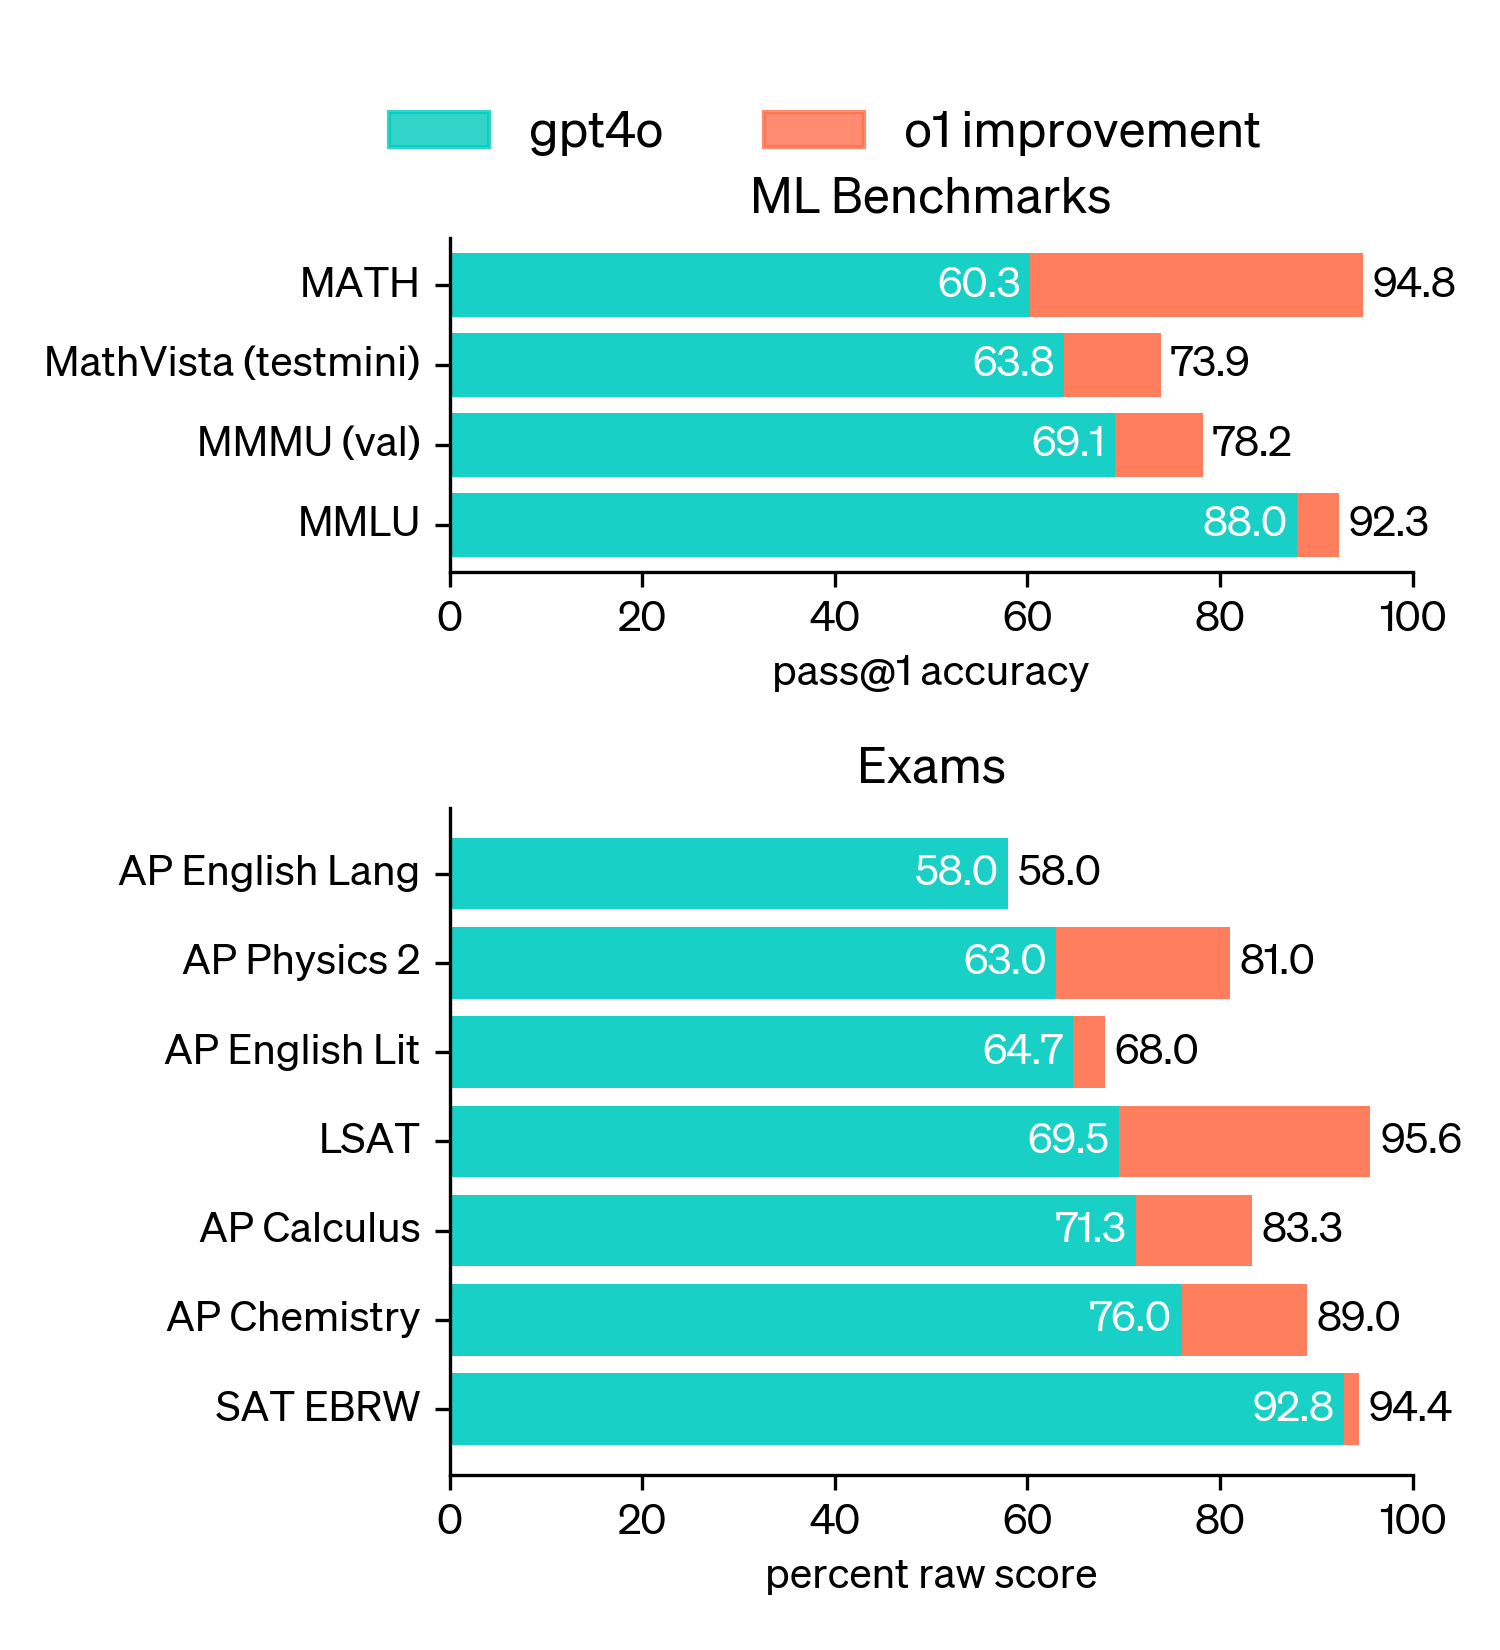
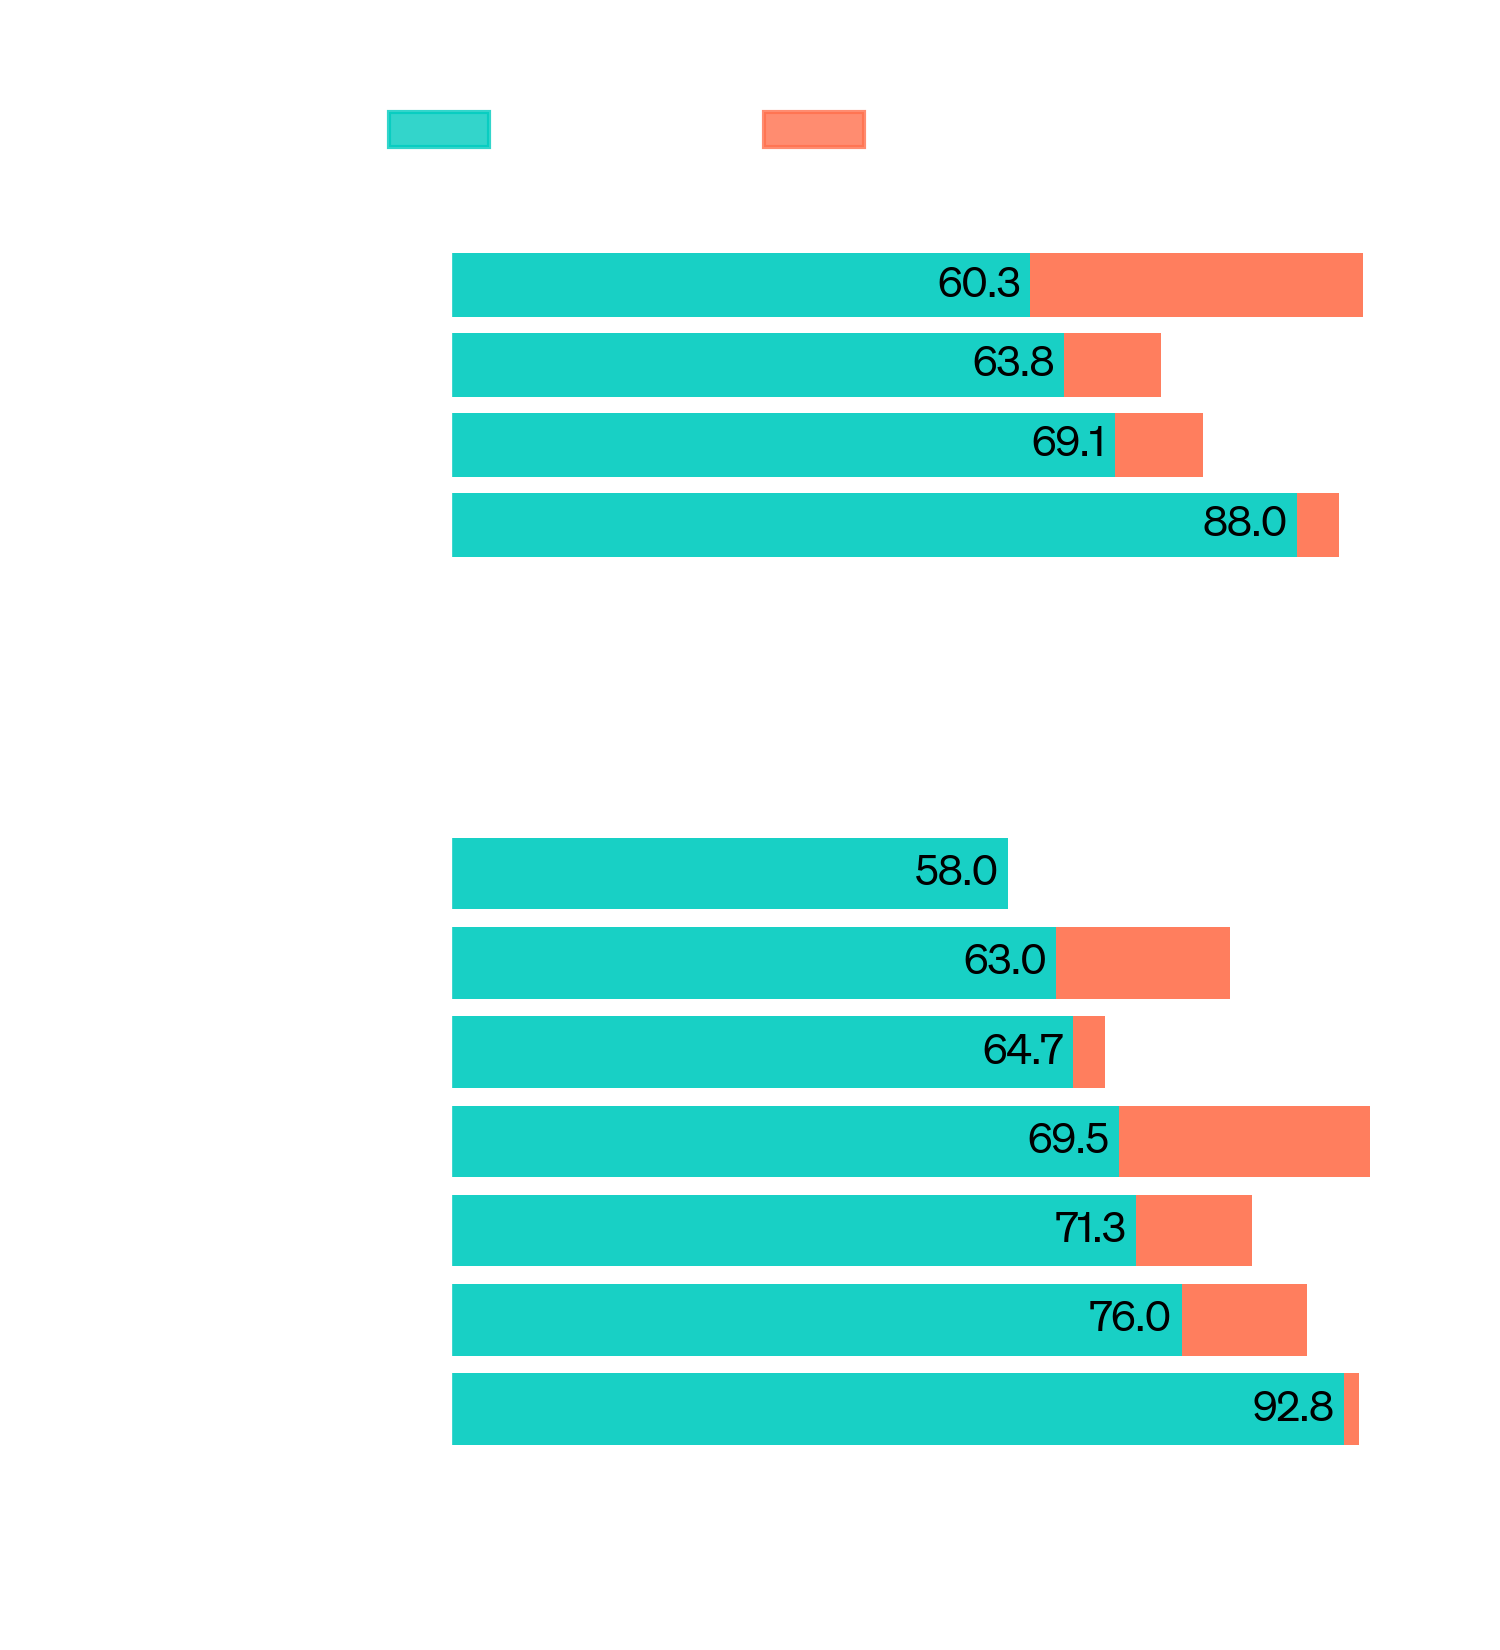
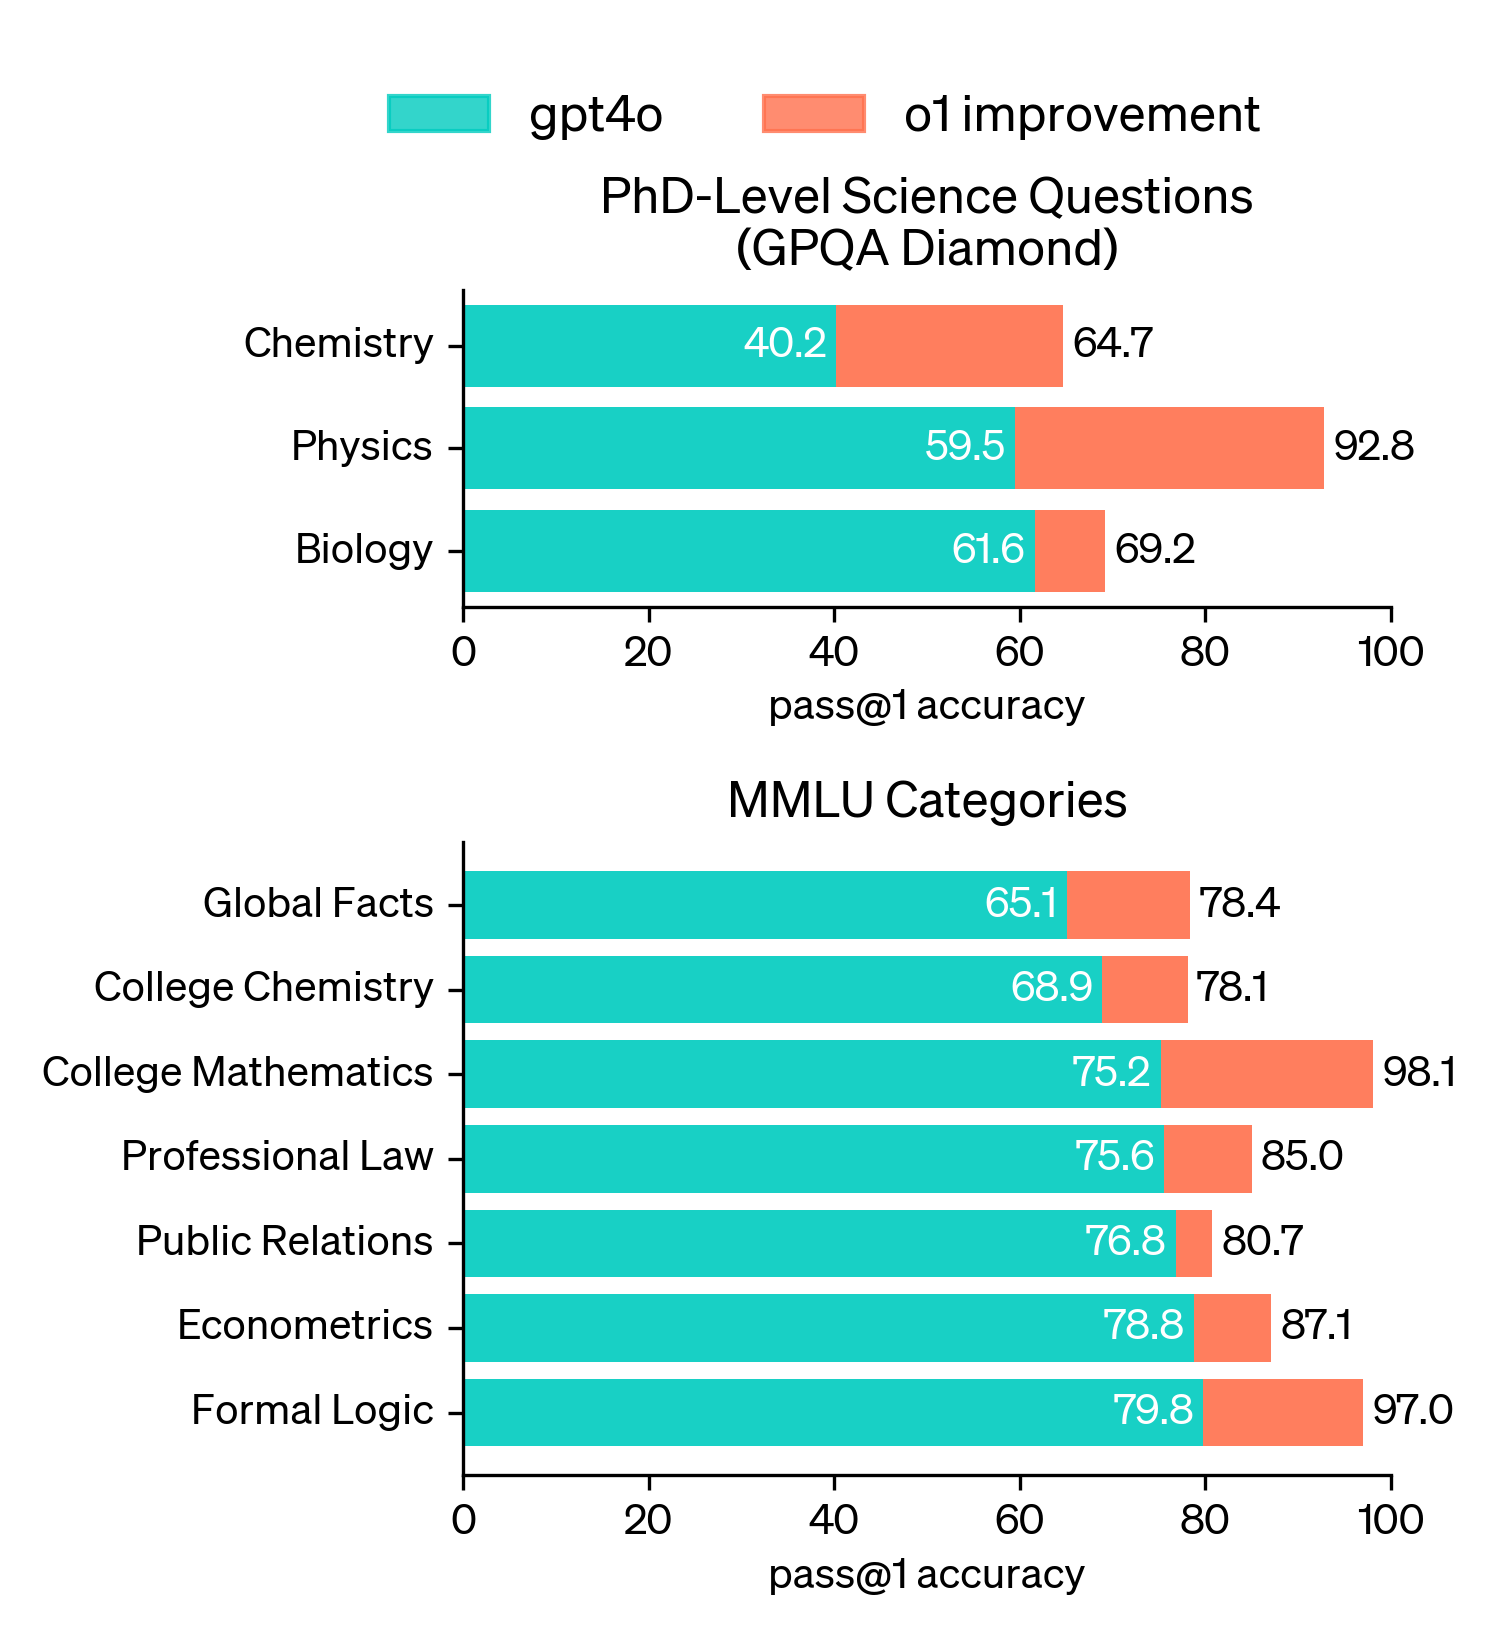
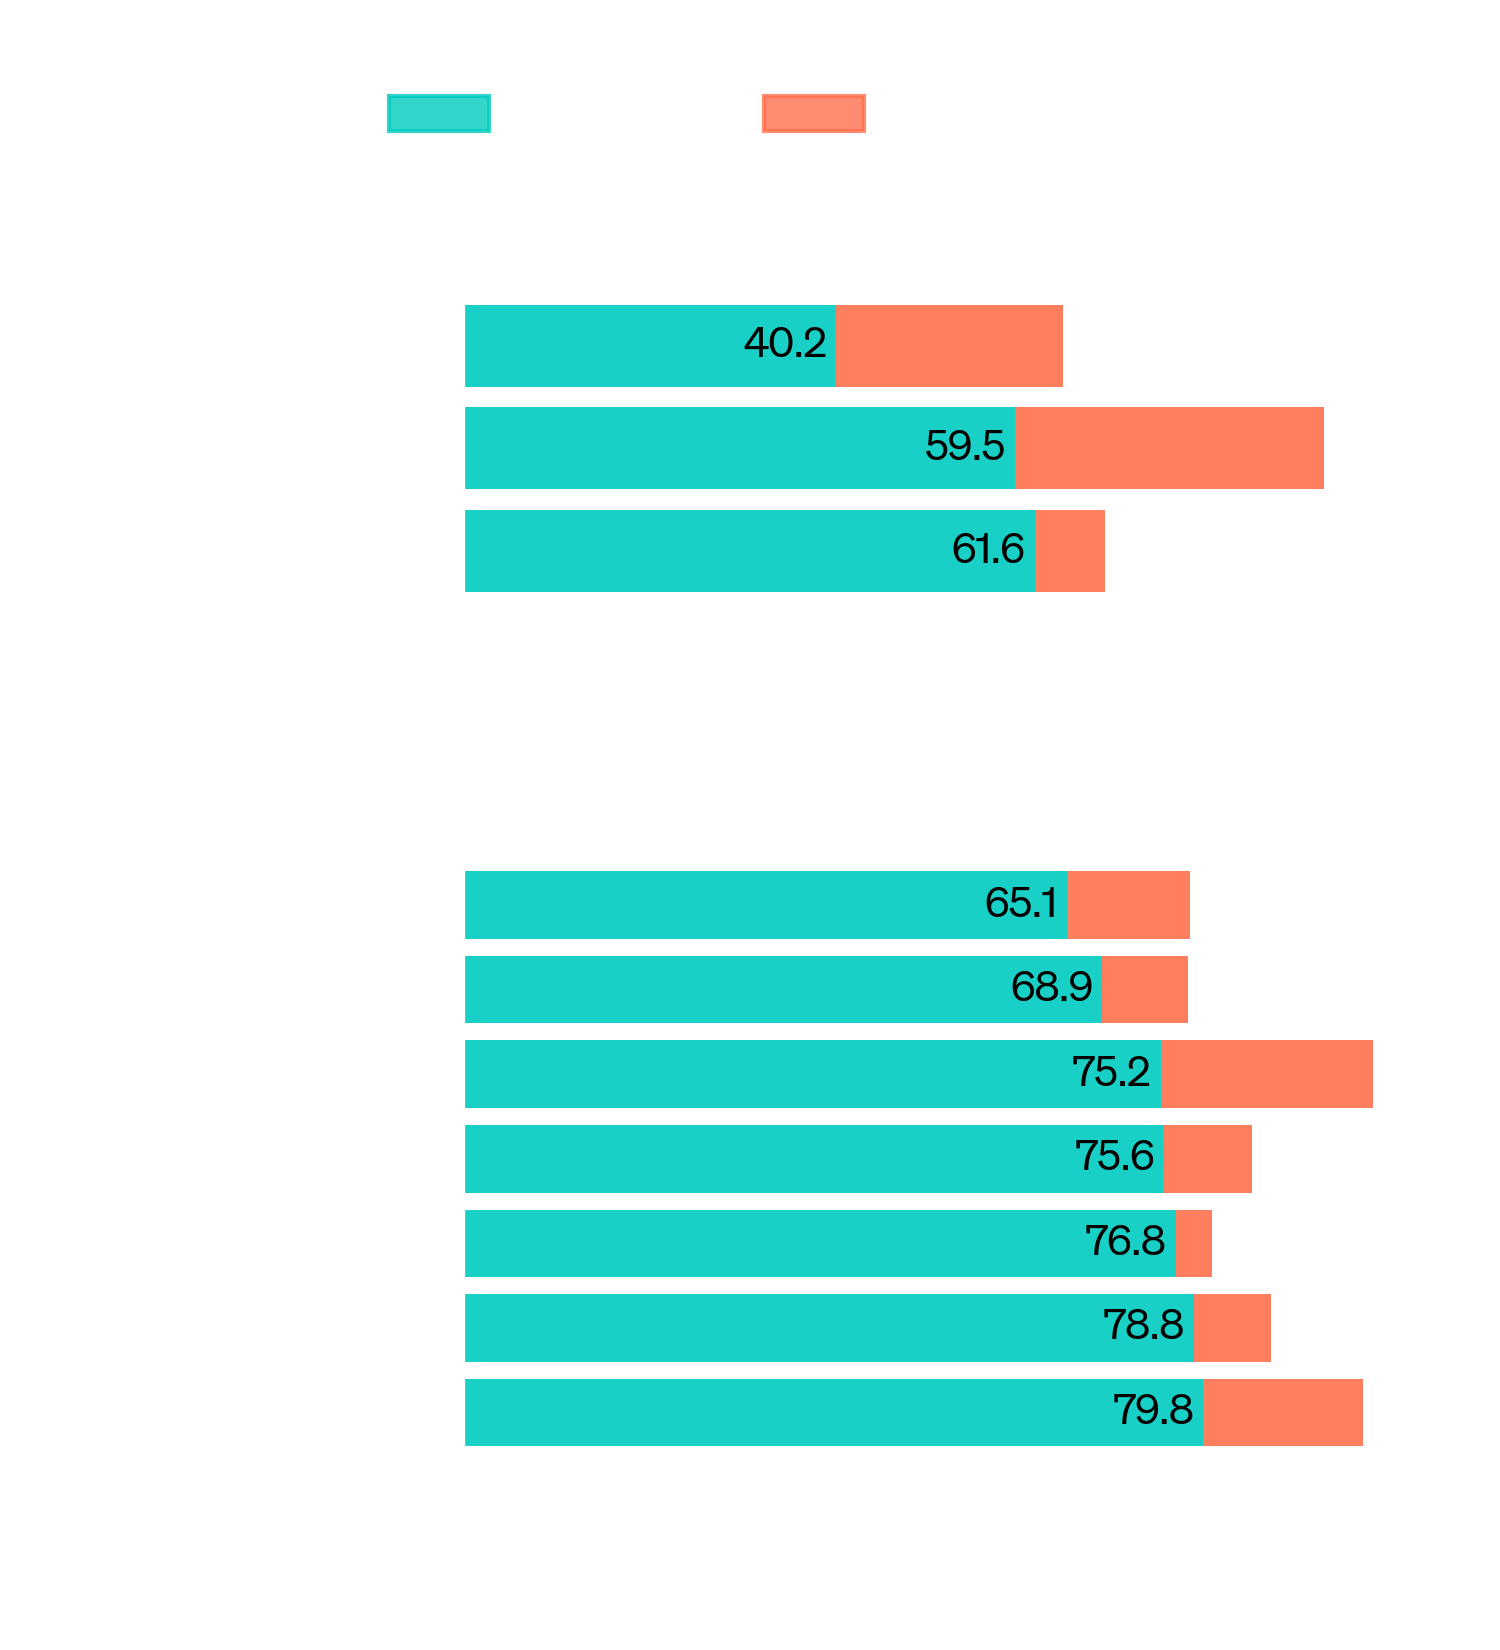
ਕਈ ਰੀਜ਼ਨਿੰਗ-ਭਾਰੀ ਬੈਂਚਮਾਰਕਾਂ ਵਿੱਚ, o1 ਮਨੁੱਖੀ ਵਿਸ਼ੇਸ਼ਗਿਆਨਾਂ ਦੇ ਪ੍ਰਦਰਸ਼ਨ ਦੀ ਬਰਾਬਰੀ ਕਰਦਾ ਹੈ. ਹਾਲੀਆ ਅਤਿ-ਆਧੁਨਿਕ ਮਾਡਲਜ਼1 MATH2 ਅਤੇ GSM8K ਉੱਤੇ ਇੰਨੇ ਵਧੀਆ ਹਨ ਕਿ ਇਹ ਬੈਂਚਮਾਰਕ ਹੁਣ ਮਾਡਲਾਂ ਵਿਚਕਾਰ ਫ਼ਰਕ ਕਰਨ ਲਈ ਪ੍ਰਭਾਵਸ਼ਾਲੀ ਨਹੀਂ ਰਹੇ. ਅਸੀਂ AIME ਉੱਤੇ ਗਣਿਤ ਪ੍ਰਦਰਸ਼ਨ ਦਾ ਮੁਲਾਂਕਣ ਕੀਤਾ, ਜੋ ਅਮਰੀਕਾ ਦੇ ਸਭ ਤੋਂ ਹੋਸ਼ਿਆਰ ਹਾਈ ਸਕੂਲ ਗਣਿਤ ਵਿਦਿਆਰਥੀਆਂ ਨੂੰ ਚੁਣੌਤੀ ਦੇਣ ਲਈ ਬਣਾਈ ਗਈ ਪਰੀਖਿਆ ਹੈ. 2024 ਦੀਆਂ AIME ਪਰੀਖਿਆਵਾਂ ਵਿੱਚ, GPT‑4o ਨੇ ਔਸਤਨ ਸਿਰਫ਼ 12% (1.8/15) ਸਮੱਸਿਆਵਾਂ ਹੱਲ ਕੀਤੀਆਂ. o1 ਨੇ ਪ੍ਰਤੀ ਸਮੱਸਿਆ ਇੱਕੋ ਸੈਂਪਲ ਨਾਲ ਔਸਤਨ 74% (11.1/15), 64 ਸੈਂਪਲਾਂ ਵਿੱਚ ਸਹਿਮਤੀ ਨਾਲ 83% (12.5/15), ਅਤੇ ਇੱਕ ਸਿੱਖੀ ਹੋਈ ਸਕੋਰਿੰਗ ਫੰਕਸ਼ਨ ਨਾਲ 1000 ਸੈਂਪਲਾਂ ਨੂੰ ਮੁੜ-ਰੈਂਕ ਕਰਨ 'ਤੇ 93% (13.9/15) ਹਾਸਲ ਕੀਤਾ. 13.9 ਦਾ ਸਕੋਰ ਇਸਨੂੰ ਦੇਸ਼-ਪੱਧਰ 'ਤੇ ਸਿਖਰਲੇ 500 ਵਿਦਿਆਰਥੀਆਂ ਵਿੱਚ ਰੱਖਦਾ ਹੈ ਅਤੇ USA Mathematical Olympiad ਦੀ ਕਟਆਫ਼ ਤੋਂ ਉੱਪਰ ਲੈ ਜਾਂਦਾ ਹੈ.
ਅਸੀਂ o1 ਦਾ GPQA diamond ਉੱਤੇ ਵੀ ਮੁਲਾਂਕਣ ਕੀਤਾ, ਜੋ ਇੱਕ ਔਖਾ ਇੰਟੈਲੀਜੈਂਸ ਬੈਂਚਮਾਰਕ ਹੈ ਅਤੇ ਰਸਾਇਣ ਵਿਗਿਆਨ, ਭੌਤਿਕ ਵਿਗਿਆਨ ਅਤੇ ਜੀਵ ਵਿਗਿਆਨ ਵਿੱਚ ਵਿਸ਼ੇਸ਼ਗਿਆਤਾ ਦੀ ਜਾਂਚ ਕਰਦਾ ਹੈ. ਮਾਡਲਾਂ ਦੀ ਮਨੁੱਖਾਂ ਨਾਲ ਤੁਲਨਾ ਕਰਨ ਲਈ, ਅਸੀਂ PhD ਵਾਲੇ ਵਿਸ਼ੇਸ਼ਗਿਆਨਾਂ ਨੂੰ GPQA-diamond ਪ੍ਰਸ਼ਨਾਂ ਦੇ ਜਵਾਬ ਦੇਣ ਲਈ ਭਰਤੀ ਕੀਤਾ. ਅਸੀਂ ਪਾਇਆ ਕਿ o1 ਨੇ ਉਹਨਾਂ ਮਨੁੱਖੀ ਵਿਸ਼ੇਸ਼ਗਿਆਨਾਂ ਦੇ ਪ੍ਰਦਰਸ਼ਨ ਨੂੰ ਪਾਰ ਕਰ ਲਿਆ, ਅਤੇ ਇਸ ਬੈਂਚਮਾਰਕ ਉੱਤੇ ਐਸਾ ਕਰਨ ਵਾਲਾ ਪਹਿਲਾ ਮਾਡਲ ਬਣ ਗਿਆ. ਇਹ ਨਤੀਜੇ ਇਹ ਨਹੀਂ ਦੱਸਦੇ ਕਿ o1 ਹਰ ਪੱਖੋਂ ਇੱਕ PhD ਨਾਲੋਂ ਵੱਧ ਸਮਰੱਥ ਹੈ, ਸਗੋਂ ਕੇਵਲ ਇਹ ਕਿ ਮਾਡਲ ਕੁਝ ਉਹਨਾਂ ਸਮੱਸਿਆਵਾਂ ਨੂੰ ਹੱਲ ਕਰਨ ਵਿੱਚ ਵੱਧ ਨਿਪੁੰਨ ਹੈ ਜਿਨ੍ਹਾਂ ਨੂੰ ਇੱਕ PhD ਤੋਂ ਹੱਲ ਕਰਨ ਦੀ ਉਮੀਦ ਕੀਤੀ ਜਾਂਦੀ ਹੈ. ਹੋਰ ਕਈ ML ਬੈਂਚਮਾਰਕਾਂ ਉੱਤੇ, o1 ਨੇ state-of-the-art ਤੋਂ ਬਿਹਤਰ ਪ੍ਰਦਰਸ਼ਨ ਕੀਤਾ. ਜਦੋਂ ਇਸ ਦੀਆਂ vision perception ਸਮਰੱਥਾਵਾਂ ਸਮਰੱਥ ਕੀਤੀਆਂ ਗਈਆਂ, o1 ਨੇ MMMU ਉੱਤੇ 78.2% ਸਕੋਰ ਕੀਤਾ, ਜਿਸ ਨਾਲ ਇਹ ਮਨੁੱਖੀ ਵਿਸ਼ੇਸ਼ਗਿਆਨਾਂ ਨਾਲ ਮੁਕਾਬਲੇਯੋਗ ਹੋਣ ਵਾਲਾ ਪਹਿਲਾ ਮਾਡਲ ਬਣਿਆ. ਇਸ ਨੇ 57 ਵਿੱਚੋਂ 54 MMLU ਉਪਸ਼੍ਰੇਣੀਆਂ ਵਿੱਚ GPT‑4o ਨਾਲੋਂ ਵੀ ਵਧੀਆ ਪ੍ਰਦਰਸ਼ਨ ਕੀਤਾ.
ਜਿਵੇਂ ਕੋਈ ਮਨੁੱਖ ਕਿਸੇ ਔਖੇ ਪ੍ਰਸ਼ਨ ਦਾ ਜਵਾਬ ਦੇਣ ਤੋਂ ਪਹਿਲਾਂ ਲੰਮਾ ਸਮਾਂ ਸੋਚ ਸਕਦਾ ਹੈ, ਉਸੇ ਤਰ੍ਹਾਂ o1 ਕਿਸੇ ਸਮੱਸਿਆ ਨੂੰ ਹੱਲ ਕਰਨ ਦੀ ਕੋਸ਼ਿਸ਼ ਕਰਦੇ ਸਮੇਂ ਵਿਚਾਰ ਲੜੀ ਦੀ ਵਰਤੋਂ ਕਰਦਾ ਹੈ. ਰੀਇਨਫੋਰਸਮੈਂਟ ਲਰਨਿੰਗ ਰਾਹੀਂ, o1 ਆਪਣੀ ਵਿਚਾਰ ਲੜੀ ਨੂੰ ਨਿਖਾਰਨਾ ਅਤੇ ਵਰਤੀ ਜਾਣ ਵਾਲੀਆਂ ਰਣਨੀਤੀਆਂ ਨੂੰ ਸੁਧਾਰਨਾ ਸਿੱਖਦਾ ਹੈ. ਇਹ ਆਪਣੀਆਂ ਗਲਤੀਆਂ ਨੂੰ ਪਛਾਣਣਾ ਅਤੇ ਠੀਕ ਕਰਨਾ ਸਿੱਖਦਾ ਹੈ. ਇਹ ਔਖੇ ਕਦਮਾਂ ਨੂੰ ਹੋਰ ਸਰਲ ਕਦਮਾਂ ਵਿੱਚ ਵੰਡਣਾ ਸਿੱਖਦਾ ਹੈ. ਜਦੋਂ ਮੌਜੂਦਾ ਤਰੀਕਾ ਕੰਮ ਨਹੀਂ ਕਰਦਾ, ਇਹ ਵੱਖਰਾ ਤਰੀਕਾ ਅਪਣਾਉਣਾ ਸਿੱਖਦਾ ਹੈ. ਇਹ ਪ੍ਰਕਿਰਿਆ ਮਾਡਲ ਦੀ ਰੀਜ਼ਨ ਕਰਨ ਦੀ ਸਮਰੱਥਾ ਨੂੰ ਨਾਟਕੀ ਢੰਗ ਨਾਲ ਸੁਧਾਰਦੀ ਹੈ. ਇਸ ਵੱਡੀ ਤਰੱਕੀ ਨੂੰ ਦਰਸਾਉਣ ਲਈ, ਅਸੀਂ ਹੇਠਾਂ ਕਈ ਔਖੀਆਂ ਸਮੱਸਿਆਵਾਂ ਉੱਤੇ o1‑preview ਦੀ ਵਿਚਾਰ ਲੜੀ ਦਿਖਾ ਰਹੇ ਹਾਂ.
ਅਸੀਂ o1 ਤੋਂ ਸ਼ੁਰੂਆਤ ਕਰਕੇ ਅਤੇ ਪ੍ਰੋਗ੍ਰਾਮਿੰਗ ਹੁਨਰਾਂ ਨੂੰ ਹੋਰ ਸੁਧਾਰਣ ਲਈ ਟ੍ਰੇਨਿੰਗ ਦੇ ਕੇ ਇੱਕ ਐਸਾ ਮਾਡਲ ਤਿਆਰ ਕੀਤਾ ਜਿਸ ਨੇ 2024 ਦੀ International Olympiad in Informatics (IOI) ਵਿੱਚ 213 ਅੰਕ ਪ੍ਰਾਪਤ ਕੀਤੇ ਅਤੇ 49ਵੇਂ ਪ੍ਰਤੀਸ਼ਤਕ ਵਿੱਚ ਰੈਂਕ ਕੀਤਾ. ਇਸ ਮਾਡਲ ਨੇ 2024 IOI ਵਿੱਚ ਮਨੁੱਖੀ ਪ੍ਰਤੀਯੋਗੀਆਂ ਵਾਲੀਆਂ ਹੀ ਸ਼ਰਤਾਂ ਹੇਠ ਮੁਕਾਬਲਾ ਕੀਤਾ. ਇਸਨੂੰ ਛੇ ਚੁਣੌਤੀਪੂਰਨ ਐਲਗੋਰਿਦਮਿਕ ਸਮੱਸਿਆਵਾਂ ਹੱਲ ਕਰਨ ਲਈ ਦਸ ਘੰਟੇ ਮਿਲੇ ਅਤੇ ਪ੍ਰਤੀ ਸਮੱਸਿਆ 50 ਸਬਮਿਸ਼ਨ ਦੀ ਇਜਾਜ਼ਤ ਸੀ.
ਹਰ ਸਮੱਸਿਆ ਲਈ, ਸਾਡੇ ਸਿਸਟਮ ਨੇ ਕਈ ਸੰਭਾਵੀ ਸਬਮਿਸ਼ਨ ਸੈਂਪਲ ਕੀਤੇ ਅਤੇ ਟੈਸਟ-ਟਾਈਮ ਚੋਣ ਰਣਨੀਤੀ ਦੇ ਆਧਾਰ 'ਤੇ ਉਨ੍ਹਾਂ ਵਿੱਚੋਂ 50 ਸਬਮਿਟ ਕੀਤੇ. ਸਬਮਿਸ਼ਨ IOI ਦੇ ਪਬਲਿਕ ਟੈਸਟ ਕੇਸਾਂ, ਮਾਡਲ-ਤਿਆਰ ਟੈਸਟ ਕੇਸਾਂ ਅਤੇ ਇੱਕ ਸਿੱਖੀ ਹੋਈ ਸਕੋਰਿੰਗ ਫੰਕਸ਼ਨ ਉੱਤੇ ਪ੍ਰਦਰਸ਼ਨ ਦੇ ਆਧਾਰ 'ਤੇ ਚੁਣੇ ਗਏ. ਜੇ ਅਸੀਂ ਇਸ ਦੀ ਬਜਾਏ ਰੈਂਡਮ ਤੌਰ 'ਤੇ ਸਬਮਿਟ ਕੀਤਾ ਹੁੰਦਾ, ਤਾਂ ਅਸੀਂ ਔਸਤਨ ਸਿਰਫ਼ 156 ਅੰਕ ਹੀ ਹਾਸਲ ਕਰਦੇ, ਜੋ ਦਰਸਾਉਂਦਾ ਹੈ ਕਿ ਮੁਕਾਬਲੇ ਦੀਆਂ ਪਾਬੰਦੀਆਂ ਹੇਠ ਇਹ ਰਣਨੀਤੀ ਲਗਭਗ 60 ਅੰਕਾਂ ਦੇ ਬਰਾਬਰ ਸੀ.
ਹਲਕੀ ਸਬਮਿਸ਼ਨ ਪਾਬੰਦੀ ਨਾਲ, ਅਸੀਂ ਪਾਇਆ ਕਿ ਮਾਡਲ ਦਾ ਪ੍ਰਦਰਸ਼ਨ ਕਾਫ਼ੀ ਬਿਹਤਰ ਹੋ ਗਿਆ. ਜਦੋਂ ਪ੍ਰਤੀ ਸਮੱਸਿਆ 10,000 ਸਬਮਿਸ਼ਨ ਦੀ ਇਜਾਜ਼ਤ ਦਿੱਤੀ ਗਈ, ਮਾਡਲ ਨੇ 362.14 ਦਾ ਸਕੋਰ ਹਾਸਲ ਕੀਤਾ – ਗੋਲਡ ਮੈਡਲ ਸੀਮਾ ਤੋਂ ਉੱਪਰ – ਅਤੇ ਇਹ ਵੀ ਬਿਨਾਂ ਕਿਸੇ ਟੈਸਟ-ਟਾਈਮ ਚੋਣ ਰਣਨੀਤੀ ਦੇ.
ਅੰਤ ਵਿੱਚ, ਇਸ ਮਾਡਲ ਦੀ ਕੋਡਿੰਗ ਕੁਸ਼ਲਤਾ ਦਿਖਾਉਣ ਲਈ ਅਸੀਂ Codeforces ਵੱਲੋਂ ਹੋਸਟ ਕੀਤੀਆਂ ਮੁਕਾਬਲਾਤੀ ਪ੍ਰੋਗ੍ਰਾਮਿੰਗ ਪ੍ਰਤੀਯੋਗਿਤਾਵਾਂ ਦਾ ਸਿਮੂਲੇਸ਼ਨ ਕੀਤਾ. ਸਾਡੇ ਮੁਲਾਂਕਣ ਮੁਕਾਬਲੇ ਦੇ ਨਿਯਮਾਂ ਨਾਲ ਬਹੁਤ ਨੇੜੇ ਸਨ ਅਤੇ 10 ਸਬਮਿਸ਼ਨ ਦੀ ਇਜਾਜ਼ਤ ਦਿੰਦੇ ਸਨ. GPT‑4o ਨੇ 808 ਦੀ Elo ਰੇਟਿੰਗ3 ਹਾਸਲ ਕੀਤੀ, ਜੋ ਮਨੁੱਖੀ ਪ੍ਰਤੀਯੋਗੀਆਂ ਦੇ 11ਵੇਂ ਪ੍ਰਤੀਸ਼ਤਕ ਵਿੱਚ ਆਉਂਦੀ ਹੈ. ਇਹ ਮਾਡਲ GPT‑4o ਅਤੇ o1 ਦੋਹਾਂ ਨਾਲੋਂ ਕਾਫ਼ੀ ਅੱਗੇ ਨਿਕਲ ਗਿਆ. ਇਸ ਨੇ 1807 ਦੀ Elo ਰੇਟਿੰਗ ਹਾਸਲ ਕੀਤੀ, ਅਤੇ 93% ਪ੍ਰਤੀਯੋਗੀਆਂ ਨਾਲੋਂ ਬਿਹਤਰ ਪ੍ਰਦਰਸ਼ਨ ਕੀਤਾ.

Further fine-tuning on programming competitions improves o1. The improved model ranked in the 49th percentile in the 2024 International Olympiad in Informatics under competition rules.
ਪਰੀਖਿਆਵਾਂ ਅਤੇ ਅਕਾਦਮਿਕ ਬੈਂਚਮਾਰਕਾਂ ਤੋਂ ਇਲਾਵਾ, ਅਸੀਂ ਕਈ ਖੇਤਰਾਂ ਵਿੱਚ ਚੁਣੌਤੀਪੂਰਨ, ਖੁੱਲ੍ਹੇ ਅੰਤ ਵਾਲੇ ਪ੍ਰੌੰਪਟਾਂ ਉੱਤੇ o1‑preview ਅਤੇ GPT‑4o ਲਈ ਮਨੁੱਖੀ ਪਸੰਦ ਦਾ ਵੀ ਮੁਲਾਂਕਣ ਕੀਤਾ. ਇਸ ਮੁਲਾਂਕਣ ਵਿੱਚ, ਮਨੁੱਖੀ ਟ੍ਰੇਨਰਾਂ ਨੂੰ o1‑preview ਅਤੇ GPT‑4o ਵੱਲੋਂ ਕਿਸੇ ਪ੍ਰੌੰਪਟ ਲਈ ਦਿੱਤੇ ਗਏ ਅਗਿਆਤ ਜਵਾਬ ਦਿਖਾਏ ਗਏ ਅਤੇ ਉਨ੍ਹਾਂ ਨੇ ਵੋਟ ਦਿੱਤੀ ਕਿ ਉਹ ਕਿਹੜਾ ਜਵਾਬ ਪਸੰਦ ਕਰਦੇ ਹਨ. ਡਾਟਾ ਵਿਸ਼ਲੇਸ਼ਣ, ਕੋਡਿੰਗ ਅਤੇ ਗਣਿਤ ਵਰਗੀਆਂ ਰੀਜ਼ਨਿੰਗ-ਭਾਰੀ ਸ਼੍ਰੇਣੀਆਂ ਵਿੱਚ o1‑preview ਨੂੰ gpt-4o ਉੱਤੇ ਵੱਡੇ ਅੰਤਰ ਨਾਲ ਤਰਜੀਹ ਦਿੱਤੀ ਜਾਂਦੀ ਹੈ. ਹਾਲਾਂਕਿ, ਕੁਝ ਨੈਚਰਲ ਲੈਂਗਵੇਜ ਟਾਸਕਾਂ ਵਿੱਚ o1‑preview ਨੂੰ ਤਰਜੀਹ ਨਹੀਂ ਦਿੱਤੀ ਜਾਂਦੀ, ਜੋ ਦਰਸਾਉਂਦਾ ਹੈ ਕਿ ਇਹ ਹਰ ਵਰਤੋਂ ਮਾਮਲੇ ਲਈ ਉਚਿਤ ਨਹੀਂ ਹੈ.

ਵਿਚਾਰ ਲੜੀ ਰੀਜ਼ਨਿੰਗ ਐਲਾਇਨਮੈਂਟ ਅਤੇ ਸੁਰੱਖਿਆ ਲਈ ਨਵੇਂ ਮੌਕੇ ਪ੍ਰਦਾਨ ਕਰਦੀ ਹੈ. ਅਸੀਂ ਪਾਇਆ ਕਿ ਰੀਜ਼ਨਿੰਗ ਮਾਡਲ ਦੀ ਵਿਚਾਰ ਲੜੀ ਵਿੱਚ ਮਾਡਲ ਵਿਹਾਰ ਲਈ ਆਪਣੀਆਂ ਨੀਤੀਆਂ ਨੂੰ ਇਕਸਾਰ ਕਰਨਾ ਮਨੁੱਖੀ ਮੁੱਲਾਂ ਅਤੇ ਸਿਧਾਂਤਾਂ ਨੂੰ ਮਜ਼ਬੂਤੀ ਨਾਲ ਸਿਖਾਉਣ ਦਾ ਇੱਕ ਪ੍ਰਭਾਵਸ਼ਾਲੀ ਤਰੀਕਾ ਹੈ. ਮਾਡਲ ਨੂੰ ਸਾਡੇ ਸੁਰੱਖਿਆ ਨਿਯਮ ਅਤੇ ਸੰਦਰਭ ਵਿੱਚ ਉਨ੍ਹਾਂ ਬਾਰੇ ਰੀਜ਼ਨ ਕਰਨਾ ਸਿਖਾ ਕੇ, ਅਸੀਂ ਸਬੂਤ ਵੇਖੇ ਕਿ ਰੀਜ਼ਨਿੰਗ ਸਮਰੱਥਾ ਸਿੱਧੇ ਤੌਰ 'ਤੇ ਮਾਡਲ ਦੀ ਮਜ਼ਬੂਤੀ ਨੂੰ ਲਾਭ ਪਹੁੰਚਾਉਂਦੀ ਹੈ: o1‑preview ਨੇ ਮਹੱਤਵਪੂਰਨ jailbreak ਮੁਲਾਂਕਣਾਂ ਅਤੇ ਆਪਣੇ ਮਾਡਲ ਦੀ ਸੁਰੱਖਿਆ refusal boundaries ਦਾ ਮੁਲਾਂਕਣ ਕਰਨ ਲਈ ਸਾਡੇ ਸਭ ਤੋਂ ਔਖੇ ਅੰਦਰੂਨੀ ਬੈਂਚਮਾਰਕਾਂ ਉੱਤੇ ਕਾਫ਼ੀ ਸੁਧਾਰਿਆ ਪ੍ਰਦਰਸ਼ਨ ਹਾਸਲ ਕੀਤਾ. ਸਾਡਾ ਮੰਨਣਾ ਹੈ ਕਿ ਵਿਚਾਰ ਲੜੀ ਦੀ ਵਰਤੋਂ ਸੁਰੱਖਿਆ ਅਤੇ ਐਲਾਇਨਮੈਂਟ ਲਈ ਮਹੱਤਵਪੂਰਨ ਤਰੱਕੀਆਂ ਦਿੰਦੀ ਹੈ ਕਿਉਂਕਿ (1) ਇਹ ਸਾਨੂੰ ਮਾਡਲ ਦੀ ਸੋਚ ਨੂੰ ਸਮਝ ਆਉਣਯੋਗ ਢੰਗ ਨਾਲ ਦੇਖਣ ਦੀ ਸਮਰੱਥਾ ਦਿੰਦੀ ਹੈ, ਅਤੇ (2) ਸੁਰੱਖਿਆ ਨਿਯਮਾਂ ਬਾਰੇ ਮਾਡਲ ਦੀ ਰੀਜ਼ਨਿੰਗ out-of-distribution ਸਥਿਤੀਆਂ ਵਿੱਚ ਵੱਧ ਮਜ਼ਬੂਤ ਹੁੰਦੀ ਹੈ.
ਆਪਣੇ ਸੁਧਾਰਾਂ ਨੂੰ stress-test ਕਰਨ ਲਈ, ਅਸੀਂ deployment ਤੋਂ ਪਹਿਲਾਂ ਪ੍ਰਿਪੇਅਰਡਨੈਸ ਫ੍ਰੇਮਵਰਕ(ਨਵੀਂ ਵਿੰਡੋ ਵਿੱਚ ਖੁੱਲ੍ਹਦਾ ਹੈ) ਦੇ ਅਨੁਸਾਰ ਸੁਰੱਖਿਆ ਟੈਸਟਾਂ ਅਤੇ red-teaming ਦਾ ਇੱਕ ਸੈੱਟ ਚਲਾਇਆ. ਅਸੀਂ ਪਾਇਆ ਕਿ ਵਿਚਾਰ ਲੜੀ ਰੀਜ਼ਨਿੰਗ ਨੇ ਸਾਡੇ ਮੁਲਾਂਕਣਾਂ ਵਿੱਚ ਸਮਰੱਥਾ ਸੁਧਾਰਾਂ ਵਿੱਚ ਯੋਗਦਾਨ ਪਾਇਆ. ਖ਼ਾਸ ਤੌਰ 'ਤੇ, ਅਸੀਂ reward hacking ਦੇ ਦਿਲਚਸਪ ਉਦਾਹਰਨਾਂ(ਨਵੀਂ ਵਿੰਡੋ ਵਿੱਚ ਖੁੱਲ੍ਹਦਾ ਹੈ) ਵੇਖੀਆਂ. ਇਨ੍ਹਾਂ ਮੁਲਾਂਕਣਾਂ ਦੇ ਵਿਸਤ੍ਰਿਤ ਨਤੀਜੇ ਨਾਲ ਲੱਗੇ ਹੋਏ ਸਿਸਟਮ ਕਾਰਡ ਵਿੱਚ ਮਿਲ ਸਕਦੇ ਹਨ.
| ਮੈਟ੍ਰਿਕ | GPT-4o | o1-preview |
|---|---|---|
| ਨੁਕਸਾਨਦੇਹ ਪ੍ਰੋਂਪਟਾਂ 'ਤੇ % ਸੁਰੱਖਿਅਤ ਜਵਾਬ ਮਿਆਰੀ | 0.990 | 0.995 |
| ਨੁਕਸਾਨਦੇਹ ਪ੍ਰੋਂਪਟਾਂ 'ਤੇ % ਸੁਰੱਖਿਅਤ ਜਵਾਬ ਚੁਣੌਤੀਪੂਰਨ: ਜੇਲਬ੍ਰੇਕ ਅਤੇ ਗੁੰਝਲਦਾਰ ਮਾਮਲੇ | 0.714 | 0.934 |
| ↳ ਪਰੇਸ਼ਾਨੀ (ਗੰਭੀਰ) | 0.845 | 0.900 |
| ↳ ਸ਼ੋਸ਼ਣਕਾਰੀ ਯੌਨ ਸਮੱਗਰੀ | 0.483 | 0.949 |
| ↳ ਨਾਬਾਲਗਾਂ ਨਾਲ ਸੰਬੰਧਿਤ ਯੌਨ ਸਮੱਗਰੀ | 0.707 | 0.931 |
| ↳ ਅਹਿੰਸਕ ਗਲਤ ਕੰਮ ਬਾਰੇ ਸਲਾਹ | 0.688 | 0.961 |
| ↳ ਹਿੰਸਕ ਗਲਤ ਕੰਮਾਂ ਬਾਰੇ ਸਲਾਹ | 0.778 | 0.963 |
| WildChat ਵਿੱਚ ਪ੍ਰਤੀ ਸ਼੍ਰੇਣੀ ਸਭ ਤੋਂ ਉੱਚੇ Moderation API ਸਕੋਰਾਂ ਵਾਲੇ ਚੋਟੀ ਦੇ 200 ਲਈ % ਸੁਰੱਖਿਅਤ ਜਵਾਬ Zhao, et al. 2024 | 0.945 | 0.971 |
| Goodness@0.1 StrongREJECT ਜੇਲਬ੍ਰੇਕ ਮੁਲਾਂਕਣ Souly et al. 2024 | 0.220 | 0.840 |
| ਮਨੁੱਖੀ ਸਰੋਤਾਂ ਤੋਂ ਪ੍ਰਾਪਤ ਜੇਲਬ੍ਰੇਕ ਮੁਲਾਂਕਣ | 0.770 | 0.960 |
| ਅੰਦਰੂਨੀ ਨਿਰਦੋਸ਼ ਐਜ ਕੇਸਾਂ 'ਤੇ % ਪਾਲਣਾ “ਬਿਨਾਂ ਵਜ੍ਹਾ ਇਨਕਾਰ ਨਾ ਕਰਨਾ” | 0.910 | 0.930 |
| XSTest ਵਿੱਚ ਸਾਧਾਰਨ ਮਾਮਲਿਆਂ 'ਤੇ % ਅਨੁਕੂਲਤਾ “ਬਿਨਾਂ ਵਜ੍ਹਾ ਇਨਕਾਰ ਨਹੀਂ” Röttger, et al. 2023 | 0.924 | 0.976 |
ਸਾਡਾ ਮੰਨਣਾ ਹੈ ਕਿ ਲੁਕਾਈ ਹੋਈ ਵਿਚਾਰ ਲੜੀ ਮਾਡਲਾਂ ਦੀ ਨਿਗਰਾਨੀ ਲਈ ਇੱਕ ਵਿਲੱਖਣ ਮੌਕਾ ਪੇਸ਼ ਕਰਦੀ ਹੈ. ਇਹ ਮੰਨਦਿਆਂ ਕਿ ਇਹ faithful ਅਤੇ legible ਹੈ, ਲੁਕਾਈ ਹੋਈ ਵਿਚਾਰ ਲੜੀ ਸਾਨੂੰ ਮਾਡਲ ਦਾ “ਮਨ ਪੜ੍ਹਨ” ਅਤੇ ਇਸ ਦੀ ਸੋਚ ਪ੍ਰਕਿਰਿਆ ਨੂੰ ਸਮਝਣ ਦੀ ਆਗਿਆ ਦਿੰਦੀ ਹੈ. ਉਦਾਹਰਨ ਲਈ, ਭਵਿੱਖ ਵਿੱਚ ਅਸੀਂ ਯੂਜ਼ਰ ਨਾਲ ਹੇਰਾਫੇਰੀ ਦੇ ਸੰਕੇਤਾਂ ਲਈ ਵਿਚਾਰ ਲੜੀ ਦੀ ਨਿਗਰਾਨੀ ਕਰਨਾ ਚਾਹ ਸਕਦੇ ਹਾਂ. ਹਾਲਾਂਕਿ, ਇਸ ਦੇ ਕੰਮ ਕਰਨ ਲਈ ਮਾਡਲ ਕੋਲ ਆਪਣੇ ਵਿਚਾਰਾਂ ਨੂੰ ਬਿਨਾਂ ਬਦਲਾਅ ਦੇ ਰੂਪ ਵਿੱਚ ਪ੍ਰਗਟ ਕਰਨ ਦੀ ਆਜ਼ਾਦੀ ਹੋਣੀ ਚਾਹੀਦੀ ਹੈ, ਇਸ ਲਈ ਅਸੀਂ ਵਿਚਾਰ ਲੜੀ ਉੱਤੇ ਕੋਈ ਵੀ policy compliance ਜਾਂ ਯੂਜ਼ਰ ਪਸੰਦਾਂ ਟ੍ਰੇਨ ਨਹੀਂ ਕਰ ਸਕਦੇ. ਅਸੀਂ ਇਹ ਵੀ ਨਹੀਂ ਚਾਹੁੰਦੇ ਕਿ ਇੱਕ unaligned ਵਿਚਾਰ ਲੜੀ ਸਿੱਧੇ ਤੌਰ 'ਤੇ ਯੂਜ਼ਰਾਂ ਨੂੰ ਦਿਖਾਈ ਜਾਵੇ.
ਇਸ ਲਈ, ਯੂਜ਼ਰ ਅਨੁਭਵ, ਮੁਕਾਬਲਾਤੀ ਲਾਭ ਅਤੇ ਵਿਚਾਰ ਲੜੀ ਨਿਗਰਾਨੀ ਦੀ ਸੰਭਾਵਨਾ ਸਮੇਤ ਕਈ ਕਾਰਕਾਂ ਨੂੰ ਤੋਲਣ ਤੋਂ ਬਾਅਦ, ਅਸੀਂ ਯੂਜ਼ਰਾਂ ਨੂੰ ਕੱਚੀਆਂ ਵਿਚਾਰ ਲੜੀਆਂ ਨਾ ਦਿਖਾਉਣ ਦਾ ਫ਼ੈਸਲਾ ਕੀਤਾ ਹੈ. ਅਸੀਂ ਮੰਨਦੇ ਹਾਂ ਕਿ ਇਸ ਫ਼ੈਸਲੇ ਦੇ ਨੁਕਸਾਨ ਵੀ ਹਨ. ਅਸੀਂ ਇਸ ਦੀ ਕੁਝ ਹੱਦ ਤੱਕ ਭਰਪਾਈ ਕਰਨ ਲਈ ਮਾਡਲ ਨੂੰ ਜਵਾਬ ਵਿੱਚ ਵਿਚਾਰ ਲੜੀ ਤੋਂ ਕੋਈ ਵੀ ਲਾਭਕਾਰੀ ਵਿਚਾਰ ਦੁਹਰਾਉਣਾ ਸਿਖਾਉਣ ਦੀ ਕੋਸ਼ਿਸ਼ ਕਰਦੇ ਹਾਂ. o1 ਮਾਡਲ ਸ੍ਰੇਣੀ ਲਈ ਅਸੀਂ ਵਿਚਾਰ ਲੜੀ ਦਾ ਮਾਡਲ-ਤਿਆਰ ਸਾਰ ਦਿਖਾਉਂਦੇ ਹਾਂ.
o1 AI ਰੀਜ਼ਨਿੰਗ ਵਿੱਚ state-of-the-art ਨੂੰ ਮਹੱਤਵਪੂਰਨ ਤੌਰ 'ਤੇ ਅੱਗੇ ਵਧਾਉਂਦਾ ਹੈ. ਅਸੀਂ ਇਸ ਮਾਡਲ ਦੇ ਸੁਧਾਰੇ ਹੋਏ ਸੰਸਕਰਨ ਜਾਰੀ ਕਰਨ ਦੀ ਯੋਜਨਾ ਬਣਾਈ ਹੈ ਜਿਵੇਂ ਜਿਵੇਂ ਅਸੀਂ ਇਸ ਨੂੰ ਹੋਰ ਦੁਹਰਾਉਂਦੇ ਰਹਾਂਗੇ. ਸਾਨੂੰ ਉਮੀਦ ਹੈ ਕਿ ਇਹ ਨਵੀਆਂ ਰੀਜ਼ਨਿੰਗ ਸਮਰੱਥਾਵਾਂ ਮਾਡਲਾਂ ਨੂੰ ਮਨੁੱਖੀ ਮੁੱਲਾਂ ਅਤੇ ਸਿਧਾਂਤਾਂ ਨਾਲ ਐਲਾਇਨ ਕਰਨ ਦੀ ਸਾਡੀ ਸਮਰੱਥਾ ਨੂੰ ਬਿਹਤਰ ਕਰਨਗੀਆਂ. ਸਾਡਾ ਮੰਨਣਾ ਹੈ ਕਿ o1 – ਅਤੇ ਇਸ ਦੇ ਉੱਤਰਾਧਿਕਾਰੀ – ਵਿਗਿਆਨ, ਕੋਡਿੰਗ, ਗਣਿਤ ਅਤੇ ਸੰਬੰਧਿਤ ਖੇਤਰਾਂ ਵਿੱਚ AI ਲਈ ਕਈ ਨਵੇਂ ਵਰਤੋਂ ਮਾਮਲੇ ਖੋਲ੍ਹਣਗੇ. ਅਸੀਂ ਉਤਸ਼ਾਹਿਤ ਹਾਂ ਕਿ ਯੂਜ਼ਰ ਅਤੇ API ਡਿਵੈਲਪਰ ਖੋਜਣ ਕਿ ਇਹ ਉਨ੍ਹਾਂ ਦੇ ਰੋਜ਼ਾਨਾ ਕੰਮ ਨੂੰ ਕਿਵੇਂ ਬਿਹਤਰ ਕਰ ਸਕਦਾ ਹੈ.
| ਡੇਟਾਸੈੱਟ | ਮੈਟ੍ਰਿਕ | gpt-4o | o1-preview | o1 |
|---|---|---|---|---|
| ਮੁਕਾਬਲਾਤੀ ਗਣਿਤ AIME (2024) | cons@64 | 13.4 | 56.7 | 83.3 |
| pass@1 | 9.3 | 44.6 | 74.4 | |
| ਮੁਕਾਬਲਾ ਕੋਡ CodeForces | Elo | 808 | 1,258 | 1,673 |
| ਪ੍ਰਤੀਸ਼ਤ | 11.0 | 62.0 | 89.0 | |
| GPQA Diamond | cons@64 | 56.1 | 78.3 | 78.0 |
| pass@1 | 50.6 | 73.3 | 77.3 | |
| ਜੀਵ ਵਿਗਿਆਨ | cons@64 | 63.2 | 73.7 | 68.4 |
| pass@1 | 61.6 | 65.9 | 69.2 | |
| ਰਸਾਇਣ ਵਿਗਿਆਨ | cons@64 | 43.0 | 60.2 | 65.6 |
| pass@1 | 40.2 | 59.9 | 64.7 | |
| ਭੌਤਿਕ ਵਿਗਿਆਨ | cons@64 | 68.6 | 89.5 | 94.2 |
| pass@1 | 59.5 | 89.4 | 92.8 | |
| ਗਣਿਤ | pass@1 | 60.3 | 85.5 | 94.8 |
| MMLU | pass@1 | 88.0 | 92.3 | 90.8 |
| MMMU (ਮੁਲਾਂਕਣ) | pass@1 | 69.1 | ਲਾਗੂ ਨਹੀਂ | 78.2 |
| MathVista (testmini) | pass@1 | 63.8 | ਲਾਗੂ ਨਹੀਂ | 73.9 |
ਲੇਖਕ
ਹਵਾਲੇ
- 1
- 2
ਸਾਡੇ ਮੁਲਾਂਕਣਾਂ ਵਿੱਚ ਉਹੀ 500-ਸਮੱਸਿਆ ਟੈਸਟ ਸਪਲਿਟ ਵਰਤੀ ਗਈ ਜੋ https://arxiv.org/abs/2305.20050(ਨਵੀਂ ਵਿੰਡੋ ਵਿੱਚ ਖੁੱਲ੍ਹਦਾ ਹੈ) ਵਿੱਚ ਮਿਲਦੀ ਹੈ
- 3