OpenAI o1 သည် competitive programming မေးခွန်းများ (Codeforces) တွင် 89th percentile အဆင့်ရရှိပြီး၊ USA Math Olympiad (AIME) အတွက် qualifier တစ်ခုတွင် US အတွင်း ထိပ်တန်း ကျောင်းသား 500 အတွင်း ဝင်ရောက်ကာ၊ physics၊ biology နှင့် chemistry ပြဿနာများ benchmark (GPQA) ပေါ်တွင် လူသား PhD အဆင့် တိကျမှုထက် ပိုမိုကောင်းမွန်သည်။ ဤမော်ဒယ်အသစ်ကို လက်ရှိ မော်ဒယ်များကဲ့သို့ သုံးရလွယ်ကူစေရန် လိုအပ်သော အလုပ်များကို ဆက်လက်လုပ်ဆောင်နေဆဲဖြစ်သော်လည်း၊ ဤမော်ဒယ်၏ အစောပိုင်းဗားရှင်းဖြစ်သော OpenAI o1‑preview ကို ChatGPT နှင့် ယုံကြည်ရသော API အသုံးပြုသူများ(ဝင်းဒိုးအသစ်တွင် ဖွင့်မည်) အတွက် ချက်ချင်းအသုံးပြုနိုင်ရန် ထုတ်ပေးနေပါသည်။
ကျွန်ုပ်တို့၏ အကြီးစား အားဖြည့် သင်ယူလေ့လာခြင်း algorithm သည် data-efficient မြင့်မားသော training process တစ်ခုအတွင်း မော်ဒယ်အား ၎င်း၏ chain of thought ကို အသုံးပြု၍ ထိရောက်စွာ စဉ်းစားတတ်ပုံကို သင်ကြားပေးသည်။ o1 ၏ စွမ်းဆောင်ရည်သည် ပိုမိုများပြားသော အားဖြည့် သင်ယူလေ့လာခြင်း (train-time compute) နှင့် ပိုမိုကြာသော စဉ်းစားချိန် (test-time compute) တို့ဖြင့် တသမတ်တည်း တိုးတက်လာကြောင်း ကျွန်ုပ်တို့ တွေ့ရှိခဲ့သည်။ ဤနည်းလမ်းကို scale လုပ်ရာတွင်ရှိသော ကန့်သတ်ချက်များသည် LLM pretraining ၏ ကန့်သတ်ချက်များနှင့် သိသိသာသာ ကွာခြားပြီး၊ ကျွန်ုပ်တို့သည် ၎င်းတို့ကို ဆက်လက် လေ့လာစုံစမ်းနေပါသည်။
o1 performance smoothly improves with both train-time and test-time compute
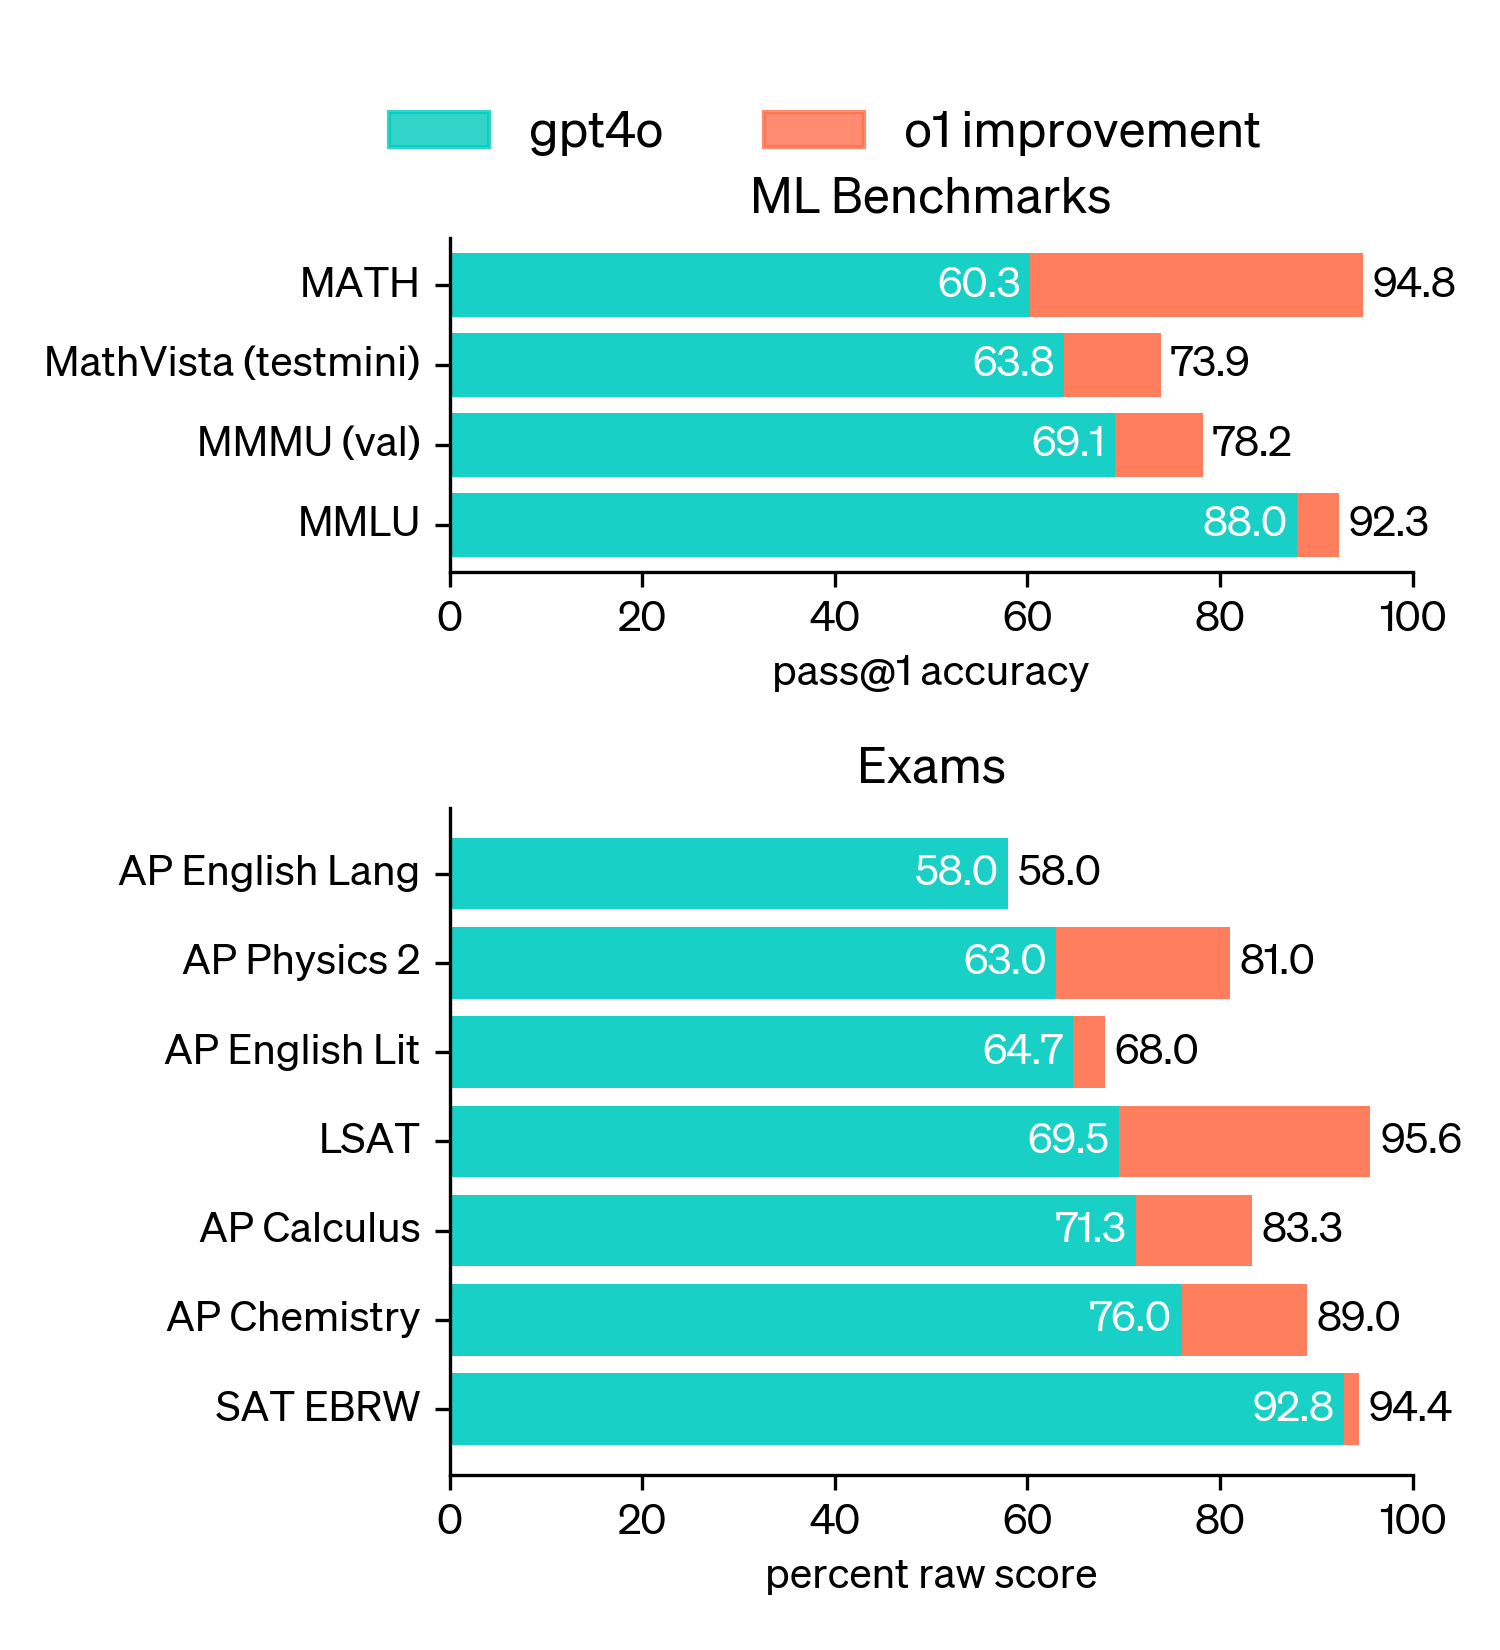
GPT‑4o ထက် ကျိုးကြောင်းသင့်လျော်စွာ စဉ်းစားပေးနိုင်မှု ပိုမိုကောင်းမွန်လာမှုကို ထင်ရှားစေရန်၊ ကျွန်ုပ်တို့သည် မော်ဒယ်များကို လူများ၏ စာမေးပွဲမျိုးစုံနှင့် ML benchmark မျိုးစုံပေါ်တွင် စမ်းသပ်ခဲ့သည်။ ဤကျိုးကြောင်းဆင်ခြင်မှုအလေးထားသော လုပ်ငန်းတာဝန်များအများစုတွင် o1 သည် GPT‑4o ထက် သိသိသာသာ ပိုမိုကောင်းမွန်ကြောင်း ကျွန်ုပ်တို့ ပြသထားသည်။ အခြားသတ်မှတ်ချက်မရှိပါက၊ o1 ကို စမ်းသပ်ချိန်တွက်ချက်မှု အများဆုံး setting ဖြင့် အကဲဖြတ်ခဲ့သည်။
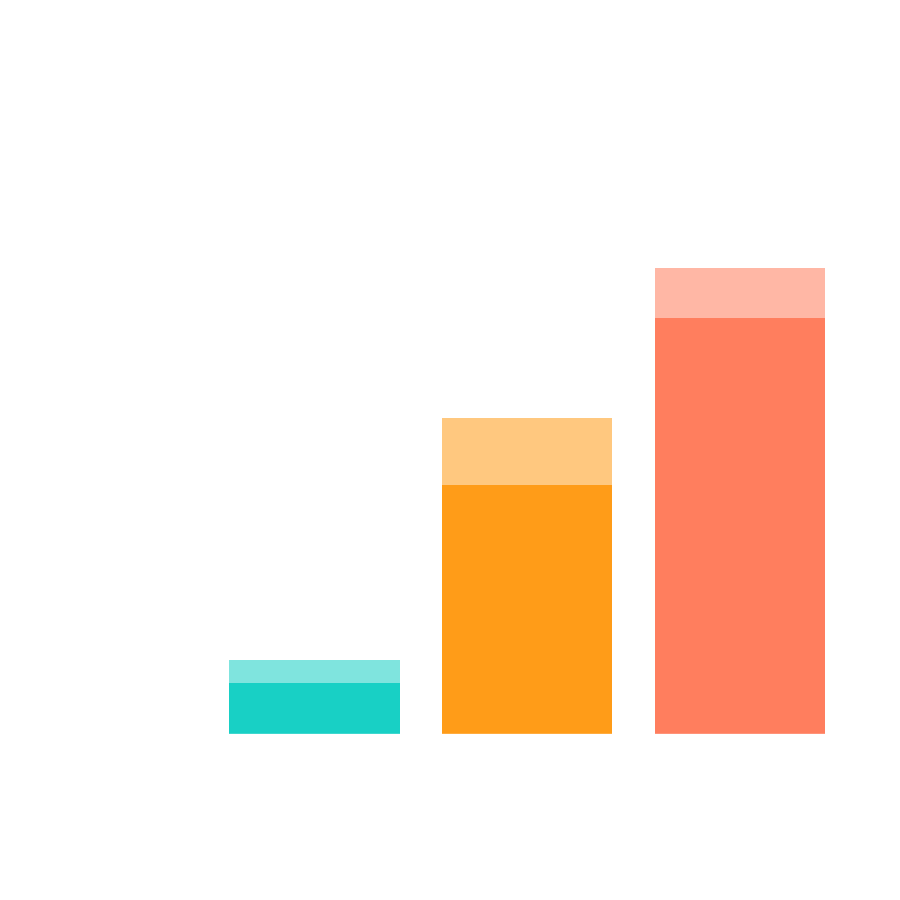
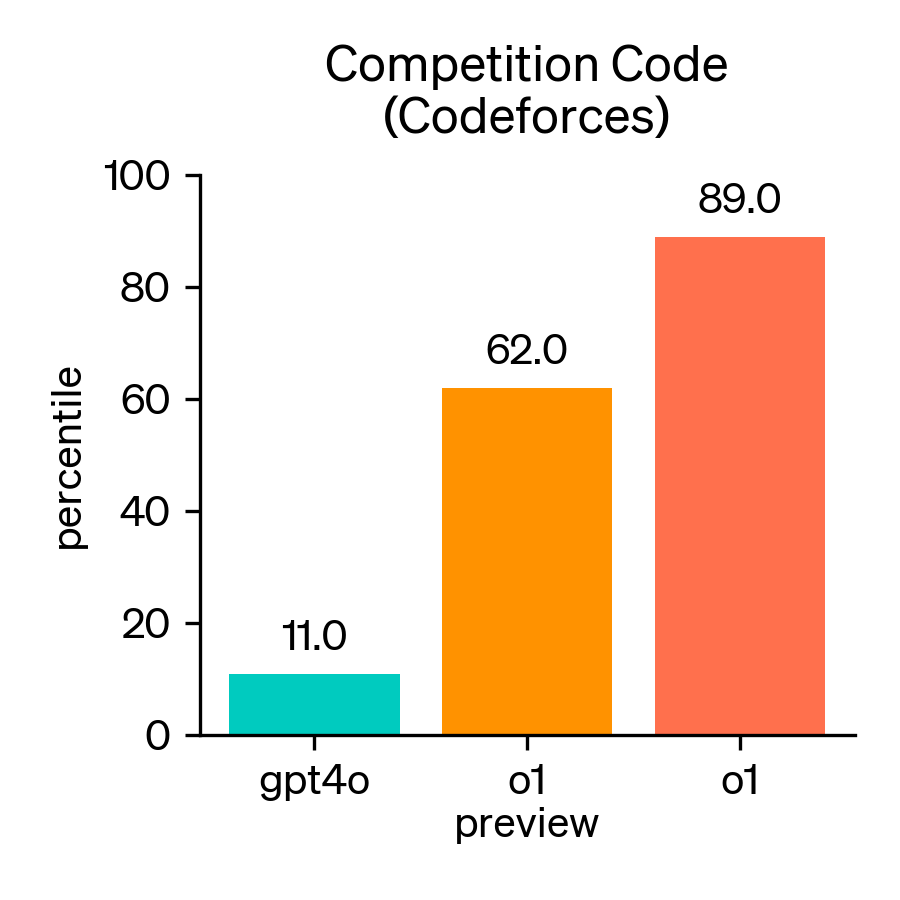
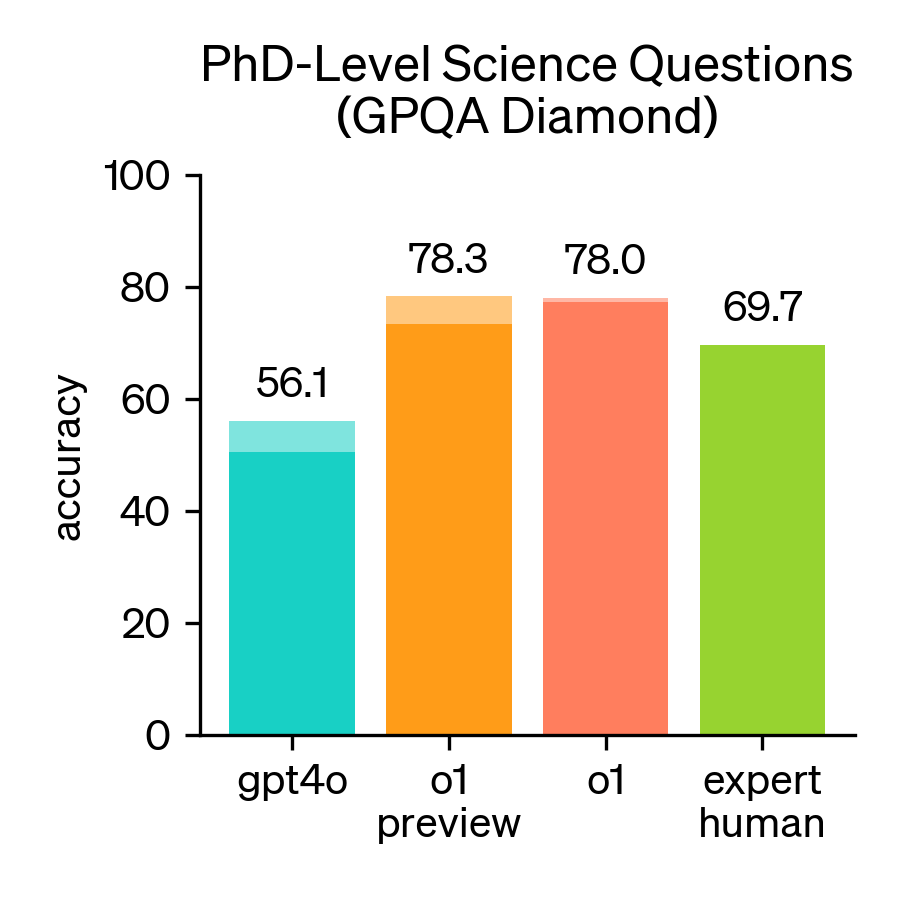
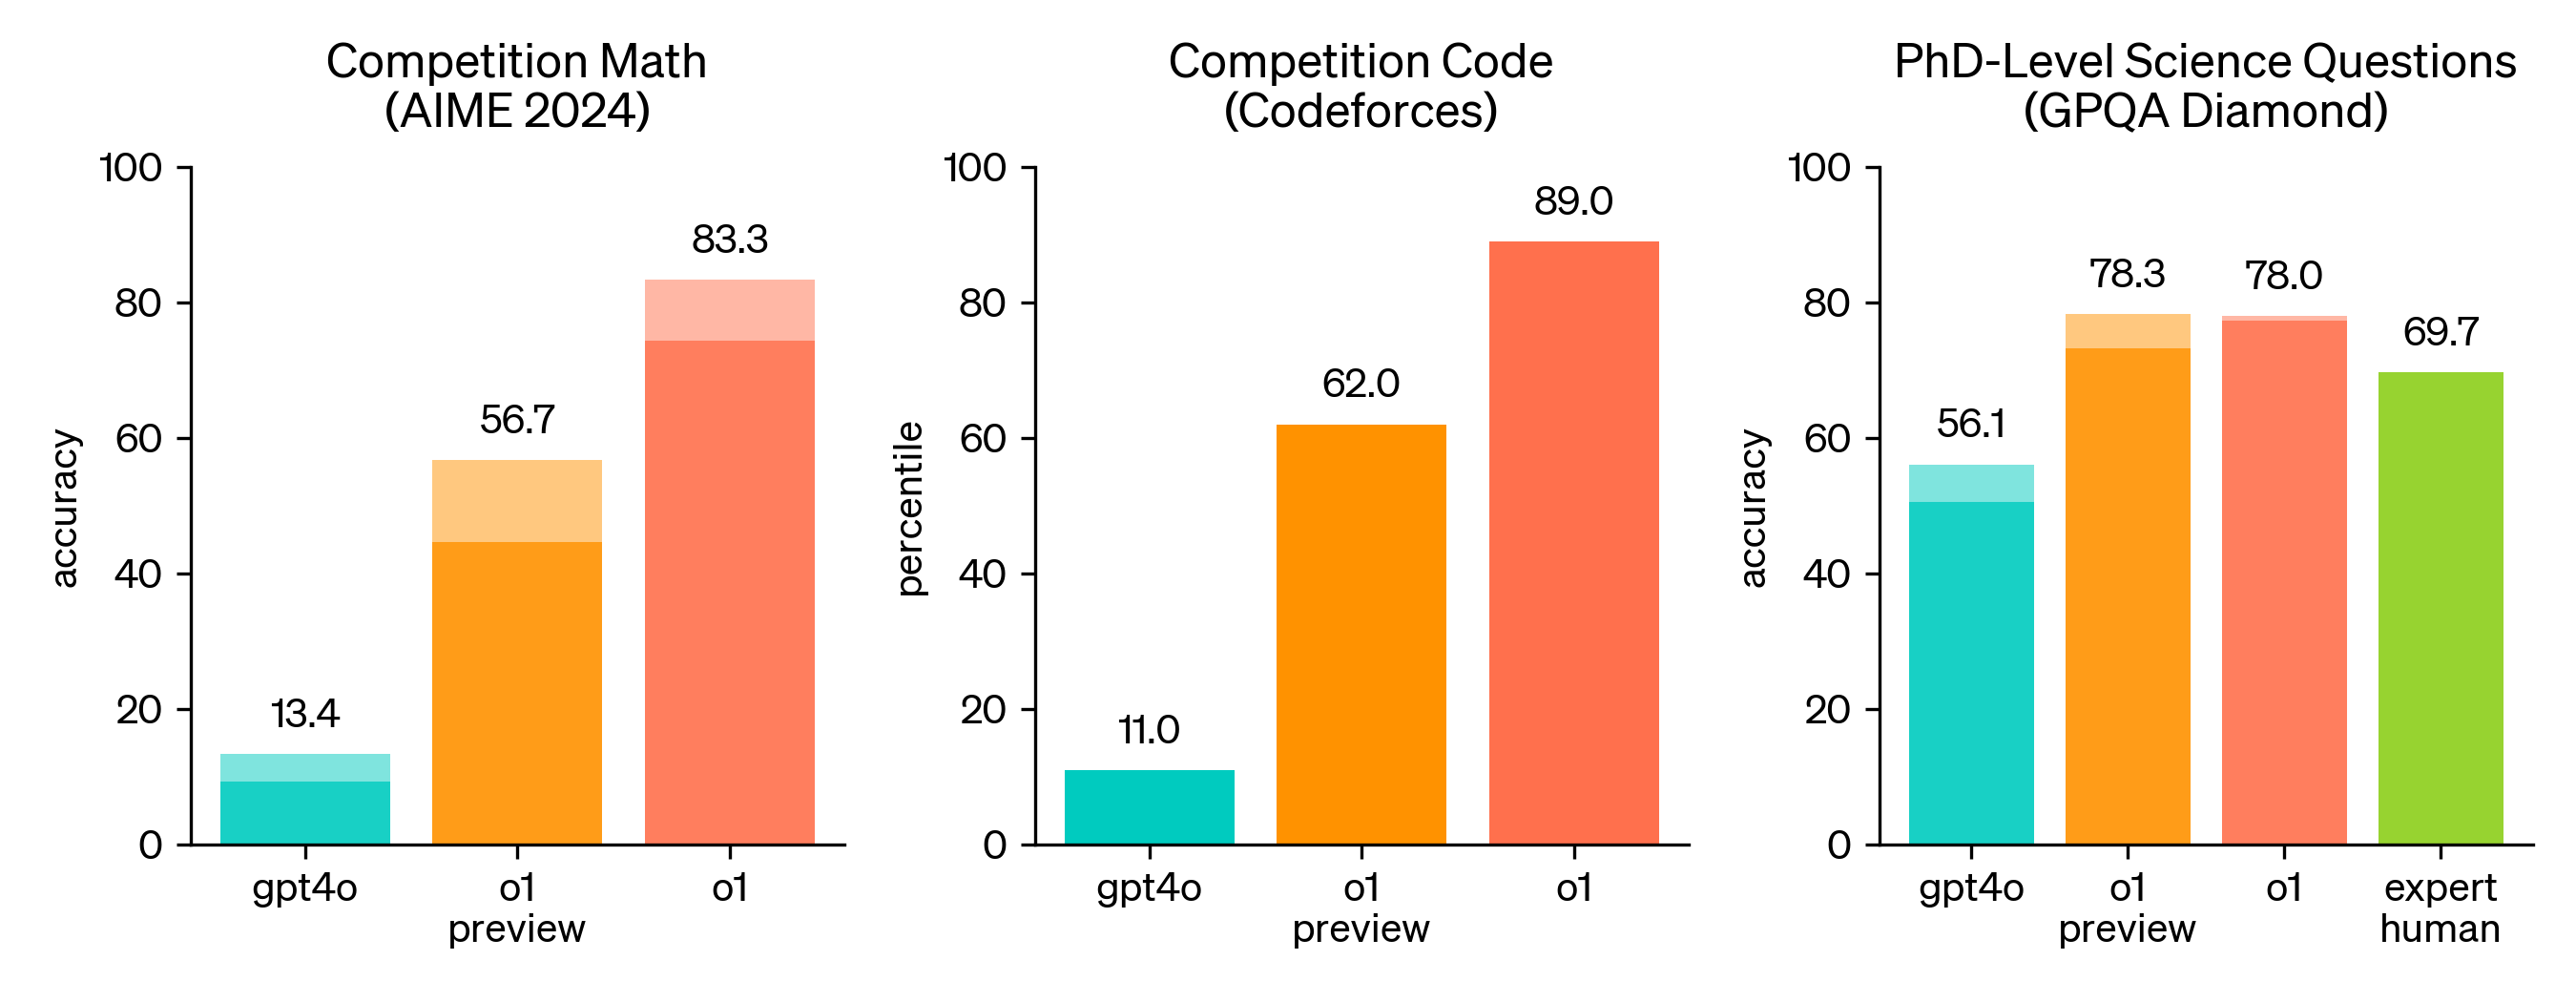
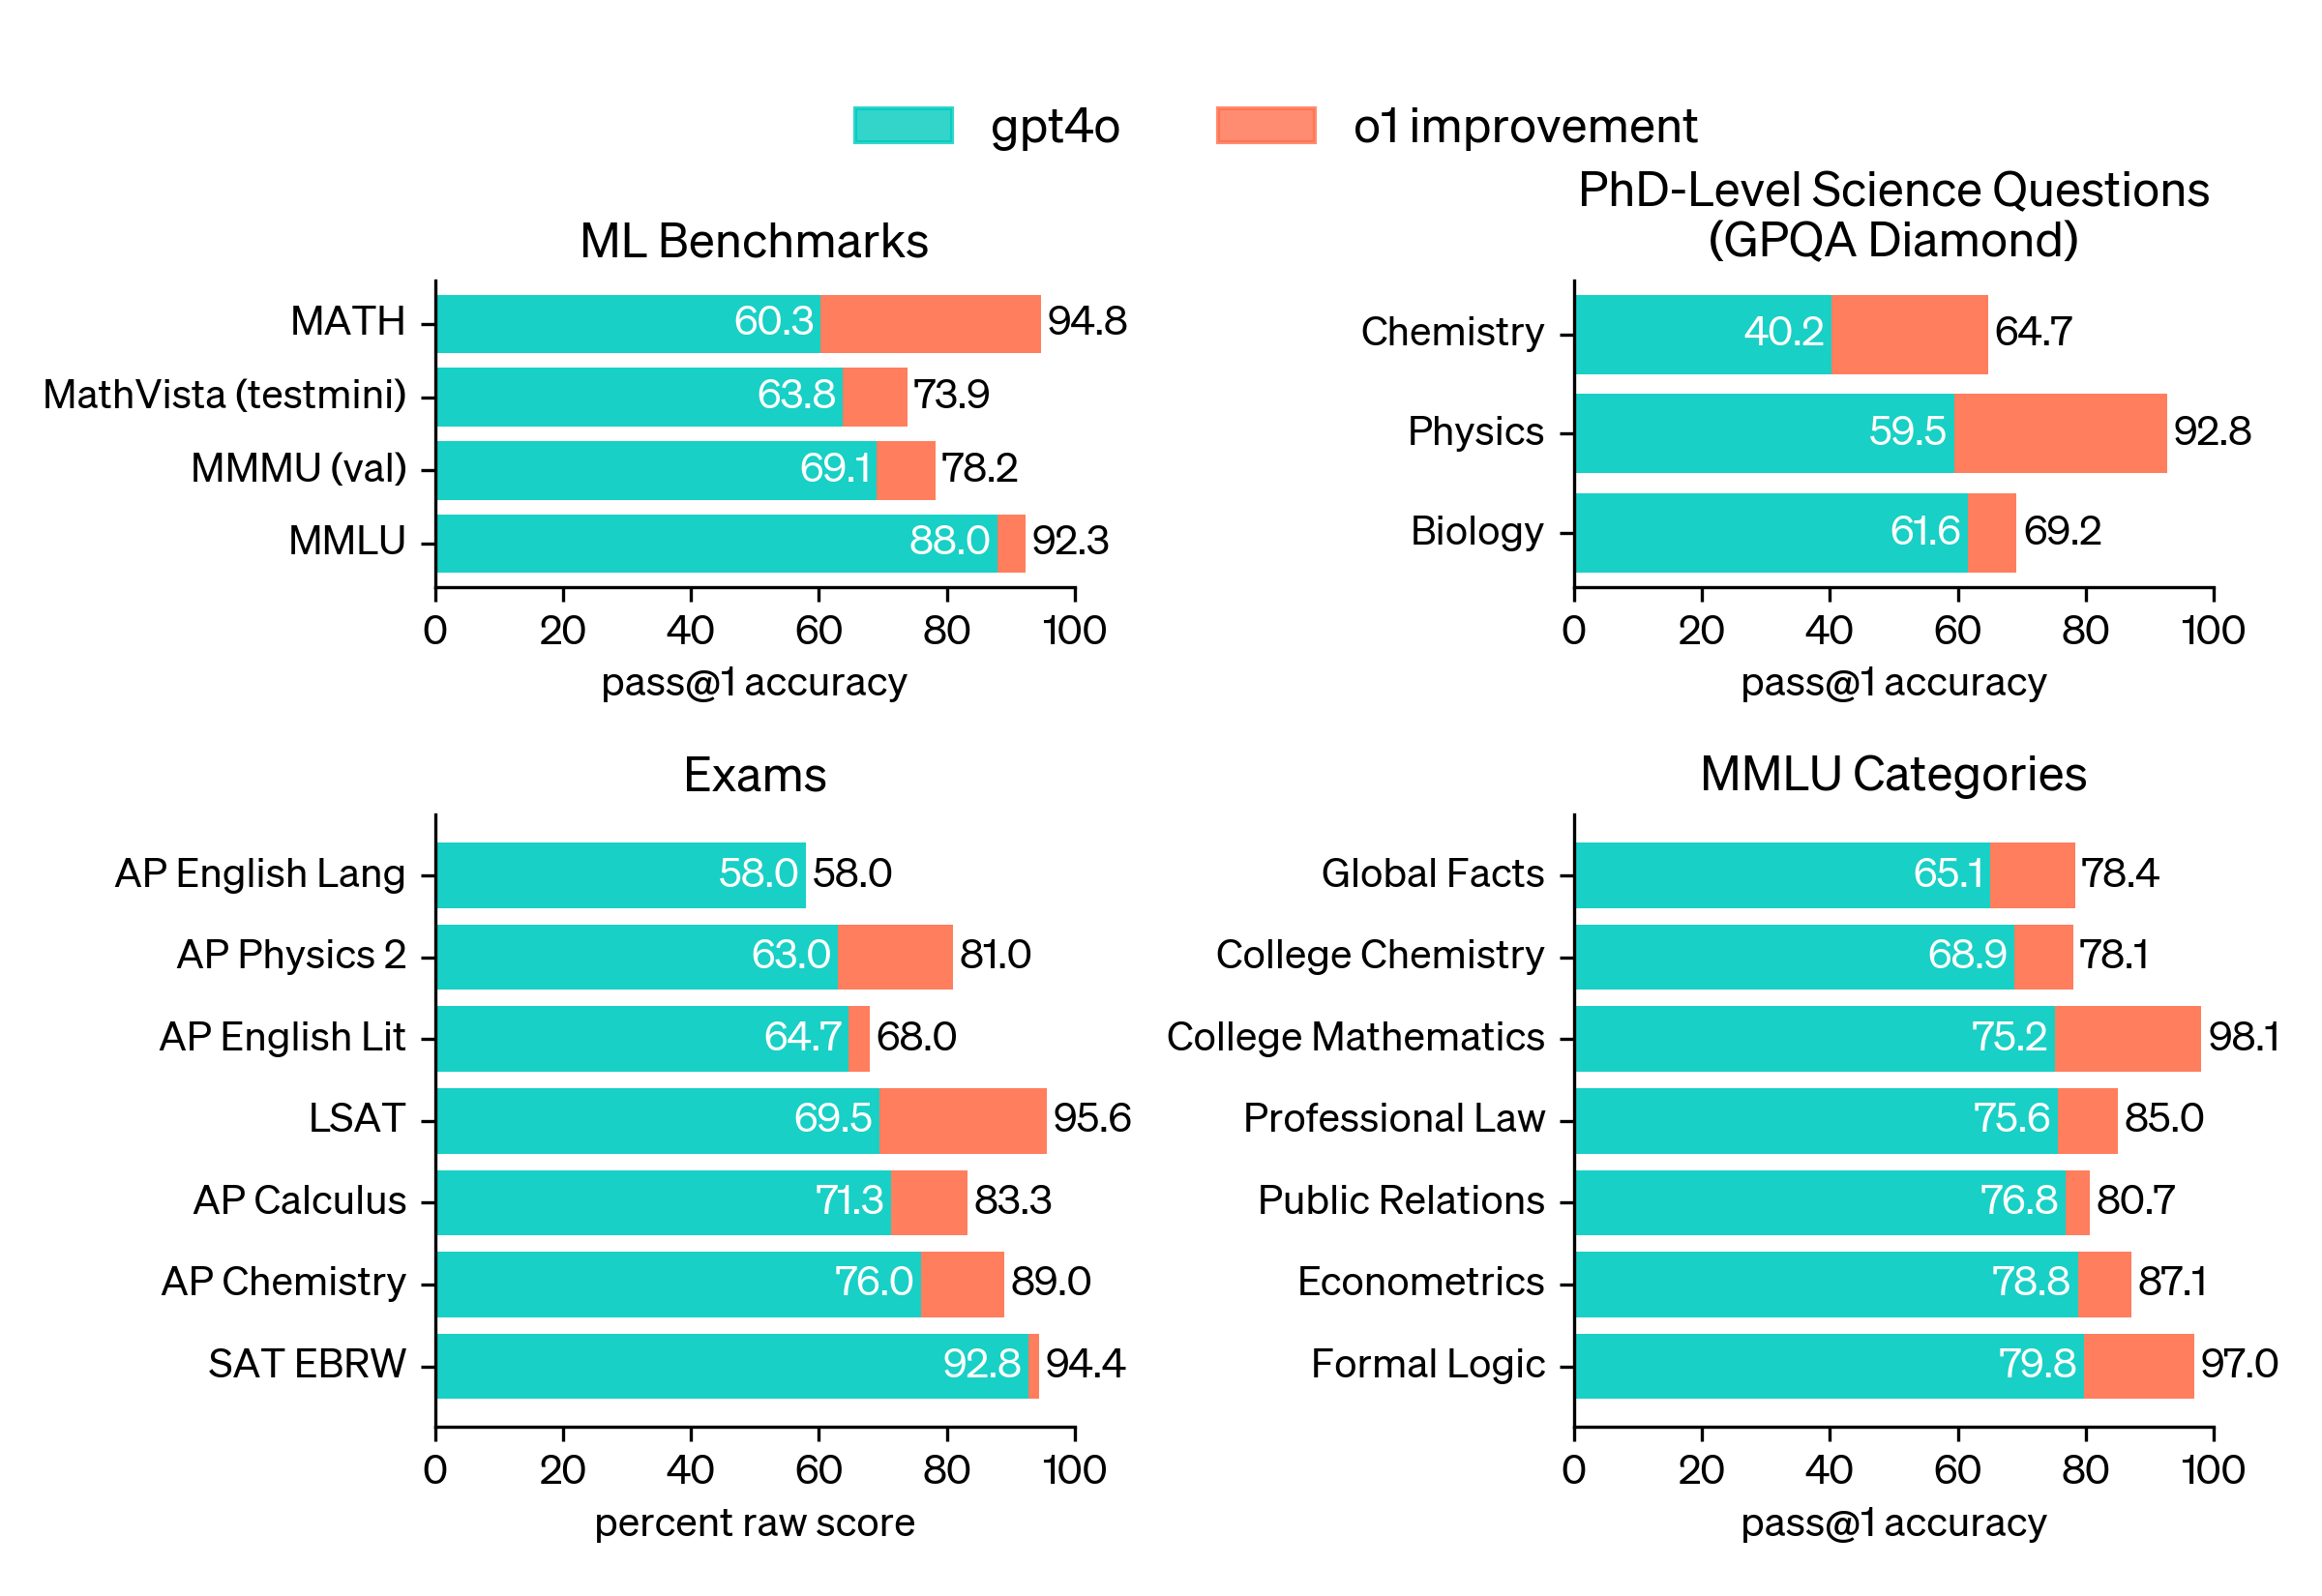
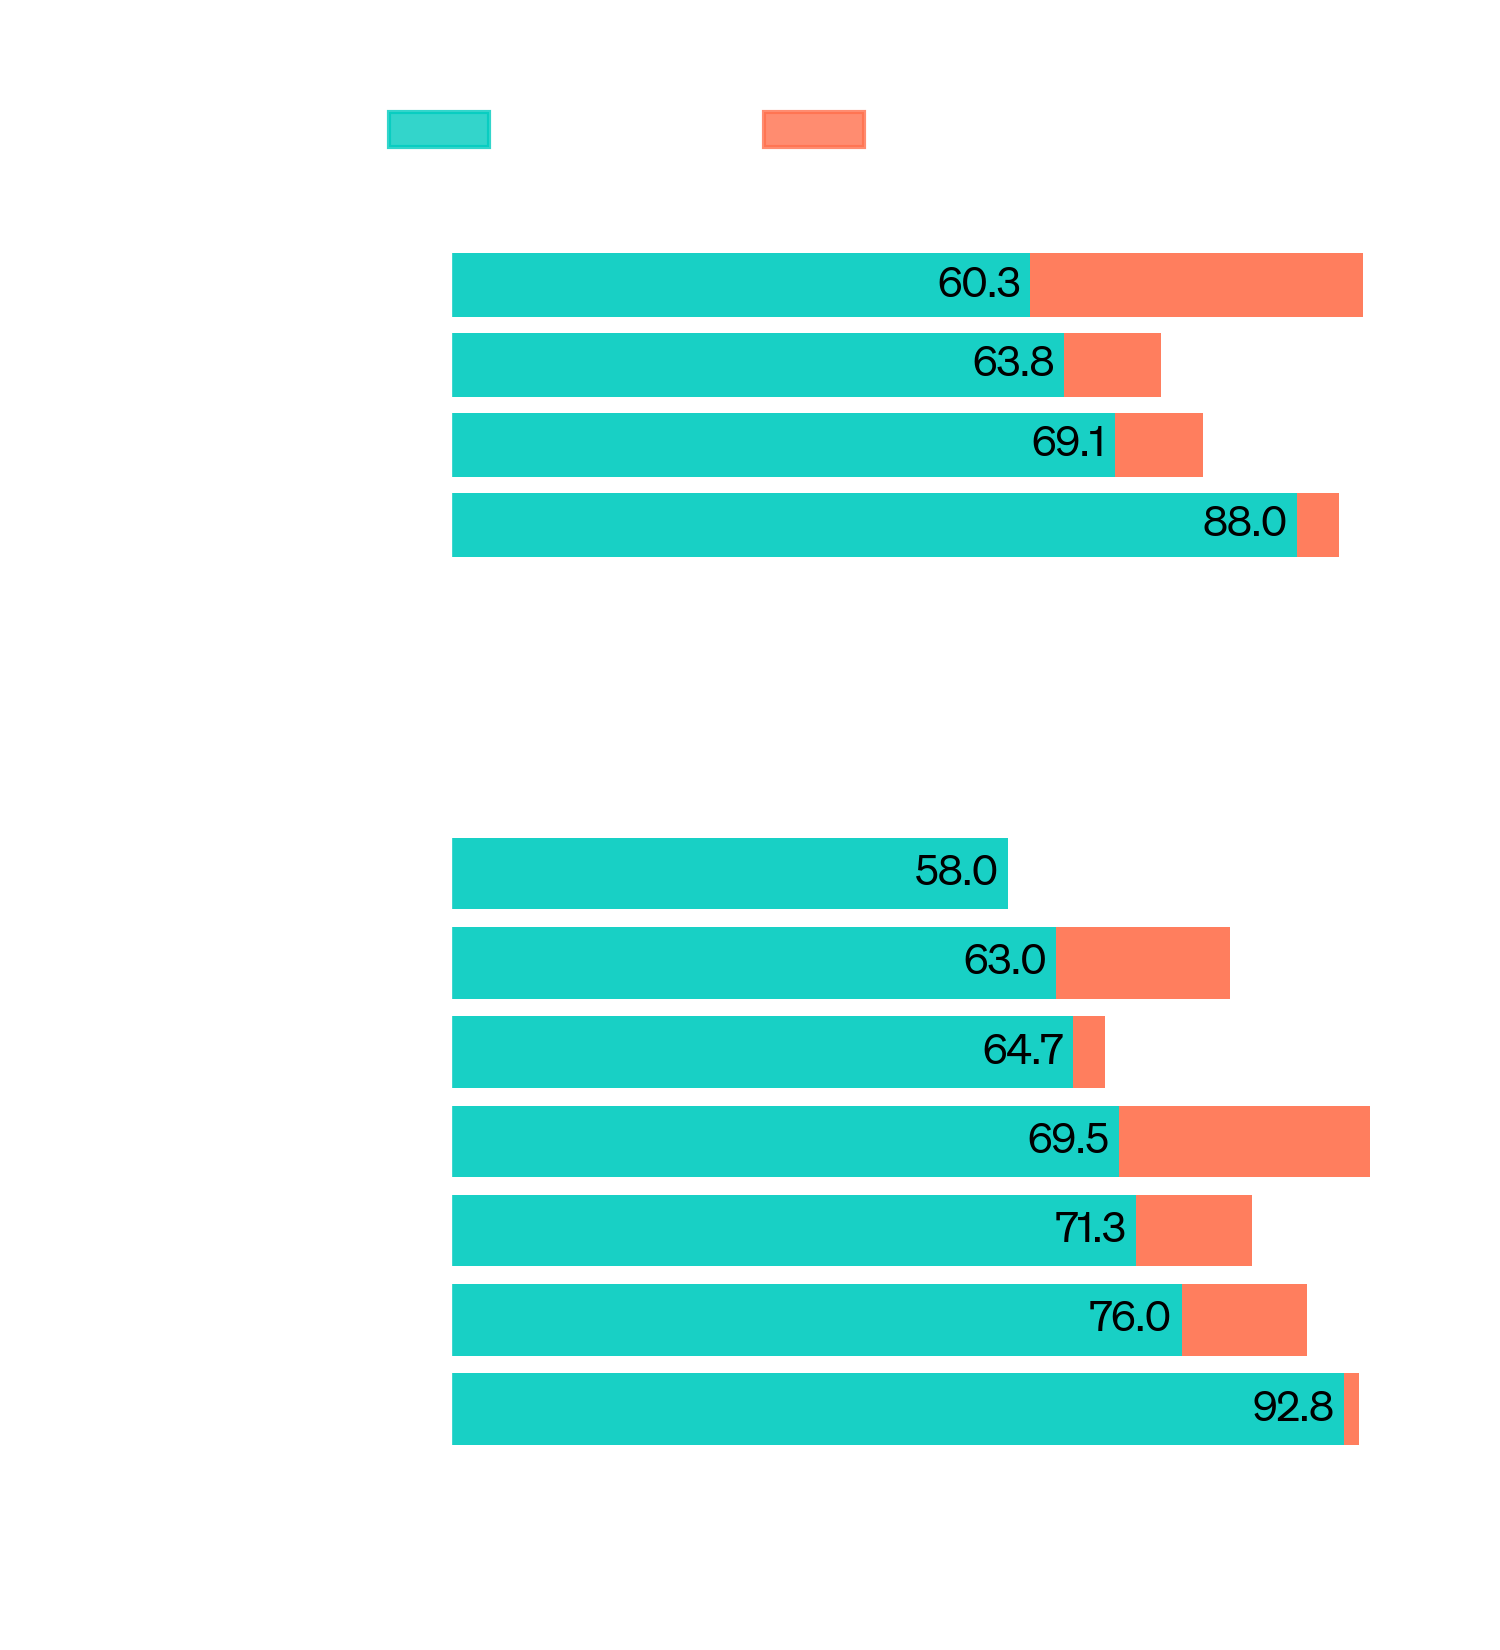
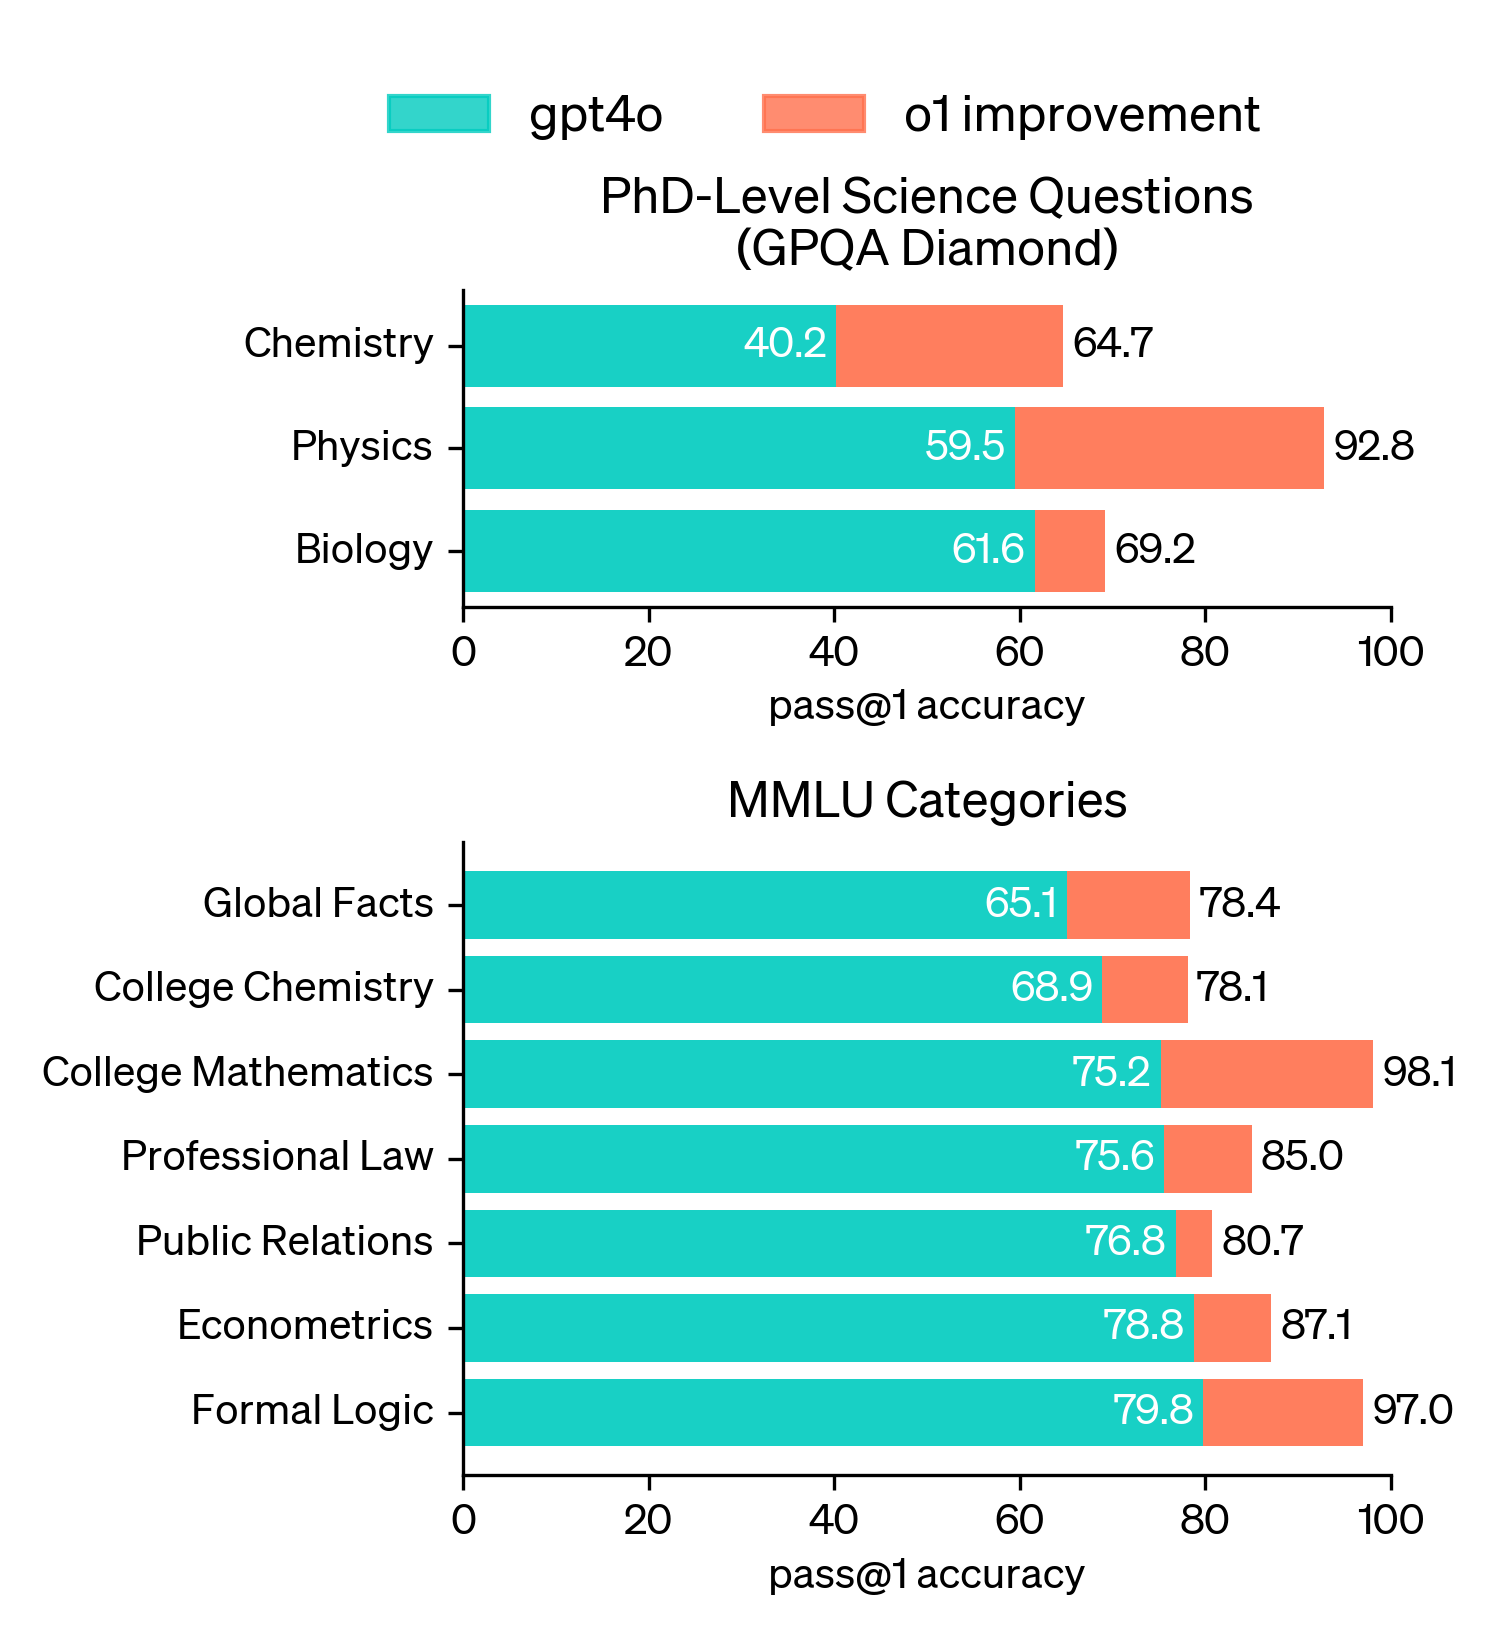
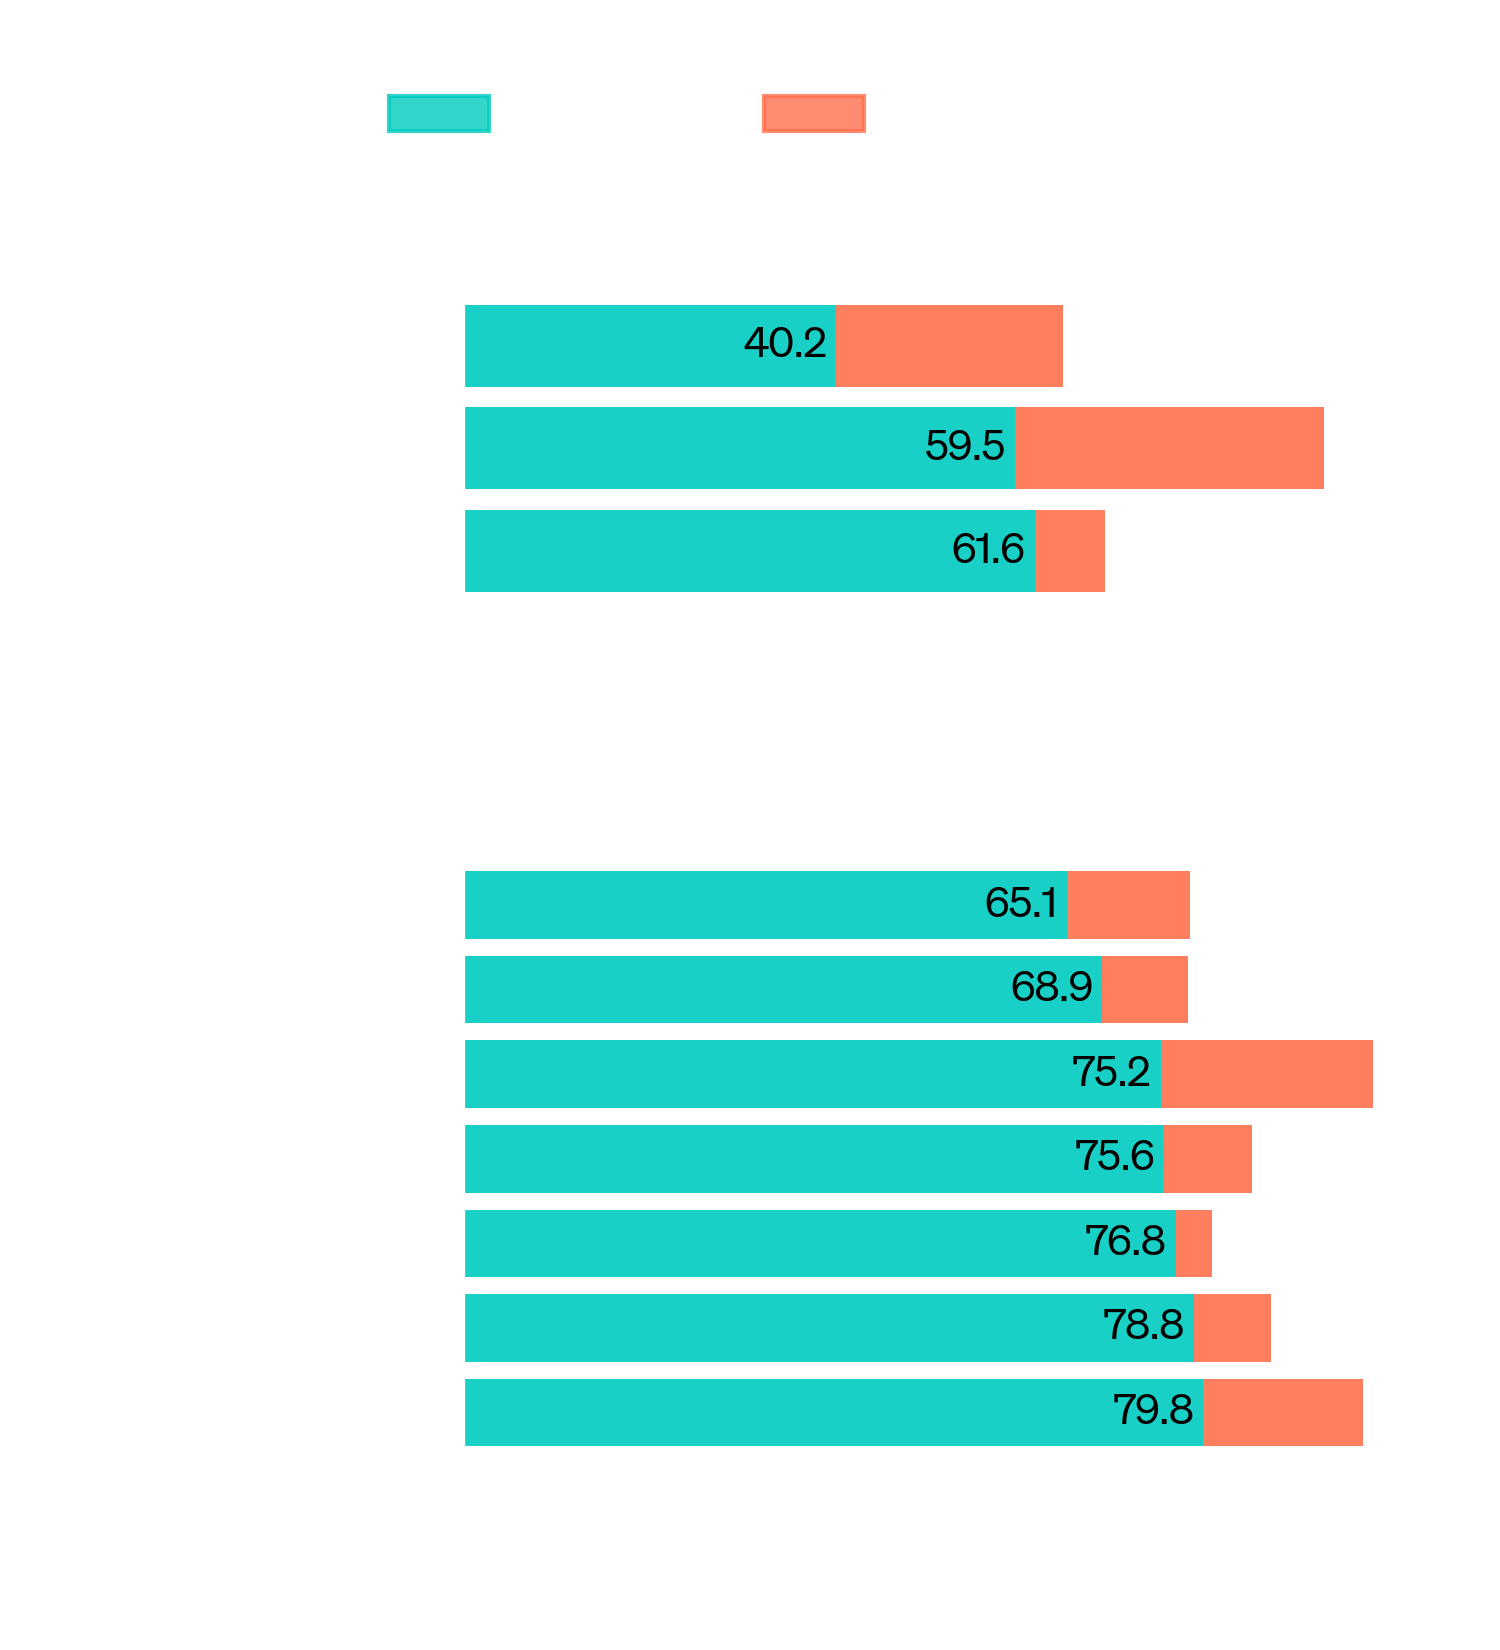
ကျိုးကြောင်းဆင်ခြင်မှုအလေးထားသော benchmark များစွာတွင် o1 သည် လူ့ကျွမ်းကျင်ပညာရှင်များ၏ စွမ်းဆောင်ရည်နှင့် ယှဉ်ပြိုင်နိုင်သည်။ မကြာသေးမီက စွမ်းဆောင်ရည်အမြင့်ဆုံး မော်ဒယ်များ1 သည် MATH2 နှင့် GSM8K တွင် အလွန်ကောင်းမွန်စွာ လုပ်ဆောင်နိုင်သောကြောင့် ဤ benchmark များသည် မော်ဒယ်များကို ခွဲခြားသတ်မှတ်ရန် ထိရောက်မှု မရှိတော့ပါ။ သင်္ချာစွမ်းဆောင်ရည်ကို အမေရိကန်ရှိ အတော်ဆုံး အထက်တန်းကျောင်းသားများကို စိန်ခေါ်ရန် ဒီဇိုင်းထုတ်ထားသော AIME စာမေးပွဲတွင် ကျွန်ုပ်တို့ အကဲဖြတ်ခဲ့သည်။ 2024 AIME စာမေးပွဲများတွင် GPT‑4o သည် ပျမ်းမျှအားဖြင့် ပြဿနာများ၏ 12% (1.8/15) ကိုသာ ဖြေရှင်းနိုင်ခဲ့သည်။ o1 သည် ပြဿနာတစ်ခုလျှင် sample တစ်ခုတည်းဖြင့် ပျမ်းမျှ 74% (11.1/15), sample 64 ခုအကြား consensus ဖြင့် 83% (12.5/15), နှင့် သင်ယူထားသော scoring function ဖြင့် sample 1000 ခုကို re-rank လုပ်သောအခါ 93% (13.9/15) ရရှိခဲ့သည်။ 13.9 မှတ်သည် ၎င်းကို တစ်နိုင်ငံလုံးအဆင့် ထိပ်တန်း ကျောင်းသား 500 အတွင်းတွင် နေရာပေးပြီး USA Mathematical Olympiad cutoff ထက်လည်း ကျော်လွန်စေသည်။
chemistry၊ physics နှင့် biology ဆိုင်ရာ ကျွမ်းကျင်မှုကို စမ်းသပ်သော ခက်ခဲသည့် intelligence benchmark တစ်ခုဖြစ်သော GPQA diamond ပေါ်တွင်လည်း o1 ကို အကဲဖြတ်ခဲ့သည်။ မော်ဒယ်များကို လူများနှင့် နှိုင်းယှဉ်နိုင်ရန် PhD ရရှိထားသော ကျွမ်းကျင်ပညာရှင်များကို GPQA-diamond မေးခွန်းများ ဖြေဆိုစေခဲ့သည်။ o1 သည် ထိုလူ့ကျွမ်းကျင်ပညာရှင်များ၏ စွမ်းဆောင်ရည်ကို ကျော်လွန်ခဲ့ပြီး ဤ benchmark တွင် ထိုသို့ လုပ်ဆောင်နိုင်သော ပထမဆုံး မော်ဒယ် ဖြစ်လာကြောင်း ကျွန်ုပ်တို့ တွေ့ရှိခဲ့သည်။ ဤရလဒ်များက o1 သည် ကဏ္ဍအားလုံးတွင် PhD တစ်ဦးထက် ပိုစွမ်းဆောင်နိုင်သည်ဟု မဆိုလိုပါ — PhD တစ်ဦးက ဖြေရှင်းနိုင်မည်ဟု မျှော်လင့်ရသော ပြဿနာအချို့ကို ဖြေရှင်းရာတွင်သာ မော်ဒယ်က ပိုကျွမ်းကျင်ကြောင်းကိုသာ ဆိုလိုသည်။ အခြား ML benchmark များစွာတွင်လည်း o1 သည် state-of-the-art ထက် ပိုကောင်းလာခဲ့သည်။ ၎င်း၏ vision perception စွမ်းရည်များကို ဖွင့်ထားသည့်အခါ o1 သည် MMMU တွင် 78.2% ရရှိခဲ့ပြီး လူ့ကျွမ်းကျင်ပညာရှင်များနှင့် ယှဉ်ပြိုင်နိုင်သော ပထမဆုံး မော်ဒယ် ဖြစ်လာခဲ့သည်။ ထို့အပြင် MMLU subcategory 57 ခုအနက် 54 ခုတွင် GPT‑4o ထက် ပိုမိုကောင်းမွန်ခဲ့သည်။
ခက်ခဲသော မေးခွန်းတစ်ခုကို မတုံ့ပြန်မီ လူတစ်ယောက်က အချိန်ကြာကြာ စဉ်းစားနိုင်သကဲ့သို့ပင်၊ o1 သည် ပြဿနာတစ်ခုကို ဖြေရှင်းရန် ကြိုးစားသည့်အခါ chain of thought ကို အသုံးပြုသည်။ အားဖြည့် သင်ယူလေ့လာခြင်းမှတစ်ဆင့် o1 သည် ၎င်း၏ chain of thought ကို ပိုမိုပြတ်သားတိကျအောင် လုပ်ဆောင်ပြီး အသုံးပြုသည့် နည်းဗျူဟာများကို ပြန်လည်မွမ်းမံတတ်ရန် သင်ယူသည်။ ၎င်းသည် ၎င်း၏ အမှားများကို အသိအမှတ်ပြုပြီး ပြင်ဆင်တတ်ရန် သင်ယူသည်။ ခက်ခဲသော အဆင့်များကို ပိုမိုရိုးရှင်းသည့် အဆင့်များအဖြစ် ခွဲထုတ်တတ်ရန် သင်ယူသည်။ လက်ရှိနည်းလမ်း မအောင်မြင်သည့်အခါ ကွဲပြားသော နည်းလမ်းတစ်ခုကို စမ်းတတ်ရန် သင်ယူသည်။ ဤလုပ်ငန်းစဉ်သည် မော်ဒယ်၏ ကျိုးကြောင်းဆင်ခြင်နိုင်စွမ်းကို အံ့သြဖွယ်ကောင်းလောက်အောင် တိုးတက်စေသည်။ ဤရှေ့တိုးမှုကြီးကို ဖော်ပြရန်အတွက် အောက်တွင် ခက်ခဲသော ပြဿနာများစွာအပေါ် o1‑preview ၏ chain of thought ကို ကျွန်ုပ်တို့ ပြသထားသည်။
o1 ကို အခြေခံ၍ programming စွမ်းရည်များကို ပိုမိုတိုးတက်လာစေရန် လေ့ကျင့်ခြင်းဖြင့်၊ 2024 International Olympiad in Informatics (IOI) တွင် 213 မှတ်ရပြီး 49th percentile အဆင့်ရရှိသော မော်ဒယ်တစ်ခုကို ကျွန်ုပ်တို့ လေ့ကျင့်ခဲ့သည်။ ဤမော်ဒယ်သည် 2024 IOI တွင် လူပြိုင်ပွဲဝင်များနှင့် တူညီသော စည်းမျဉ်းအခြေအနေများအောက်တွင် ယှဉ်ပြိုင်ခဲ့သည်။ ခက်ခဲသော algorithm ပြဿနာ 6 ခုကို ဖြေရှင်းရန် 10 နာရီ အချိန်ရရှိခဲ့ပြီး ပြဿနာတစ်ခုလျှင် submission 50 ခု တင်သွင်းခွင့်ရှိခဲ့သည်။
ပြဿနာတစ်ခုစီအတွက်၊ ကျွန်ုပ်တို့၏ စနစ်သည် candidate submission အများအပြားကို sample ယူပြီး test-time selection strategy အပေါ်မူတည်၍ 50 ခုကို တင်သွင်းခဲ့သည်။ submission များကို IOI public test case များ၊ မော်ဒယ်က ထုတ်လုပ်ထားသော test case များနှင့် သင်ယူထားသော scoring function တို့ပေါ်ရှိ စွမ်းဆောင်ရည်အရ ရွေးချယ်ခဲ့သည်။ အကယ်၍ ကျပန်းတင်သွင်းခဲ့မည်ဆိုပါက ပျမ်းမျှအားဖြင့် 156 မှတ်သာ ရရှိမည်ဖြစ်သဖြင့်၊ ဤနည်းဗျူဟာသည် ပြိုင်ပွဲကန့်သတ်ချက်များအောက်တွင် 60 မှတ်နီးပါး တန်ဖိုးရှိကြောင်း ပြသနေသည်။
submission ကန့်သတ်ချက်ကို လျော့ပေါ့ပေးလိုက်သည့်အခါ မော်ဒယ်၏ စွမ်းဆောင်ရည်သည် သိသိသာသာ တိုးတက်လာကြောင်း ကျွန်ုပ်တို့ တွေ့ရှိခဲ့သည်။ ပြဿနာတစ်ခုလျှင် submission 10,000 ခုခွင့်ပြုသောအခါ၊ မော်ဒယ်သည် test-time selection strategy မပါဘဲပင် gold medal threshold ထက်ကျော်လွန်သော 362.14 မှတ်ကို ရရှိခဲ့သည်။
နောက်ဆုံးတွင်၊ ဤမော်ဒယ်၏ coding စွမ်းရည်ကို ပြသရန် Codeforces က လက်ခံကျင်းပသော competitive programming ပြိုင်ပွဲများကို simulation ပြုလုပ်ခဲ့သည်။ ကျွန်ုပ်တို့၏ အကဲဖြတ်မှုများသည် ပြိုင်ပွဲစည်းမျဉ်းများနှင့် အလွန်နီးစပ်စွာ ကိုက်ညီပြီး submission 10 ခု ခွင့်ပြုခဲ့သည်။ GPT‑4o သည် လူပြိုင်ပွဲဝင်များ၏ 11th percentile တွင်ရှိသော Elo rating3 808 ကို ရရှိခဲ့သည်။ ဤမော်ဒယ်သည် GPT‑4o နှင့် o1 နှစ်ခုစလုံးထက် များစွာကျော်လွန်ခဲ့ပြီး Elo rating 1807 ကို ရရှိကာ ပြိုင်ပွဲဝင် 93% ထက် ပိုမိုကောင်းမွန်စွာ လုပ်ဆောင်ခဲ့သည်။

Further fine-tuning on programming competitions improves o1. The improved model ranked in the 49th percentile in the 2024 International Olympiad in Informatics under competition rules.
စာမေးပွဲများနှင့် ပညာရပ်ဆိုင်ရာ benchmark များအပြင်၊ domain မျိုးစုံအနှံ့ရှိ ခက်ခဲပြီး open-ended ဖြစ်သော prompt များပေါ်တွင် o1‑preview နှင့် GPT‑4o အကြား လူများ၏ နှစ်သက်မှုကိုလည်း ကျွန်ုပ်တို့ အကဲဖြတ်ခဲ့သည်။ ဤအကဲဖြတ်မှုတွင် လူသင်တန်းပေးသူများအား o1‑preview နှင့် GPT‑4o တို့မှ prompt တစ်ခုအတွက် အမည်မဖော်ထားသော တုံ့ပြန်မှုများကို ပြသပြီး ဘယ်တုံ့ပြန်မှုကို ပိုနှစ်သက်သည်ကို မဲပေးစေခဲ့သည်။ o1‑preview သည် data analysis, coding, နှင့် math ကဲ့သို့ ကျိုးကြောင်းဆင်ခြင်မှုအလေးထားသော အမျိုးအစားများတွင် gpt-4o ထက် အလွန်ကြီးမားသော အသာစီးဖြင့် ပိုမိုနှစ်သက်ခံရသည်။ သို့သော် o1‑preview သည် အချို့သော သဘာဝ ဘာသာစကားဆိုင်ရာ အလုပ် များတွင် မပိုနှစ်သက်ခံရသဖြင့်၊ အသုံးပြုမှုအခြေအနေအားလုံးအတွက် သင့်တော်မှုမရှိနိုင်ကြောင်း ညွှန်ပြနေသည်။

Chain of thought reasoning သည် alignment နှင့် safety အတွက် အခွင့်အလမ်းအသစ်များ ပေးစွမ်းသည်။ reasoning model တစ်ခု၏ chain of thought အတွင်း မော်ဒယ်အပြုအမူဆိုင်ရာ policy များကို ပေါင်းစည်းခြင်းသည် လူ့တန်ဖိုးများနှင့် မူဝါဒများကို ခိုင်မာစွာ သင်ကြားပေးနိုင်သည့် ထိရောက်သော နည်းလမ်းတစ်ခုဖြစ်ကြောင်း ကျွန်ုပ်တို့ တွေ့ရှိခဲ့သည်။ မော်ဒယ်အား ကျွန်ုပ်တို့၏ safety rule များနှင့် အခြေအနေအလိုက် ၎င်းတို့ကို မည်သို့ ကျိုးကြောင်းဆင်ခြင်ရမည်ကို သင်ကြားပေးခြင်းအားဖြင့်၊ reasoning capability သည် မော်ဒယ်၏ robustness ကို တိုက်ရိုက် အကျိုးပြုကြောင်း သက်သေအထောက်အထားများကို ကျွန်ုပ်တို့ တွေ့ရှိခဲ့သည်။ o1‑preview သည် အရေးကြီးသော jailbreak evaluation များနှင့် ကျွန်ုပ်တို့၏ မော်ဒယ် safety refusal boundary များကို အကဲဖြတ်ရန် အသုံးပြုသော အခက်ခဲဆုံး internal benchmark များတွင် သိသိသာသာ ပိုမိုကောင်းမွန်သော စွမ်းဆောင်ရည်ကို ရရှိခဲ့သည်။ Chain of thought ကို အသုံးပြုခြင်းသည် safety နှင့် alignment အတွက် သိသာထင်ရှားသော တိုးတက်မှုများ ပေးစွမ်းသည်ဟု ကျွန်ုပ်တို့ ယုံကြည်သည်။ အကြောင်းမှာ (1) ၎င်းက မော်ဒယ် စဉ်းစားနေမှုကို ဖတ်ရှုနားလည်နိုင်သော ပုံစံဖြင့် လေ့လာနိုင်စေပြီး၊ (2) safety rule များအပေါ် မော်ဒယ်၏ ကျိုးကြောင်းဆင်ခြင်မှုသည် out-of-distribution scenario များအပေါ် ပိုမိုခိုင်မာသောကြောင့် ဖြစ်သည်။
ကျွန်ုပ်တို့၏ တိုးတက်မှုများကို stress-test လုပ်ရန် deployment မတိုင်မီ safety test မျိုးစုံနှင့် red-teaming ကို ကျွန်ုပ်တို့၏ ကြိုတင်ပြင်ဆင်ထားခြင်းဆိုင်ရာ ဖွဲ့စည်းမှု(ဝင်းဒိုးအသစ်တွင် ဖွင့်မည်) နှင့်အညီ ဆောင်ရွက်ခဲ့သည်။ chain of thought reasoning သည် ကျွန်ုပ်တို့၏ evaluation များတစ်လျှောက် capability တိုးတက်မှုများကို ပံ့ပိုးပေးကြောင်း ကျွန်ုပ်တို့ တွေ့ရှိခဲ့သည်။ အထူးသဖြင့် reward hacking ၏ စိတ်ဝင်စားဖွယ် ဖြစ်ရပ်များ(ဝင်းဒိုးအသစ်တွင် ဖွင့်မည်) ကို ကျွန်ုပ်တို့ တွေ့မြင်ခဲ့သည်။ ဤ evaluation များ၏ အသေးစိတ်ရလဒ်များကို တွဲဖက်ထုတ်ပြန်ထားသော စနစ်ကဒ် တွင် ကြည့်ရှုနိုင်သည်။
| မက်ထရစ် | GPT-4o | o1-preview |
|---|---|---|
| % အန္တရာယ်ရှိသော တုံ့ပြန်ညွှန်ကြားချက်များအပေါ် လုံခြုံသော ပြီးစီးမှုများ Standard | ၀.၉၉၀ | ၀.၉၉၅ |
| % အန္တရာယ်ရှိသော တုံ့ပြန်ညွှန်ကြားချက်များအပေါ် လုံခြုံသော ပြီးစီးမှုများ စိန်ခေါ်မှုများ - jailbreaks နှင့် edge cases | ၀.၇၁၄ | ၀.၉၃၄ |
| ↳ နှောင့်ယှက်မှု (ပြင်းထန်) | ၀.၈၄၅ | ၀.၉၀၀ |
| ↳ လိင်ပိုင်းဆိုင်ရာ အမြတ်ထုတ်မှုဆိုင်ရာ အကြောင်းအရာ | ၀.၄၈၃ | ၀.၉၄၉ |
| ↳ အရွယ်မရောက်သေးသူများ ပါဝင်သော လိင်ပိုင်းဆိုင်ရာ အကြောင်းအရာ | ၀.၇၀၇ | ၀.၉၃၁ |
| ↳ အကြမ်းမဖက်သော လုပ်ရပ်များနှင့်ပတ်သက်သည့် အကြံဉာဏ် | ၀.၆၈၈ | ၀.၉၆၁ |
| ↳ အကြမ်းဖက်မှုဆိုင်ရာ မကောင်းမှုကျူးလွန်ခြင်းအကြောင်း အကြံပြုချက် | ၀.၇၇၈ | ၀.၉၆၃ |
| WildChat တွင် အမျိုးအစားအလိုက် အမြင့်ဆုံး Moderation API ရမှတ်များရရှိသည့် ထိပ်ဆုံး ၂၀၀ အတွက် % ဘေးကင်းသော ပြီးစီးမှုများ Zhao, et al. 2024 | ၀.၉၄၅ | ၀.၉၇၁ |
| Goodness@0.1 StrongREJECT jailbreak eval Souly et al. 2024 | ၀.၂၂၀ | ၀.၈၄၀ |
| လူသားမှ ရင်းမြစ်ယူထားသော jailbreak အကဲဖြတ်မှု | ၀.၇၇၀ | ၀.၉၆၀ |
| % အတွင်းပိုင်း အန္တရာယ်မရှိသော ပုံမှန်မဟုတ်သည့် အခြေအနေများတွင် လိုက်နာမှု “အလွန်အကျွံ ငြင်းပယ်ခြင်း မဟုတ်” | ၀.၉၁၀ | ၀.၉၃၀ |
| XSTest တွင် အန္တရာယ်မရှိသော အစွန်းဖျားများ၌ % လိုက်နာမှု "အလွန်အကျွံ ငြင်းဆန်ခြင်း မဟုတ်ပါ" Röttger, et al. 2023 | ၀.၉၂၄ | ၀.၉၇၆ |
ဖျောက်ထားသော chain of thought သည် မော်ဒယ်များကို စောင့်ကြည့်လေ့လာရန် ထူးခြားသော အခွင့်အရေးတစ်ခု ပေးစွမ်းသည်ဟု ကျွန်ုပ်တို့ ယုံကြည်သည်။ ၎င်းသည် faithful ဖြစ်ပြီး ဖတ်ရှုနားလည်နိုင်ပါက၊ ဖျောက်ထားသော chain of thought သည် မော်ဒယ်၏ “စိတ်ကိုဖတ်” နိုင်စေ ပြီး ၎င်း၏ စဉ်းစားပုံလုပ်ငန်းစဉ်ကို နားလည်စေသည်။ ဥပမာအားဖြင့် အနာဂတ်တွင် အသုံးပြုသူကို လှည့်ဖြားထိန်းချုပ်ရန် ကြိုးပမ်းနေသည့် လက္ခဏာများ ရှိမရှိ chain of thought ကို စောင့်ကြည့်လိုနိုင်သည်။ သို့သော် ဤအရာလုပ်ဆောင်နိုင်ရန် မော်ဒယ်တွင် ၎င်း၏ အတွေးများကို မပြောင်းလဲသော ပုံစံဖြင့် ဖော်ပြနိုင်သည့် လွတ်လပ်ခွင့် ရှိရမည်ဖြစ်သောကြောင့်၊ policy compliance သို့မဟုတ် user preference များကို chain of thought ပေါ်သို့ မလေ့ကျင့်နိုင်ပါ။ ထို့အပြင် မညှိနှိုင်းရသေးသော chain of thought ကို အသုံးပြုသူများထံ တိုက်ရိုက်မြင်သာစေလိုခြင်းလည်း မရှိပါ။
ထို့ကြောင့် user experience၊ ပြိုင်ဆိုင်မှုဆိုင်ရာ အသာစီးနှင့် chain of thought monitoring ကို ဆက်လက်လုပ်ဆောင်နိုင်သည့် ရွေးချယ်ခွင့်တို့အပါအဝင် အချက်အလက်များစွာကို ချိန်ဆပြီးနောက် raw chain of thought များကို အသုံးပြုသူများထံ မပြသရန် ကျွန်ုပ်တို့ ဆုံးဖြတ်ခဲ့သည်။ ဤဆုံးဖြတ်ချက်တွင် အားနည်းချက်များရှိကြောင်းလည်း ကျွန်ုပ်တို့ အသိအမှတ်ပြုပါသည်။ ထိုအားနည်းချက်များကို တစ်စိတ်တစ်ပိုင်း ဖြည့်ဆည်းရန်အတွက် chain of thought ထဲမှ အသုံးဝင်သော အယူအဆများကို အဖြေအတွင်း ပြန်လည်ဖော်ပြတတ်စေရန် မော်ဒယ်ကို သင်ကြားပေးရန် ကြိုးပမ်းနေပါသည်။ o1 မော်ဒယ် စီးရီးအတွက် ကျွန်ုပ်တို့သည် chain of thought ၏ မော်ဒယ်ထုတ် summary ကို ပြသပါသည်။
o1 သည် AI reasoning ၏ state-of-the-art ကို သိသိသာသာ ရှေ့တိုးစေသည်။ ကျွန်ုပ်တို့သည် ဆက်လက် iteration လုပ်နေသည့်အတိုင်း ဤမော်ဒယ်၏ ပိုမိုကောင်းမွန်သော ဗားရှင်းများကို ထုတ်ပေးရန် စီစဉ်ထားသည်။ ဤ reasoning capability အသစ်များသည် မော်ဒယ်များကို လူ့တန်ဖိုးများနှင့် မူဝါဒများနှင့် ကိုက်ညီအောင် ညှိနှိုင်းနိုင်စွမ်းကို ပိုမိုကောင်းမွန်စေမည်ဟု ကျွန်ုပ်တို့ မျှော်လင့်ပါသည်။ o1 နှင့် ၎င်း၏ နောက်ဆက်ခံ မော်ဒယ်များသည် သိပ္ပံ၊ coding၊ သင်္ချာနှင့် ဆက်စပ်နယ်ပယ်များတွင် AI အတွက် အသုံးပြုမှုအသစ်များစွာကို ဖွင့်ပေးမည်ဟု ကျွန်ုပ်တို့ ယုံကြည်သည်။ ၎င်းက သူတို့၏ နေ့စဉ်အလုပ်ကို မည်သို့ ပိုမိုကောင်းမွန်စေမည်ကို အသုံးပြုသူများနှင့် API developer များက ရှာဖွေတွေ့ရှိကြမည်ကို ကျွန်ုပ်တို့ စိတ်လှုပ်ရှားနေပါသည်။
| ဒေတာအစု | မက်ထရစ် | gpt-4o | o1-preview | o1 |
|---|---|---|---|---|
| ပြိုင်ပွဲ သင်္ချာ AIME (2024) | cons@64 | ၁၃.၄ | ၅၆.၇ | ၈၃.၃ |
| pass@1 | ၉.၃ | ၄၄.၆ | ၇၄.၄ | |
| ပြိုင်ပွဲကုဒ် CodeForces | Elo | ၈၀၈ | ၁,၂၅၈ | ၁,၆၇၃ |
| ရာခိုင်နှုန်းအဆင့် | ၁၁.၀ | ၆၂.၀ | ၈၉.၀ | |
| GPQA Diamond | cons@64 | ၅၆.၁ | ၇၈.၃ | ၇၈.၀ |
| pass@1 | ၅၀.၆ | ၇၃.၃ | ၇၇.၃ | |
| ဇီဝဗေဒ | cons@64 | ၆၃.၂ | ၇၃.၇ | ၆၈.၄ |
| pass@1 | ၆၁.၆ | ၆၅.၉ | ၆၉.၂ | |
| ဓာတုဗေဒ | cons@64 | ၄၃.၀ | ၆၀.၂ | ၆၅.၆ |
| pass@1 | ၄၀.၂ | ၅၉.၉ | ၆၄.၇ | |
| ရူပဗေဒ | cons@64 | ၆၈.၆ | ၈၉.၅ | ၉၄.၂ |
| pass@1 | ၅၉.၅ | ၈၉.၄ | ၉၂.၈ | |
| သင်္ချာ | pass@1 | ၆၀.၃ | ၈၅.၅ | ၉၄.၈ |
| MMLU | pass@1 | ၈၈.၀ | ၉၂.၃ | ၉၀.၈ |
| MMMU (val) | pass@1 | ၆၉.၁ | n/a | ၇၈.၂ |
| MathVista (testmini) | pass@1 | ၆၃.၈ | n/a | ၇၃.၉ |
စာရေးသူများ
ကိုးကားချက်များ
- 1
- 2
ကျွန်ုပ်တို့၏ အကဲဖြတ်မှုများတွင် https://arxiv.org/abs/2305.20050(ဝင်းဒိုးအသစ်တွင် ဖွင့်မည်) တွင် တွေ့ရသော ပြဿနာ 500 ပါဝင်သည့် တူညီသော test split ကို အသုံးပြုခဲ့သည်
- 3