GPT‑5.6 बिल्डर्ससाठी मार्गदर्शिका
प्रत्यक्ष वापरातील स्टार्टअपकडून मिळालेले तांत्रिक धडे
GPT‑5.6 मॉडेल कुटुंबामुळे अत्याधुनिक पातळीवरील एजंटची कामगिरी अधिक परवडणारी होते आणि त्याचवेळी शक्यतांच्या सीमा आणखी विस्तारली जाते.
या मार्गदर्शिकेत, अधिक चतुर मॉडेल निवड आणि रीझनिंगमधील सातत्य, बहु-एजंट संयोजन व प्रोग्रामद्वारे टूल्सना कॉल करणे यासाठी उपयुक्त नवी API नियंत्रणे वापरून स्टार्टअप कमी खर्चात अधिक वेगवान आणि सक्षम एजंट कसे तयार करत आहेत, हे आम्ही दाखवतो.
GPT‑5 पासून प्रत्येक नव्या मॉडेल पिढीने कमी टोकनमध्ये अधिक दीर्घकालीन कामे हाताळण्याचा प्रयत्न केला आहे. GPT‑5.6 ही वाटचाल पुढे नेते: मूळ हार्नेसमध्ये अत्यल्प बदल करून एजंटची अधिक चांगली कामगिरी आणि कमी खर्च साधते.
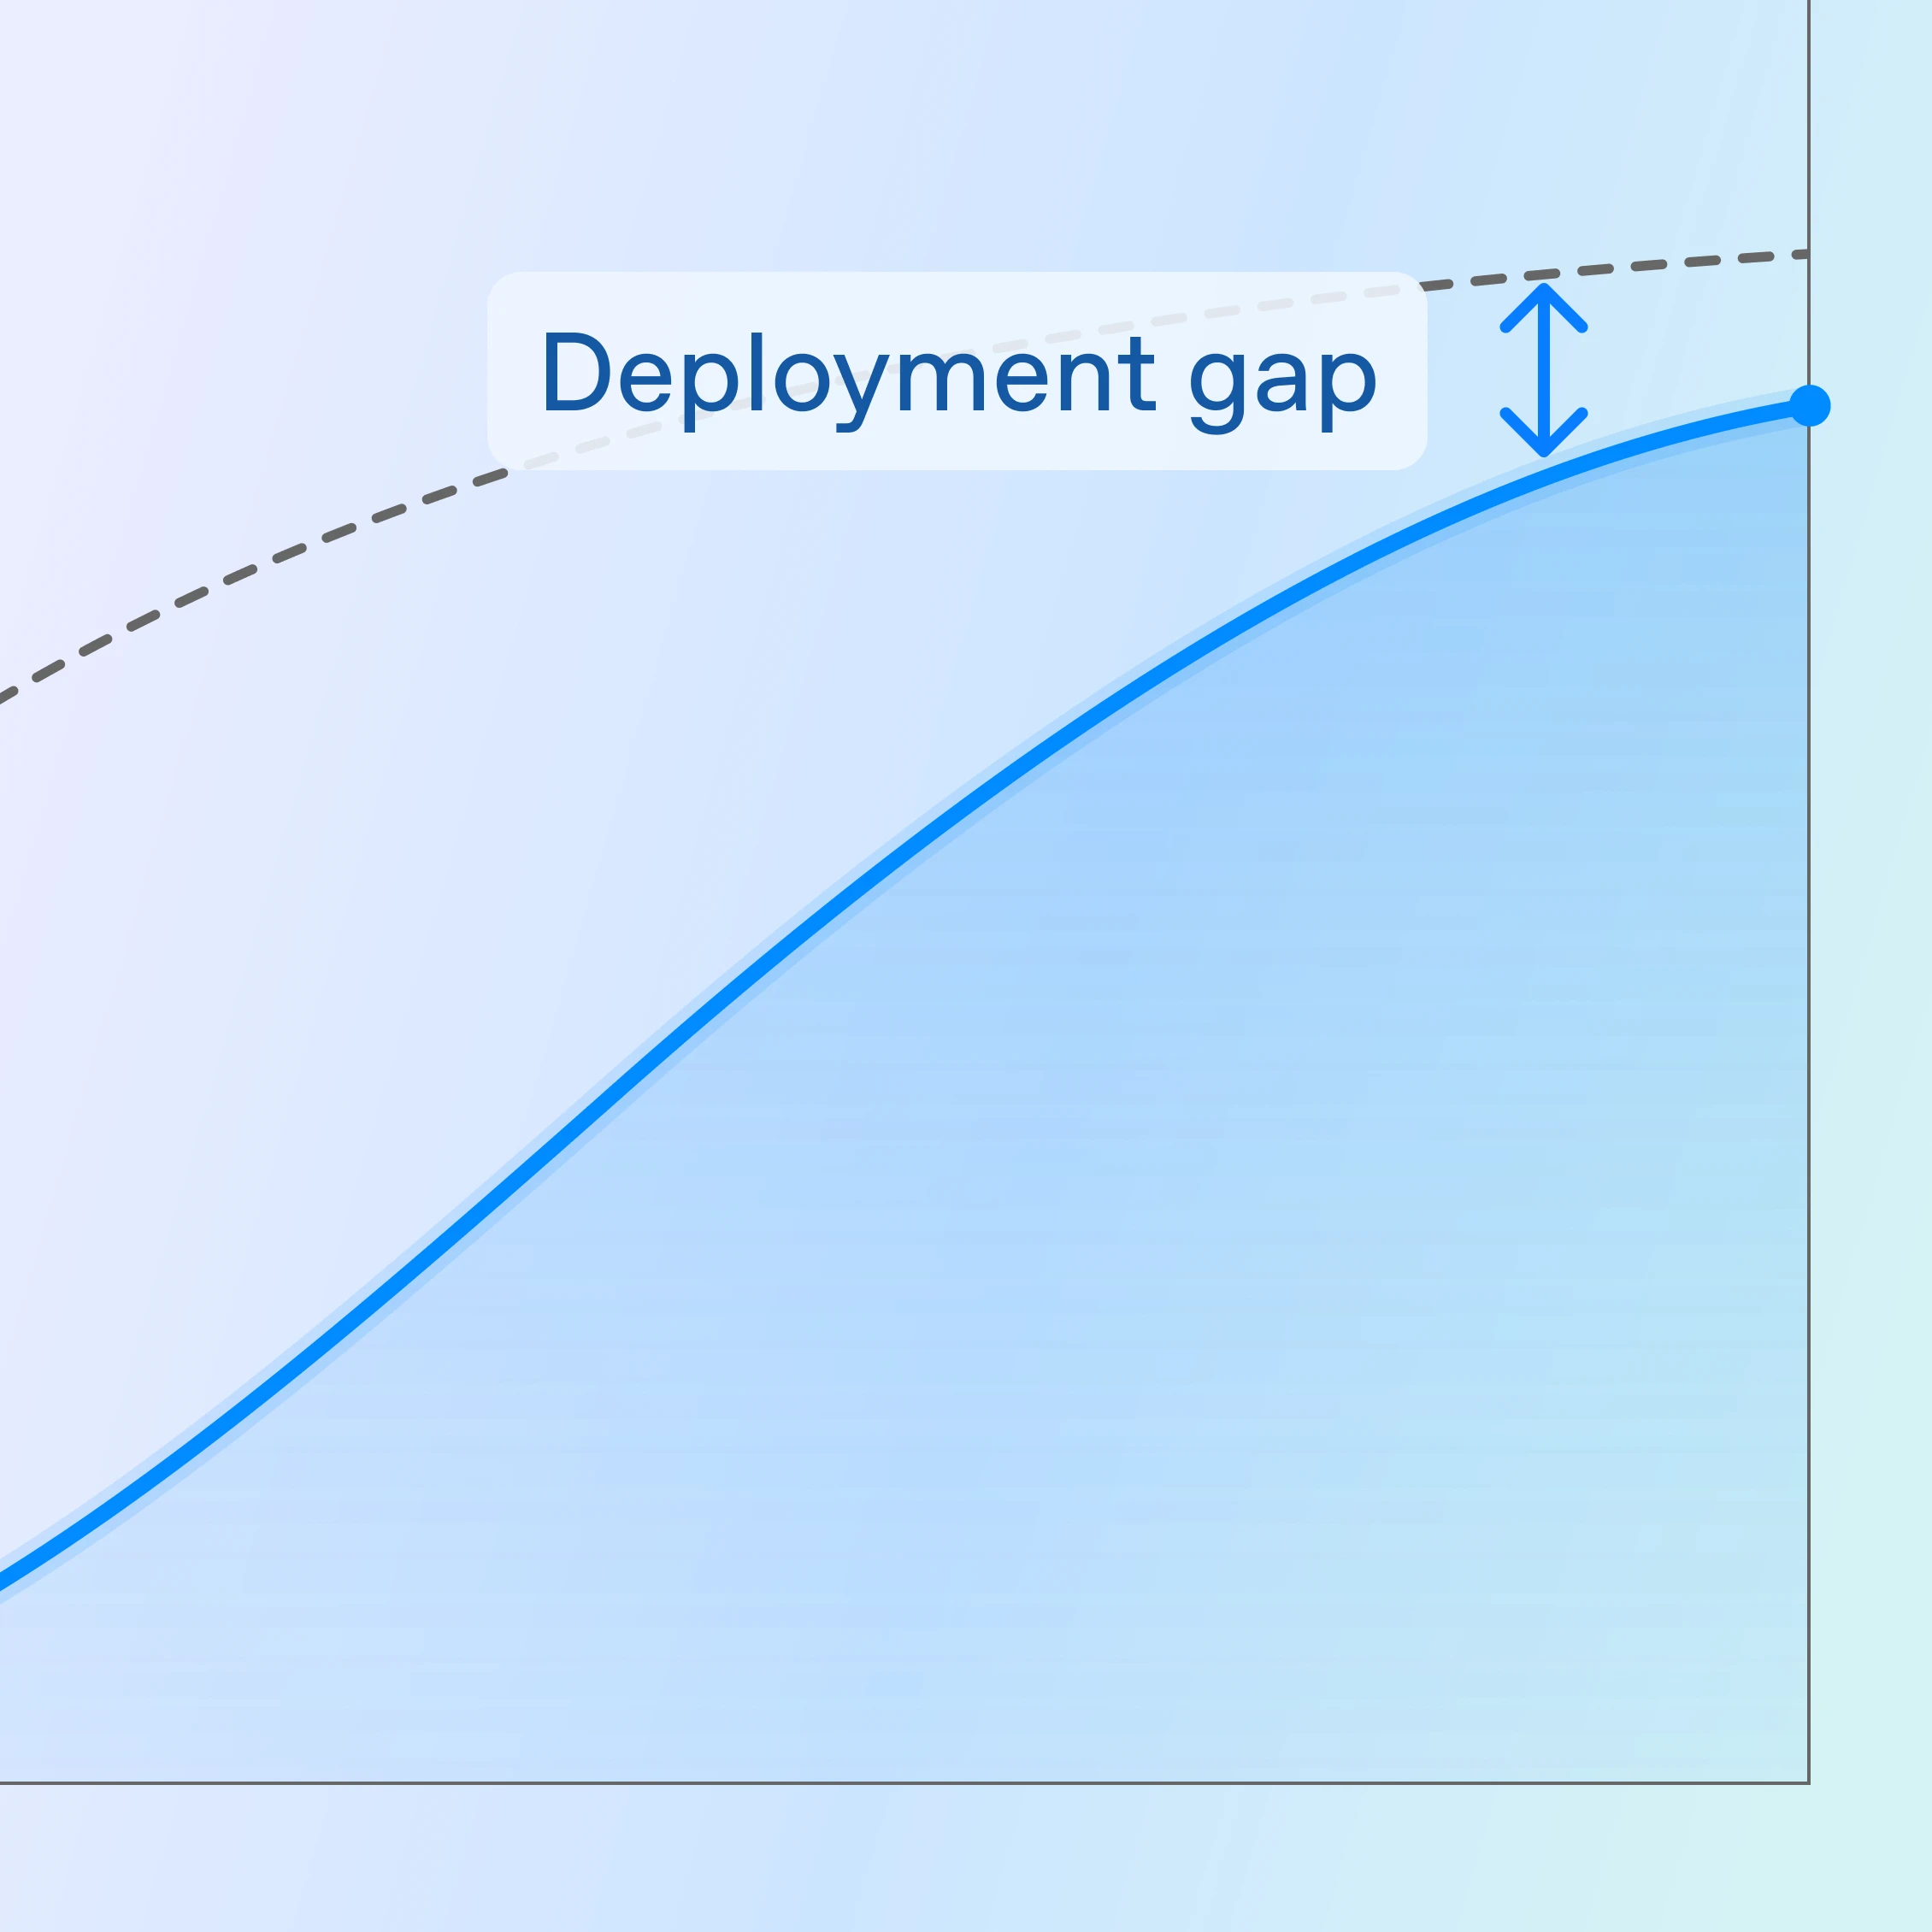
कमी रीझनिंग प्रयत्नांत वाढलेल्या अचूकतेमुळे एकूण खर्च-कार्यक्षमतेतील सुधारणा आणखी वाढते. उदाहरणार्थ, हार्नेस समान ठेवला असता Agents’ Last Exam मध्ये “कमी” रीझनिंगवरील GPT‑5.6 Sol ने “उच्च” रीझनिंगवरील GPT‑5.5 पेक्षा चांगली कामगिरी केली. उत्पादन चाचण्यांमध्येही अशीच यशस्वी उदाहरणे दिसली आहेत. पूर्वीच्या डीफॉल्टच्या तुलनेत रीझनिंग प्रयत्न कमी केल्यामुळे अनेक कार्यप्रवाहांमध्ये खर्चात लक्षणीय सुधारणा झाल्याचे स्टार्टअप सांगतात.
यापूर्वी, दीर्घकालीन वापर-प्रकरणांसाठी उपलब्ध सर्वोच्च रीझनिंगसह फ्लॅगशिप मॉडेलवर अपग्रेड करणे हा सर्वोत्तम पर्याय होता. याचे प्रमुख कारण म्हणजे दीर्घ संदर्भ आणि टूल्सना कॉल करणे हाताळताना ही मॉडेल खर्चासाठी अनुकूल केलेल्या मॉडेलपेक्षा लक्षणीयरीत्या अधिक सक्षम होती. 5.6 कुटुंबामुळे हे बदलले आहे: चाचणीच्या वेळी अधिक गणन क्षमता वापरून Luna आणि Terra अनेकदा GPT‑5.4 व 5.5 सारखी कामगिरी करतात, पण त्यांचा खर्च लक्षणीयरीत्या कमी असतो.
BrowseComp मधील कामांचा विचार करा: अप्रसिद्ध तथ्ये शोधण्याची मॉडेलची क्षमता तपासणारा हा शोधाधारित बेंचमार्क आहे. तीन महिन्यांपूर्वी GPT‑5.5 ने (अत्युच्च) या बेंचमार्कवर $33.27 एकूण खर्चात 84.36% गुण मिळवले. लाँचच्या वेळी GPT‑5.6 Luna (अत्युच्च) जवळपास तितकीच कामगिरी देते आणि $1.33 खर्चात 84.04% गुण मिळवते. त्यानंतर आम्ही किमती आणखी कमी केल्या आहेत. आमच्या अलीकडील किंमत कपातीबद्दल आणखी वाचा.
5.6 कुटुंबातील मॉडेल्स लहान असूनही मोठ्या प्रमाणातील कामे, लॅटन्सीबाबत संवेदनशील इंटरॅक्शन आणि एजंट-आधारित कार्यप्रवाहांतील पुनरावृत्तीच्या टप्प्यांसाठी उत्तम आहेत. उदाहरणार्थ, एजंट-आधारित विश्लेषणापूर्वी हस्तलिखित नोंदींचे विश्लेषण करणारे कायदे-तंत्रज्ञान स्टार्टअप तुम्ही चालवत असल्यास, संपूर्ण कामासाठी अत्याधुनिक मॉडेल वापरण्याऐवजी आता माहिती काढण्यासाठी Terra किंवा Luna वापरून खर्चात मोठी बचत करू शकता.
GPT‑5.6 वापरण्यास तयार असतानाच अधिक कार्यक्षम करण्याबरोबरच पुढील सुधारणा शक्य करण्यासाठी आम्ही Responses API मध्ये नवे मूलभूत घटकही आणले. एजंटना अधिक कार्यक्षमतेने काम करता यावे यासाठी आम्ही परस्परपूरक अशा तीन संरचना हस्तक्षेपांसह GPT‑5.6 ला सुरुवातीपासून शेवटपर्यंत प्रशिक्षित केले:
आधी केलेले काम पुन्हा वापरा: मॉडेलच्या फेऱ्यांदरम्यान रीझनिंग जतन करून(नवीन विंडोमध्ये उघडेल) आणि दीर्घकाळ चालणारे संवाद संक्षिप्त करण्यासाठी नेटिव्ह कॉम्पॅक्शन(नवीन विंडोमध्ये उघडेल) वापरून, मॉडेल गोंधळून न जाता किंवा आधीचा संदर्भ पुन्हा तयार न करता अधिक दीर्घकालीन कामांमध्ये सातत्य राखू शकते.
योग्य ठिकाणी समांतर विभाजन: नेटिव्ह बहु-एजंट संयोजन(नवीन विंडोमध्ये उघडेल) वापरल्याने अनेक एजंटचा समांतर कार्यप्रवाहांमध्ये समन्वय साधून गुंतागुंतीची कामे अधिक वेगाने पूर्ण करता येतात.
निश्चित नियमांनुसार होणारे काम कोडमध्ये हलवा: मॉडेलच्या कॉन्टेक्स्ट विंडोबाहेर टूल्सचे आउटपुट फिल्टर करणे, एकत्रित करणे आणि संयोजित करण्यासाठी प्रोग्रामद्वारे टूल्सना कॉल करणे(नवीन विंडोमध्ये उघडेल) वापरून, मॉडेलचे टोकन निर्णयक्षमतेसाठी आणि खर्च, लॅटन्सी व संदर्भाचा ऱ्हास कमी करण्यासाठी राखून ठेवले जातात.
हे एकत्र वापरल्यास परिणामातील फरक विलक्षण असू शकतो. उदाहरणार्थ, स्टँडर्ड हार्नेससह ARC-AGI-3 वर GPT‑5.6 Sol ने 13.3% गुण मिळवले. मात्र, जतन केलेले रीझनिंग आणि कॉम्पॅक्शन सुरू केल्यानंतर सुमारे 6 पट कमी आउटपुट टोकन वापरूनही गुण 38.3%पर्यंत वाढले. मॉडेलमध्ये कोणताही बदल नाही, पण कामगिरी जवळपास तिप्पट झाली. आमच्या ARC-AGI-3 हार्नेस तपासाबद्दल येथे अधिक माहिती मिळेल.
एजंट-आधारित कार्यप्रवाहांमध्ये अनेकदा दोन प्रकारची कामे असतात:
निर्णयक्षमतेची गरज असलेली कामे
मुख्यतः माहिती हलवणे, फिल्टर करणे आणि एकत्रित करण्याची कामे
एजंट 100 फाइल केलेली कागदपत्रे मिळवून तारखेनुसार फिल्टर करतो आणि संबंधित व्यवहार ओळखतो, तर मॉडेलला त्याच्या कॉन्टेक्स्ट विंडोमधील प्रत्येक मधल्या निकालावर रीझनिंग करण्याची गरज नसावी. प्रोग्रामद्वारे टूल्सना कॉल करताना GPT‑5.6 टूल्सचे संयोजन करण्यासाठी JavaScript लिहू शकते, स्वतंत्र कॉल्स समांतरपणे चालवू शकते आणि त्यांच्या आउटपुटवर कॉन्टेक्स्ट विंडोबाहेर प्रक्रिया करू शकते. त्यामुळे मॉडेल बुद्धिमत्ता आवश्यक असलेल्या गोष्टीवर, म्हणजे निर्णयक्षमतेच्या वापरावर, लक्ष केंद्रित करू शकते.
गुंतागुंतीच्या आणि समांतरपणे करता येणाऱ्या कामांमध्ये अनेक एजंट कार्यप्रवाहांदरम्यान कृती व रीझनिंगचे वितरण केल्याने काम जलद पूर्ण होते आणि बुद्धिमत्ताही वाढते. अशा व्यवस्थांमध्ये उप-एजंटचे संयोजन करणे आणि त्यांना कामे सोपवणे ही मुख्य एजंटची जबाबदारी असते. उप-एजंट आपापली उद्दिष्टे समांतरपणे पूर्ण करतात आणि शेवटी अंतिम संकलनासाठी आपले आउटपुट मुख्य एजंटकडे परत पाठवतात. Responses API मध्ये बहु-एजंट सक्षम करून(नवीन विंडोमध्ये उघडेल) टीम्स थेट या क्षमतेचा लाभ घेऊ शकतात. ChatGPT मधील Ultra क्षमता सेटिंगही अशाच प्रकारे काम करते.
“Qualia मुक्त स्वरूपाच्या संशोधन समस्यांवर एजंटची एक टीम चालवते आणि GPT‑5.6 Sol त्यासाठी अगदी योग्य ठरले. GPT‑5.5 च्या तुलनेत त्यात लक्षणीय सुधारणा दिसली, आम्ही तपासलेल्या जवळपास प्रत्येक मॉडेलपेक्षा त्याने काम लवकर पूर्ण केले आणि ते झटपट आमचे पसंतीचे OpenAI मॉडेल बनले.”
“GPT‑5.6 हा आम्ही पाहिलेला OpenAI चा सर्वोत्तम संयोजक आहे. आम्ही त्याला एकाच वेळी सहा स्पेक दिले आणि त्या सर्वांवर लेखन, निर्मिती आणि चर्चा करण्यास सांगितले, तरीही गुणवत्तेत घसरण होऊ न देता त्याने प्रत्येक गोष्टीचा मागोवा ठेवला.”
उप-एजंटची योग्य संख्या आणि ते केव्हा तयार करावेत याची GPT‑5.6 ला चांगली जाण असली, तरी बहु-एजंट वर्तनाला सहज दिशा देता येते. उप-एजंटना केव्हा कॉल करायचा याबद्दल मॉडेलला सूचना दिल्यास, अतिरिक्त टोकन खर्च केल्यामुळे चांगली कामगिरी मिळेल अशाच परिस्थितीत एजंट तयार होण्याची शक्यता वाढते.
संपूर्ण मॉडेल कुटुंबासाठी प्रॉम्प्ट कॅशचा TTL किमान 30 मिनिटांपर्यंत वाढवला आहे आणि आता मॉडेलच्या कॉन्टेक्स्ट विंडोमध्ये निश्चितपणे कॅश ब्रेकपॉइंट ठरवता येतात. यामुळे स्टार्टअपना त्यांच्या कॅश हिटचे प्रमाण लक्षणीयरीत्या वाढवता आले आहे.
कॅश एंडपॉइंट ठरवण्याबरोबरच योग्य prompt_cache_key(नवीन विंडोमध्ये उघडेल) वापरत राहिल्याने, तोच उपसर्ग यापूर्वी हाताळलेल्या निष्कर्ष इंजिनवर विनंत्या पोहोचण्याची शक्यता वाढते आणि त्यामुळे लॅटन्सी कमी होते.
या सर्व उदाहरणांमध्ये एजंट तयार करण्याचे अर्थकारण किती बदलले आहे, ही बाब विशेष ठळकपणे दिसते.
पूर्वी प्रत्येक टप्प्यावर अत्याधुनिक मॉडेल आवश्यक असलेल्या वापर प्रकरणांमध्ये आता लहान मॉडेल वापरून, रीझनिंगचे कमी करून आणि कार्यक्षम आर्किटेक्चर पर्याय निवडून अत्यल्प खर्चात समान किंवा अधिक चांगले परिणाम साधता येतात.
तुम्ही सर्वजण काय तयार करता, हे पाहण्यासाठी आम्ही खूप उत्सुक आहोत!
- 2026
- API प्लॅटफॉर्म
लेखकांविषयी
सुरुवातीच्या चाचण्यांपासून प्रत्यक्ष वापरापर्यंत GPT‑5.6 वर उत्पादने उभारणाऱ्या स्टार्टअपसोबत जवळून काम करण्याच्या अनुभवावर आधारित ही मार्गदर्शिका समर्थ मुदुरू(नवीन विंडोमध्ये उघडेल), प्रशांत मित्तल(नवीन विंडोमध्ये उघडेल), डेव्ह लियो(नवीन विंडोमध्ये उघडेल) आणि जूलियन रायमन(नवीन विंडोमध्ये उघडेल) यांनी तयार केले आहे.