OpenAI ಜೊತೆ ಆಂಪ್ಲಿಟ್ಯೂಡ್: 1–2 ದಿನಗಳಲ್ಲಿ ಸುಧಾರಣೆ
ಮುಖ್ಯವಾಗಿ OpenAI ಮಾಡೆಲ್ಗಳ ಆಧಾರಿತ ಆಂಪ್ಲಿಟ್ಯೂಡ್ನ ವೇವ್ ಉತ್ಪನ್ನ ಏಜೆಂಟ್ ಸ್ವಯಂಪ್ರೇರಿತವಾಗಿ ಏನನ್ನು ರೂಪಿಸಬೇಕೆಂದು ಗುರುತಿಸುತ್ತದೆ, ಕೋಡಿಂಗ್ ಏಜೆಂಟ್ಗಳ ನೆರವಿನಿಂದ ಬದಲಾವಣೆಗಳನ್ನು ಜಾರಿಗೊಳಿಸಲು ತಂಡಗಳಿಗೆ ಸಹಾಯ ಮಾಡುತ್ತದೆ ಮತ್ತು ಪರಿಣಾಮವನ್ನು ಅಳೆಯುತ್ತದೆ.
160%
ಒಂದು ದಿನದ ನಂತರ ನಿಯಂತ್ರಣ ಗುಂಪಿಗೆ ಹೋಲಿಸಿದರೆ ಏಜೆಂಟ್ ಜೊತೆಗಿನ ಸಂವಹನದಲ್ಲಿನ ಏರಿಕೆ
1–2 ದಿನಗಳು
ವೇವ್ ನೆರವಿನಿಂದ ಉತ್ಪನ್ನ ಸುಧಾರಣೆಯನ್ನು ಬಿಡುಗಡೆ ಮಾಡಲು ಬೇಕಾಗುವ ಅಂದಾಜು ಸಮಯ
51%
ಆಂಪ್ಲಿಟ್ಯೂಡ್ನ ದತ್ತಾಂಶ ವಿಜ್ಞಾನ ಏಜೆಂಟ್ ಮೌಲ್ಯಮಾಪನದಲ್ಲಿ GPT‑6.1 Sol ಗೆ ಪ್ರತಿ ಕಾರ್ಯ ರವಾನೆಯ ಸರಾಸರಿ ಮಾಡೆಲ್ ವೆಚ್ಚದಲ್ಲಿನ ಇಳಿಕೆ.
$1.34
ಆಂಪ್ಲಿಟ್ಯೂಡ್ನ ಅವಕಾಶ ಪರಿಶೋಧಕ ಮೌಲ್ಯಮಾಪನದಲ್ಲಿ GPT‑6.1 Sol ಮಾಡೆಲ್ನ ವೆಚ್ಚ.
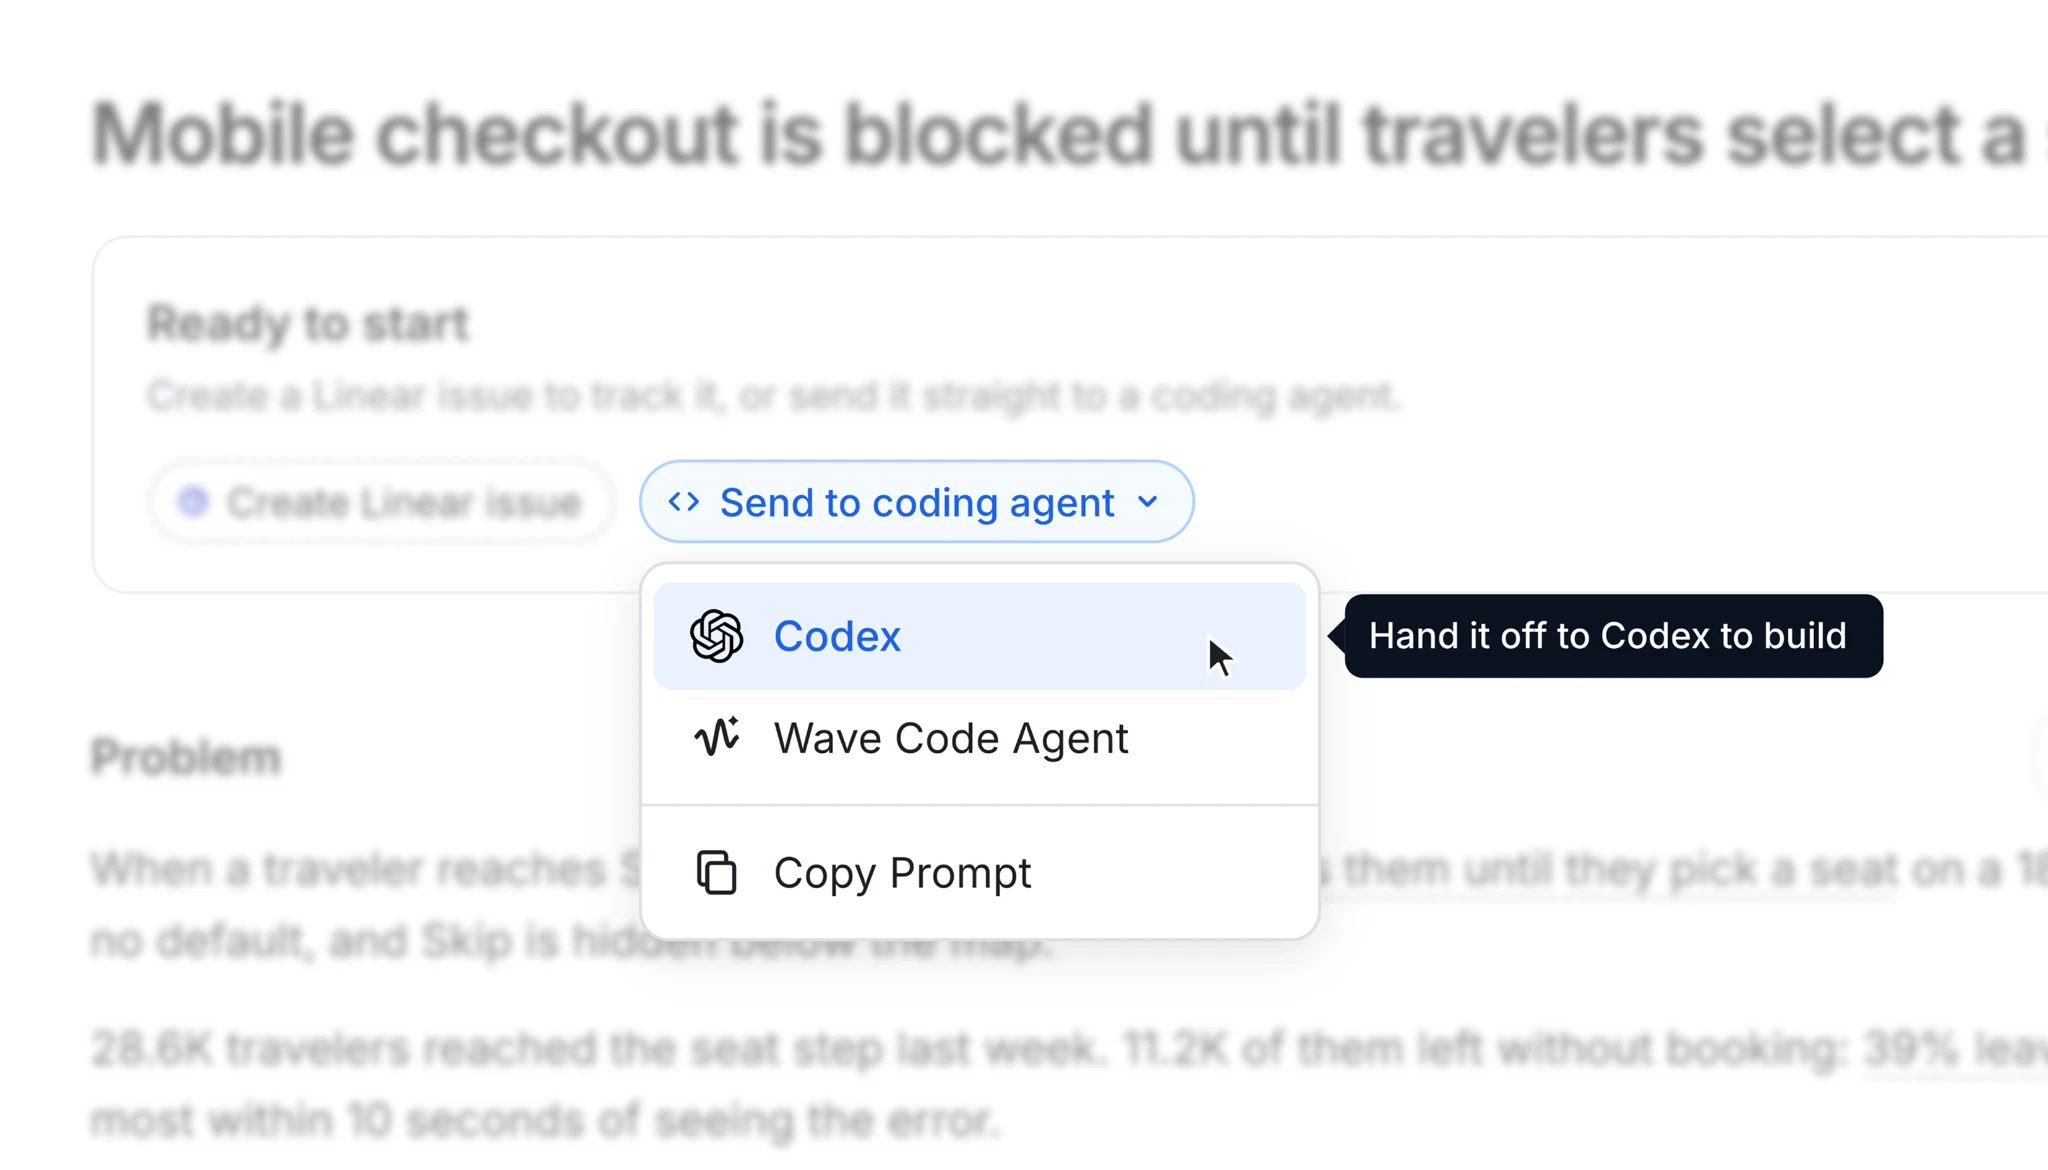
ಜನರು ತಮ್ಮ ಉತ್ಪನ್ನಗಳನ್ನು ನಿಜವಾಗಿ ಹೇಗೆ ಬಳಸುತ್ತಾರೆ ಎಂಬುದನ್ನು ತಿಳಿಯಲು ಆಂಪ್ಲಿಟ್ಯೂಡ್ ಸದಾ ತಂಡಗಳಿಗೆ ನೆರವಾಗಿದೆ. ಮುಂಚೂಣಿಯಲ್ಲಿ ಕಾರ್ಯನಿರ್ವಹಿಸುವ ಅದರ ಉತ್ಪನ್ನ ಏಜೆಂಟ್ ವೇವ್, ಆ ಒಳನೋಟಗಳನ್ನು ಕಾರ್ಯರೂಪಕ್ಕೆ ಬಂದ ಸುಧಾರಣೆಗಳಾಗಿ ಪರಿವರ್ತಿಸಲು ತಂಡಗಳಿಗೆ ನೆರವಾಗುತ್ತದೆ. ವೇವ್ನ ಸುಮಾರು 80% ಕಾರ್ಯನಿರ್ವಹಣೆಗೆ GPT‑6.1 Sol, GPT‑6 Luna ಮತ್ತು GPT‑Image‑2.5 Flare ಸೇರಿದಂತೆ OpenAI ಮಾಡೆಲ್ಗಳು ಆಧಾರವಾಗಿವೆ ಎಂದು ಆಂಪ್ಲಿಟ್ಯೂಡ್ ಹೇಳುತ್ತದೆ. ವೇವ್ ಉತ್ಪನ್ನದ ಒಳನೋಟಗಳನ್ನು ಅನುಷ್ಠಾನ ಯೋಜನೆಗಳಾಗಿ ರೂಪಿಸುತ್ತದೆ. ತಂಡಗಳು ಈ ಯೋಜನೆಗಳನ್ನು Codex ಸೇರಿದಂತೆ ಕೋಡಿಂಗ್ ಏಜೆಂಟ್ಗಳಿಗೆ ಕಳುಹಿಸಬಹುದು. ಬಳಿಕ ವೇವ್ ಅವುಗಳ ಪರಿಣಾಮವನ್ನು ಅಳೆಯುತ್ತದೆ.
ಸುಮಾರು ಒಂದು ತಿಂಗಳು ಬೇಕಾಗುತ್ತಿದ್ದ ಉತ್ಪನ್ನ ಸುಧಾರಣೆಗಳನ್ನು ವೇವ್ ನೆರವಿನಿಂದ ತಂಡಗಳು 1–2 ದಿನಗಳಲ್ಲಿ ಬಿಡುಗಡೆ ಮಾಡಬಹುದು ಎಂದು ಆಂಪ್ಲಿಟ್ಯೂಡ್ ಅಂದಾಜಿಸಿದೆ. ಆಂಪ್ಲಿಟ್ಯೂಡ್ನ ಸ್ವಂತ ಮುಖಪುಟದಲ್ಲಿ ಸಲಹೆ ಕಾರ್ಡ್ಗಳನ್ನು ವೈಯಕ್ತೀಕರಿಸಲು ವೇವ್ ನೆರವಾಯಿತು. ಇದರಿಂದ ಕಾರ್ಡ್ಗಳ ಮೂಲಕ ಕಳುಹಿಸಿದ ಸಂದೇಶಗಳು 160% ಹೆಚ್ಚಾದವು.
“AI ಗೆ ವಹಿಸಬೇಕೆಂದು ನಾವು ಯೋಚಿಸಿಯೇ ಇರದ ಉಪಯುಕ್ತ ಕೆಲಸಗಳನ್ನು ಈಗ ಅದು ಕಂಡುಕೊಳ್ಳಬಲ್ಲದು. OpenAI ಮಾಡೆಲ್ಗಳು ಸಮಸ್ಯೆಯನ್ನು ಪರಿಶೋಧಿಸಬಲ್ಲವು, ಕೋಡ್ ಬರೆದು ಚಲಾಯಿಸಬಲ್ಲವು ಮತ್ತು ಅದರ ಫಲಿತಾಂಶಗಳಿಂದ ಮುಂದೆ ಏನನ್ನು ಪ್ರಯತ್ನಿಸಬೇಕೆಂದು ನಿರ್ಧರಿಸಬಲ್ಲವು.”
ವೇವ್ ಆಂಪ್ಲಿಟ್ಯೂಡ್ನ ಮುಂಚೂಣಿಯಲ್ಲಿ ಕಾರ್ಯನಿರ್ವಹಿಸುವ ಉತ್ಪನ್ನ ಏಜೆಂಟ್ ಆಗಿದೆ. ತಂಡಗಳು ಅದಕ್ಕೆ ಉತ್ಪನ್ನದ ಒಂದು ಕ್ಷೇತ್ರವನ್ನು ಹಾಗೂ ಸಾಧಿಸಬೇಕಾದ ಗುರಿಗಳು ಮತ್ತು ಸುಧಾರಿಸಬೇಕಾದ ಮಾಪಕಗಳನ್ನು ನೀಡುತ್ತವೆ. ವೇವ್ ಆಂಪ್ಲಿಟ್ಯೂಡ್ ದತ್ತಾಂಶ, ಬಳಕೆಯ ಅವಧಿಗಳ ಮರುಪ್ರದರ್ಶನಗಳು, ಗ್ರಾಹಕರ ಪ್ರತಿಕ್ರಿಯೆ ಮತ್ತು ಕೋಡ್ಗಳನ್ನು ಒಟ್ಟುಗೂಡಿಸುತ್ತದೆ. ಇವುಗಳ ನೆರವಿನಿಂದ ಅವಕಾಶಗಳನ್ನು ಗುರುತಿಸಿ ಆದ್ಯತೆ ನೀಡುತ್ತದೆ, ಪರಿಹಾರಗಳನ್ನು ರೂಪಿಸುತ್ತದೆ ಮತ್ತು ಜನರು ಹಾಗೂ ಕೋಡಿಂಗ್ ಏಜೆಂಟ್ಗಳೊಂದಿಗೆ ಅನುಷ್ಠಾನವನ್ನು ಸಮನ್ವಯಗೊಳಿಸುತ್ತದೆ. ಬಳಿಕ ಅದು ಫಲಿತಾಂಶಗಳನ್ನು ಗಮನಿಸುತ್ತಾ, ಕಲಿತ ಪಾಠಗಳನ್ನು ಮುಂದಿನ ಸುತ್ತಿನ ಸುಧಾರಣೆಗಳಿಗೆ ಬಳಸುತ್ತದೆ.
ಈ ಕಾರ್ಯಪ್ರವಾಹದ ಹಿಂದೆ, ಆಂಪ್ಲಿಟ್ಯೂಡ್ ಬೇರೆ ಬೇರೆ ಕೆಲಸಗಳಿಗೆ ಬೇರೆ ಬೇರೆ OpenAI ಮಾಡೆಲ್ಗಳನ್ನು ಬಳಸುತ್ತದೆ. GPT‑6.1 Sol ಅವಕಾಶ ನಿರ್ವಾಹಕಕ್ಕೆ ಹಾಗೂ ಕೋಡ್ ಮತ್ತು ದತ್ತಾಂಶದ ಆಳವಾದ ಪರಿಶೋಧನೆಗಳಿಗೆ ನೆರವಾಗುತ್ತದೆ. ಕೋಡ್ ಪರಿಶೀಲಿಸುವುದು ಮತ್ತು ಸಣ್ಣ ಮೌಲ್ಯಮಾಪನ ಪರೀಕ್ಷೆಗಳನ್ನು ನಡೆಸುವುದರಂತಹ ಪದೇ ಪದೇ ಮಾಡಬೇಕಾದ, ಕಡಿಮೆ ವೆಚ್ಚದ ಕೆಲಸಗಳನ್ನು GPT‑6 Luna ನಿರ್ವಹಿಸುತ್ತದೆ. GPT‑Image‑2.5 Flare ಬಳಕೆಯ ಅವಧಿಗಳ ಮರುಪ್ರದರ್ಶನಗಳಿಂದ ಪಡೆದ ತೆರೆಚಿತ್ರಗಳನ್ನು ದೃಶ್ಯ ಉಲ್ಲೇಖಗಳಾಗಿ ಬಳಸಿಕೊಂಡು ಉತ್ಪನ್ನದ ಅಣಕು ವಿನ್ಯಾಸಗಳನ್ನು ರಚಿಸುತ್ತದೆ.
ಒಂದು ಅವಕಾಶವನ್ನು ಕಾರ್ಯರೂಪಕ್ಕೆ ತರಲು ಸಿದ್ಧವಾದಾಗ, ತಂಡಗಳು ಅದನ್ನು ವೇವ್ನಿಂದ ನೇರವಾಗಿ Codex ಸೇರಿದಂತೆ ಕೋಡಿಂಗ್ ಏಜೆಂಟ್ಗಳಿಗೆ ಕಳುಹಿಸಬಹುದು. ಅನುಷ್ಠಾನಕ್ಕೆ ಮಾರ್ಗದರ್ಶನ ನೀಡಲು ತಾಂತ್ರಿಕ ಯೋಜನೆ ಮತ್ತು ಸ್ವೀಕೃತಿ ಮಾನದಂಡಗಳನ್ನೂ ಜೊತೆಗೆ ಒದಗಿಸಬಹುದು.
“ಉತ್ಪನ್ನಗಳನ್ನು ಸುಧಾರಿಸುವ ಅವಕಾಶಗಳನ್ನು ಹುಡುಕಲು ಅಪಾರ ಪ್ರಮಾಣದ ಬಳಕೆಯ ಮರುಪ್ರದರ್ಶನಗಳು, ವಿಶ್ಲೇಷಣೆಗಳು ಮತ್ತು ಕೋಡ್ಗಳನ್ನು ಕೂಲಂಕಷವಾಗಿ ಪರಿಶೀಲಿಸುವ ಏಜೆಂಟ್ಗಳಿರುವ ಏಕೀಕೃತ ವೇದಿಕೆಯನ್ನು ಒದಗಿಸುವುದೇ ವೇವ್ನ ಕಲ್ಪನೆ,” ಎಂದು ಆಂಪ್ಲಿಟ್ಯೂಡ್ನ ಪ್ರಧಾನ AI ಉತ್ಪನ್ನ ವ್ಯವಸ್ಥಾಪಕ ಜೇಕಬ್ ನ್ಯೂಮನ್ ವಿವರಿಸುತ್ತಾರೆ.
ಆಂಪ್ಲಿಟ್ಯೂಡ್ ತನ್ನದೇ ಮುಖಪುಟದಲ್ಲಿ ವೇವ್ ಅನ್ನು ಪರೀಕ್ಷಿಸಿತು. ಅಲ್ಲಿ ಸಾಮಾನ್ಯ ಸಲಹೆ ಕಾರ್ಡ್ಗಳು ಬಳಕೆದಾರರು AI ಏಜೆಂಟ್ ಜೊತೆ ಸಂವಾದ ಆರಂಭಿಸಲು ನೆರವಾಗಬೇಕಿತ್ತು. ಜನರು ಆಗಾಗ ಆ ಕಾರ್ಡ್ಗಳನ್ನು ಬಳಸದೇ ಮುಂದುವರಿಯುವುದನ್ನು ವೇವ್ ಕಂಡುಕೊಂಡಿತು: 100 ಬಳಕೆಯ ಅವಧಿಗಳ ಮರುಪ್ರದರ್ಶನಗಳ ಮಾದರಿಯಲ್ಲಿ, 80 ಬಳಕೆದಾರರು ತಮ್ಮದೇ ಪ್ರಶ್ನೆಗಳನ್ನು ಟೈಪ್ ಮಾಡಿದ್ದರು ಮತ್ತು ಕೇವಲ 12 ಜನರು ಸಲಹೆಯೊಂದನ್ನು ಆಯ್ಕೆ ಮಾಡಿದ್ದರು.
ಇತ್ತೀಚಿನ ಚಾರ್ಟ್ಗಳು, ಮಾಹಿತಿ ಫಲಕಗಳು ಅಥವಾ ಬಳಕೆದಾರರು ಬಂದ ಪುಟದ ಆಧಾರದ ಮೇಲೆ ಕಾರ್ಡ್ಗಳನ್ನು ವೈಯಕ್ತೀಕರಿಸಲು ವೇವ್ ಪ್ರಸ್ತಾಪಿಸಿತು. ಅದು ಬದಲಾವಣೆಯ ಚಿತ್ರಣ ನೀಡಿ ತಾಂತ್ರಿಕ ಯೋಜನೆಯನ್ನು ರೂಪಿಸಿತು. ಬಳಕೆದಾರರು ಸ್ವತಂತ್ರವಾಗಿ ಟೈಪ್ ಮಾಡುವ ಸೌಲಭ್ಯವನ್ನು ಉಳಿಸುವುದು ಮತ್ತು ವೈಯಕ್ತೀಕರಣಕ್ಕೆ ಬೇಕಾದ ಸಂದರ್ಭ ಲಭ್ಯವಿಲ್ಲದಾಗ ಸಾಮಾನ್ಯ ಸಲಹೆಗಳನ್ನು ತೋರಿಸುವುದೂ ಈ ಯೋಜನೆಯಲ್ಲಿತ್ತು. ಸಂಕ್ಷಿಪ್ತ ಪರಿಶೀಲನೆಯ ಬಳಿಕ ತಂಡವು ಕೆಲಸವನ್ನು ಕೋಡಿಂಗ್ ಏಜೆಂಟ್ಗೆ ವಹಿಸಿ, ಬದಲಾವಣೆಯ A/B ಪರೀಕ್ಷೆ ನಡೆಸಿತು.
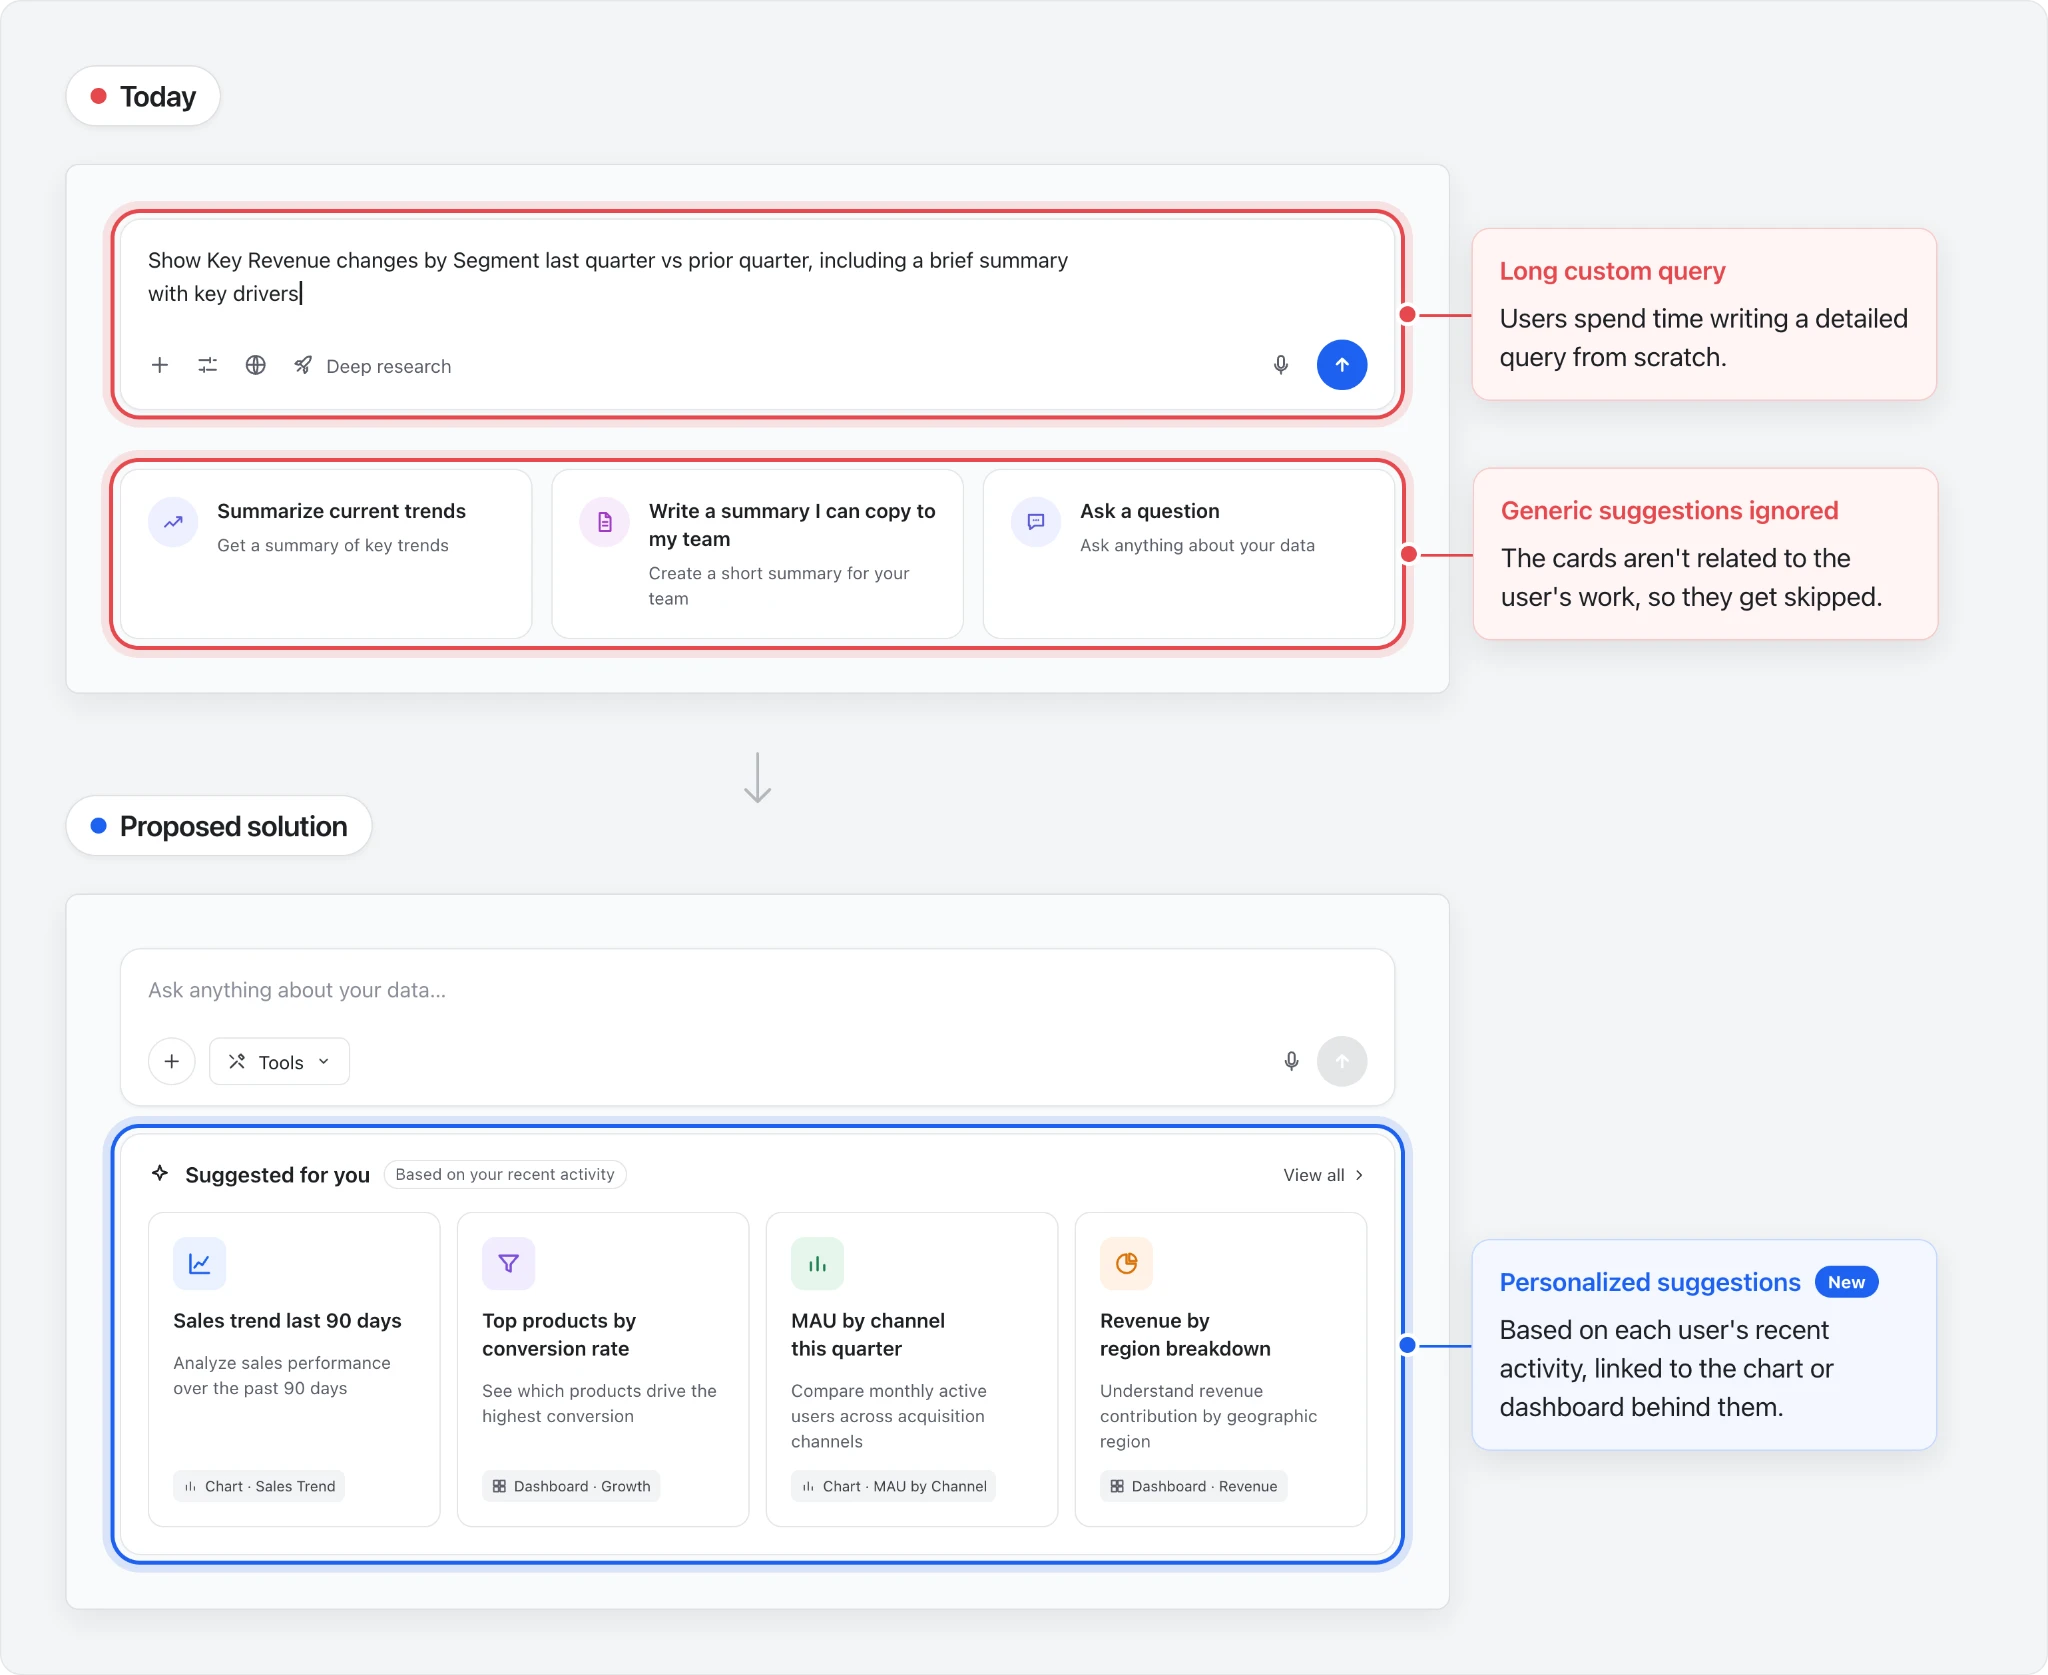
ಆಂಪ್ಲಿಟ್ಯೂಡ್ ಹಂಚಿಕೊಂಡ ಪ್ರಯೋಗದ ಫಲಿತಾಂಶಗಳ ಪ್ರಕಾರ, ಒಂದು ದಿನದ ನಂತರ ಮುಖಪುಟದ ಸಲಹೆ ಕಾರ್ಡ್ಗಳ ಮೂಲಕ ಕಳುಹಿಸಿದ ಸಂದೇಶಗಳು ನಿಯಂತ್ರಣ ಗುಂಪಿಗೆ ಹೋಲಿಸಿದರೆ 160% ಹೆಚ್ಚಾದವು. “ಕ್ರಾಂತಿಕಾರಿಯೇನಲ್ಲವೆಂದು ಕಡೆಗಣಿಸಲ್ಪಡುವ ಸಣ್ಣ ವಿಷಯಗಳೂ ವೈಶಿಷ್ಟ್ಯಗಳ ಬಳಕೆಯನ್ನು ಅನಿರೀಕ್ಷಿತ ರೀತಿಯಲ್ಲಿ ಹೇಗೆ ಹೆಚ್ಚಿಸಬಲ್ಲವು ಎಂಬುದಕ್ಕೆ ಇದು ಉತ್ತಮ ಉದಾಹರಣೆ,” ಎಂದು ಆಂಪ್ಲಿಟ್ಯೂಡ್ನ ಹಿರಿಯ ಪ್ರಧಾನ AI ಎಂಜಿನಿಯರ್ ಎರಿಕ್ ಕಾರ್ಲ್ಸನ್ ವಿವರಿಸುತ್ತಾರೆ.
ವೇವ್ನ ವಿವಿಧ ಕೆಲಸಗಳಿಗೆ ಅದರ ಮಾಡೆಲ್ಗಳಿಂದ ವಿಭಿನ್ನ ಸಾಮರ್ಥ್ಯಗಳು ಬೇಕಾಗುತ್ತವೆ. ಆಳವಾದ ಪರಿಶೋಧನೆಗೆ ಶಕ್ತಿಶಾಲಿ ರೀಜನಿಂಗ್ ಮತ್ತು ದೃಢವಾದ ಆಧಾರವುಳ್ಳ ನಿರ್ಣಯಗಳು ಅಗತ್ಯ. ನೂರಾರು ಬಾರಿ ಪುನರಾವರ್ತಿಸುವ ಸಣ್ಣ ಪರೀಕ್ಷೆ ವೇಗವಾಗಿಯೂ ಕಡಿಮೆ ವೆಚ್ಚದಲ್ಲಿಯೂ ನಡೆಯಬೇಕು. ಆಂಪ್ಲಿಟ್ಯೂಡ್ ಪ್ರತಿ ಕೆಲಸದ ಗುಣಮಟ್ಟ, ವಿಳಂಬ ಮತ್ತು ವೆಚ್ಚವನ್ನು ಮೌಲ್ಯಮಾಪನ ಮಾಡಿ, ಅದಕ್ಕೆ ತಕ್ಕಂತೆ ಮಾಡೆಲ್ಗಳನ್ನು ನಿಯೋಜಿಸುತ್ತದೆ.
“OpenAI ನಮಗೆ ಶಕ್ತಿಶಾಲಿ ರೀಜನಿಂಗ್ ಮಾಡೆಲ್ಗಳ ಜೊತೆಗೆ ಚಿಕ್ಕದಾದ, ವೇಗವಾದ ಮಾಡೆಲ್ಗಳನ್ನೂ ಒದಗಿಸಿತು. ಇದರಿಂದ ಉತ್ಪನ್ನದಾದ್ಯಂತ ಗುಣಮಟ್ಟ, ಪ್ರತಿಕ್ರಿಯೆಯ ವಿಳಂಬ ಮತ್ತು ನಿರ್ಣಯ ಪ್ರಕ್ರಿಯೆಯ ವೆಚ್ಚವನ್ನು ಸಮತೋಲನದಲ್ಲಿಡಲು ಸಾಧ್ಯವಾಯಿತು.”
ವೇವ್ನ ಅವಕಾಶ ಪರಿಶೋಧಕಕ್ಕಾಗಿ, ಮಾಡೆಲ್ಗಳು ಕಂಡುಕೊಂಡ ಸಂಗತಿಗಳನ್ನು ಪೂರಕ ಸಾಕ್ಷ್ಯದಿಂದ ದೃಢೀಕರಿಸುತ್ತವೆಯೇ, ತಪ್ಪು ಧನಾತ್ಮಕ ಫಲಿತಾಂಶಗಳನ್ನು ತಪ್ಪಿಸುತ್ತವೆಯೇ, ಮೌಲ್ಯಮಾಪಕರ ಪ್ರತಿಕ್ರಿಯೆಯನ್ನು ಅಳವಡಿಸಿಕೊಳ್ಳುತ್ತವೆಯೇ, ಸಾಧನಗಳ ವೈಫಲ್ಯದಿಂದ ಚೇತರಿಸಿಕೊಳ್ಳುತ್ತವೆಯೇ ಮತ್ತು ಪ್ರತಿಪಾದನೆಗಳನ್ನು ಸಾಕ್ಷ್ಯಕ್ಕೆ ಅನುಗುಣವಾಗಿ ಇಡುತ್ತವೆಯೇ ಎಂಬುದನ್ನು ಆಂಪ್ಲಿಟ್ಯೂಡ್ ಮೌಲ್ಯಮಾಪನ ಮಾಡಿತು. GPT‑6.1 Sol ಒಟ್ಟಾರೆ 5ರಲ್ಲಿ 4.06 ಅಂಕಗಳನ್ನು ಗಳಿಸಿತು. ಹೋಲಿಕೆಯಲ್ಲಿ ಮೂರು ಪರ್ಯಾಯ ಮಾಡೆಲ್ಗಳು ಕ್ರಮವಾಗಿ 3.62, 3.52 ಮತ್ತು 2.94 ಅಂಕಗಳನ್ನು ಗಳಿಸಿದವು. ಅದು ಪರಿಶೋಧನೆಯ ಐದೂ ಮಾನದಂಡಗಳಲ್ಲಿ ಮುಂಚೂಣಿಯಲ್ಲಿತ್ತು. ಪರಿಶೋಧನೆಯ ಮಧ್ಯಕ ಸಮಯವೂ ಅತ್ಯಂತ ಕಡಿಮೆ, ಅಂದರೆ 54 ನಿಮಿಷಗಳಾಗಿತ್ತು.
ವೇವ್ನ ದತ್ತಾಂಶ ವಿಜ್ಞಾನ ಏಜೆಂಟ್ನ ಪ್ರತ್ಯೇಕ ಮೌಲ್ಯಮಾಪನದಲ್ಲಿ, GPT‑6.1 Sol 100ರಲ್ಲಿ 67.5 ಅಂಕಗಳನ್ನು ಗಳಿಸಿದರೆ, ಮತ್ತೊಂದು ಪ್ರಮುಖ ಮಾಡೆಲ್ 69.3 ಅಂಕಗಳನ್ನು ಗಳಿಸಿತು. ಪ್ರತಿ ಕಾರ್ಯ ರವಾನೆಯ ಸರಾಸರಿ ಮಾಡೆಲ್ ವೆಚ್ಚ ಕ್ರಮವಾಗಿ $1.28 ಮತ್ತು $2.63 ಆಗಿತ್ತು. ಸಾಧನ ಬಳಕೆಯ ಒಪ್ಪಂದದ ಪಾಲನೆ, ಅಂದಾಜು ಮತ್ತು ಅನಿಶ್ಚಿತತೆ, ಹಾಗೂ ಸಾಕ್ಷ್ಯಾಧಾರಿತ ಗ್ರೌಂಡಿಂಗ್ನಲ್ಲೂ GPT‑6.1 Sol ಹೆಚ್ಚು ಅಂಕಗಳನ್ನು ಗಳಿಸಿತು.
ಕೋಡ್ ಪರಿಶೀಲಿಸುವುದು ಮತ್ತು ಸಣ್ಣ ಮೌಲ್ಯಮಾಪನ ಪರೀಕ್ಷೆಗಳನ್ನು ನಡೆಸುವುದರಂತಹ ಹೆಚ್ಚಿನ ಪ್ರಮಾಣದ ಕೆಲಸಗಳಲ್ಲಿ ವಿಳಂಬ ಮತ್ತು ವೆಚ್ಚವನ್ನು ಕಡಿಮೆ ಇರಿಸಲು ಆಂಪ್ಲಿಟ್ಯೂಡ್ GPT‑6 Luna ಬಳಸುತ್ತದೆ. ಕೆಲಸವನ್ನು ವಿಶೇಷ ಪರಿಣತಿಯ ಏಜೆಂಟ್ಗಳ ನಡುವೆ ಹಂಚುವುದರಿಂದ, ಹೆಚ್ಚು ವೆಚ್ಚದ ರೀಜನಿಂಗ್ ಅನ್ನು ಅತ್ಯಂತ ಅಗತ್ಯವಿರುವ ಕೆಲಸಗಳಿಗೇ ಮೀಸಲಿಡಲು ತಂಡಕ್ಕೆ ಸಾಧ್ಯವಾಗುತ್ತದೆ.
ರೂಪರೇಖೆಗಳು ಮತ್ತು ಅಣಕು ವಿನ್ಯಾಸಗಳ ರಚನೆಯಲ್ಲಿ, ಪರಿಹಾರದ ರೂಪರೇಖೆಗಳಿಗಾಗಿ OpenAI ಯ ಇಮೇಜ್ ಜನರೇಶನ್ ಮಾಡೆಲ್ 100ರಲ್ಲಿ 80.3 ಅಂಕಗಳನ್ನು ಗಳಿಸಿತು. ಹೋಲಿಕೆಯಲ್ಲಿ ಮತ್ತೊಂದು ಇಮೇಜ್ ಜನರೇಶನ್ ಮಾಡೆಲ್ 63.9 ಅಂಕಗಳನ್ನು ಗಳಿಸಿತು. ಆಂಪ್ಲಿಟ್ಯೂಡ್ನ ಮೌಲ್ಯಮಾಪನವು 15 ಅವಕಾಶಗಳಲ್ಲಿ ಸಂವಹನದ ಗುಣಮಟ್ಟ, ಉತ್ಪನ್ನದ ಮೂಲರೂಪಕ್ಕೆ ನಿಷ್ಠೆ, ಸೂಚನೆಗಳ ಪಾಲನೆ, ಪಠ್ಯ ಮತ್ತು ಬಳಕೆದಾರ ಇಂಟರ್ಫೇಸ್ನ ಓದುವ ಸುಲಭತೆ ಹಾಗೂ ದೃಶ್ಯ ಸುಸಂಗತತೆಯನ್ನು ಪರಿಶೀಲಿಸಿತು.
ವಿವಿಧ ಉದ್ಯಮಗಳ ಗ್ರಾಹಕರು ಉತ್ಪನ್ನ ಸುಧಾರಣೆಗಳನ್ನು ಗುರುತಿಸಿ ಬಿಡುಗಡೆ ಮಾಡಲು ಈಗಾಗಲೇ ವೇವ್ನ ಬೀಟಾ ಆವೃತ್ತಿಯನ್ನು ಬಳಸುತ್ತಿದ್ದಾರೆ. ವೇವ್ ಬಳಕೆಯ ಅವಧಿಗಳ ಮತ್ತು ವಿಶ್ಲೇಷಣೆಯ ದತ್ತಾಂಶವನ್ನು ಪರಿಶೀಲಿಸಿ, ಪ್ರಸ್ತಾವಿತ ಪರಿಹಾರ, ತಾಂತ್ರಿಕ ಯೋಜನೆ ಹಾಗೂ ಸ್ವೀಕೃತಿ ಮಾನದಂಡಗಳೊಂದಿಗೆ ಶಿಫಾರಸುಗಳನ್ನು ರೂಪಿಸುತ್ತದೆ.
ಅಲ್ಲಿಂದ ಮುಂದೆ ಎಷ್ಟು ಸ್ವಯಂಚಾಲಿತವಾಗಿ ನಡೆಯಬೇಕೆಂಬುದನ್ನು ತಂಡಗಳು ನಿಯಂತ್ರಿಸಬಹುದು. ಹೆಚ್ಚಿನ ತಂಡಗಳು ದೋಷ ಸರಿಪಡಿಸುವ ಕೆಲಸಗಳನ್ನು ನೇರವಾಗಿ ಕೋಡಿಂಗ್ ಏಜೆಂಟ್ಗಳಿಗೆ ಕಳುಹಿಸುತ್ತವೆ. ಹೊಸ ವೈಶಿಷ್ಟ್ಯಗಳು ಮತ್ತು ಹೆಚ್ಚು ಮಹತ್ವಾಕಾಂಕ್ಷೆಯ ಉಪಕ್ರಮಗಳು ಮಾತ್ರ ಮಾನವ ಪರಿಶೀಲನೆಗೆ ಒಳಪಡುತ್ತವೆ.
ಬಿಡುಗಡೆ ಹಂತ ತಲುಪುವ ಬದಲಾವಣೆಗಳಿಗೆ, ಅವಕಾಶದ ಪತ್ತೆಯಿಂದ ಅನುಷ್ಠಾನದವರೆಗಿನ ಅವಧಿ ಚಿಕ್ಕದಿರಬಹುದು: ಗ್ರಾಹಕರು ಬಿಡುಗಡೆ ಮಾಡಿದ ಪ್ರಯೋಗಗಳು, ವೈಶಿಷ್ಟ್ಯ ಸಕ್ರಿಯಗೊಳಿಸುವ ಸೂಚಕಗಳು ಮತ್ತು ಮಾರ್ಗದರ್ಶಿಗಳ ಪೈಕಿ, ನಾಲ್ಕರಲ್ಲಿ ಒಂದು ವೇವ್ ಅವಕಾಶವನ್ನು ಗುರುತಿಸಿದ ದಿನವೇ ಜಾರಿಯಾಯಿತು; ಅರ್ಧದಷ್ಟು ನಾಲ್ಕು ದಿನಗಳೊಳಗೆ ಮತ್ತು ಮೂರರಲ್ಲಿ ಎರಡು ಒಂದು ವಾರದೊಳಗೆ ಜಾರಿಯಾದವು.
ಒದಗಿಸಲಾದ ಮೈಲುಗಲ್ಲುಗಳ ನಡುವಿನ ಮೌಲ್ಯಗಳನ್ನು ಅಂದಾಜಿಸಲಾಗಿದೆ; ವಕ್ರರೇಖೆ ವಿವರಣೆಗಾಗಿ ಮಾತ್ರ, ಪ್ರತ್ಯೇಕ ಅವಲೋಕನಗಳನ್ನು ಪ್ರತಿನಿಧಿಸುವುದಿಲ್ಲ.
“ಕಂಪನಿಗಳು ತಾವೇ ಸುಧಾರಿಸಿಕೊಳ್ಳುವ ಉತ್ಪನ್ನಗಳನ್ನು ನಿರ್ಮಿಸುವುದೇ ತಂತ್ರಾಂಶ ಅಭಿವೃದ್ಧಿಯ ವಿಧಾನವಾಗಬೇಕು ಎಂಬುದು OpenAI ಜೊತೆಗಿನ ನಮ್ಮ ಮಹತ್ವಾಕಾಂಕ್ಷೆ,” ಎಂದು ಸ್ಕೇಟ್ಸ್ ಹೇಳುತ್ತಾರೆ. OpenAI ಮಾಡೆಲ್ಗಳು ರೀಜನಿಂಗ್ ಮತ್ತು ಕೋಡಿಂಗ್ನಲ್ಲಿ ಉತ್ತಮಗೊಳ್ಳುತ್ತಾ ಹೋದಂತೆ, ತಂಡಗಳು ಇನ್ನಷ್ಟು ಪರಿಶೋಧನೆ ಮತ್ತು ಅನುಷ್ಠಾನದ ಕೆಲಸವನ್ನು ಏಜೆಂಟ್ಗಳಿಗೆ ವಹಿಸಲು ಸಾಧ್ಯವಾಗುತ್ತದೆ. ಅಂತಿಮವಾಗಿ ಉತ್ತಮ ಉತ್ಪನ್ನಗಳು ಬಳಕೆದಾರರನ್ನು ಇನ್ನಷ್ಟು ಬೇಗ ತಲುಪುತ್ತವೆ. ಆಂಪ್ಲಿಟ್ಯೂಡ್ ಈಗಾಗಲೇ ಇದನ್ನು ಕಾಣುತ್ತಿದೆ. ತಂಡವು ಇತರ ಆದ್ಯತೆಗಳ ಮೇಲೆ ಕೆಲಸ ಮಾಡುತ್ತಿರುವಾಗ, ಏಜೆಂಟ್ಗಳು ಅದರ ಸ್ವಂತ ಉತ್ಪನ್ನದಲ್ಲೇ ಸುಧಾರಣೆಗಳನ್ನು ಗುರುತಿಸಿ ಜಾರಿಗೊಳಿಸಲು ನೆರವಾಗುತ್ತಿವೆ: “ಉತ್ಪನ್ನವನ್ನು ಉತ್ತಮಗೊಳಿಸಲು ತಮ್ಮ ತಂತ್ರಾಂಶವೂ ತಮ್ಮ ಜೊತೆ ಕೆಲಸ ಮಾಡುವಾಗ, ಎಷ್ಟೆಲ್ಲ ಸಾಧಿಸಬಹುದು ಎಂಬುದನ್ನು ಕಂಡು ತಂಡಗಳು ಆಶ್ಚರ್ಯಪಡುತ್ತವೆ ಎಂದು ನನಗನಿಸುತ್ತದೆ.”