OpenAI o1 жарыстық бағдарламалау сұрақтарында (Codeforces) 89-процентильге енеді, АҚШ-тағы Математика олимпиадасына (AIME) іріктеу емтиханында АҚШ бойынша үздік 500 оқушының қатарына кіреді және физика, биология және химия есептеріне арналған бенчмаркте (GPQA) PhD деңгейіндегі адамның дәлдігінен асады. Бұл жаңа модельді қазіргі модельдер сияқты қолдануға жеңіл ету үшін қажет жұмыс әлі жалғасып жатқанына қарамастан, біз бұл модельдің ерте нұсқасы — OpenAI o1‑preview‑ді ChatGPT ішінде дереу пайдалану үшін және сенімді API пайдаланушыларына(жаңа терезеде ашылады) ұсынып отырмыз.
Біздің ауқымды күшейтпелі оқыту алгоритмі модельге өз ой тізбегін пайдаланып өнімді ойлауды, дерек жағынан өте тиімді жаттықтыру үдерісі арқылы үйретеді. Біз o1 өнімділігі көбірек күшейтпелі оқыту арқылы (жаттықтыру кезіндегі есептеу) және ойлануға көбірек уақыт бөлу арқылы (тест кезіндегі есептеу) тұрақты түрде жақсаратынын анықтадық. Бұл тәсілді ауқымдаудың шектеулері LLM-ді алдын ала жаттықтыру шектеулерінен едәуір өзгеше, және біз оларды зерттеуді жалғастырып жатырмыз.
o1 performance smoothly improves with both train-time and test-time compute
GPT‑4o‑мен салыстырғанда ой қорыту сапасының жақсарғанын көрсету үшін, біз модельдерімізді адамға арналған түрлі емтихандар мен ML бенчмарктерінің әртүрлі жиынтығында сынадық. Біз o1‑дің ой қорытуға көбірек сүйенетін осы тапсырмалардың басым көпшілігінде GPT‑4o‑дан айтарлықтай озып түсетінін көрсеттік. Басқаша көрсетілмесе, o1‑ді тест кезіндегі есептеудің ең жоғарғы параметрінде бағаладық.
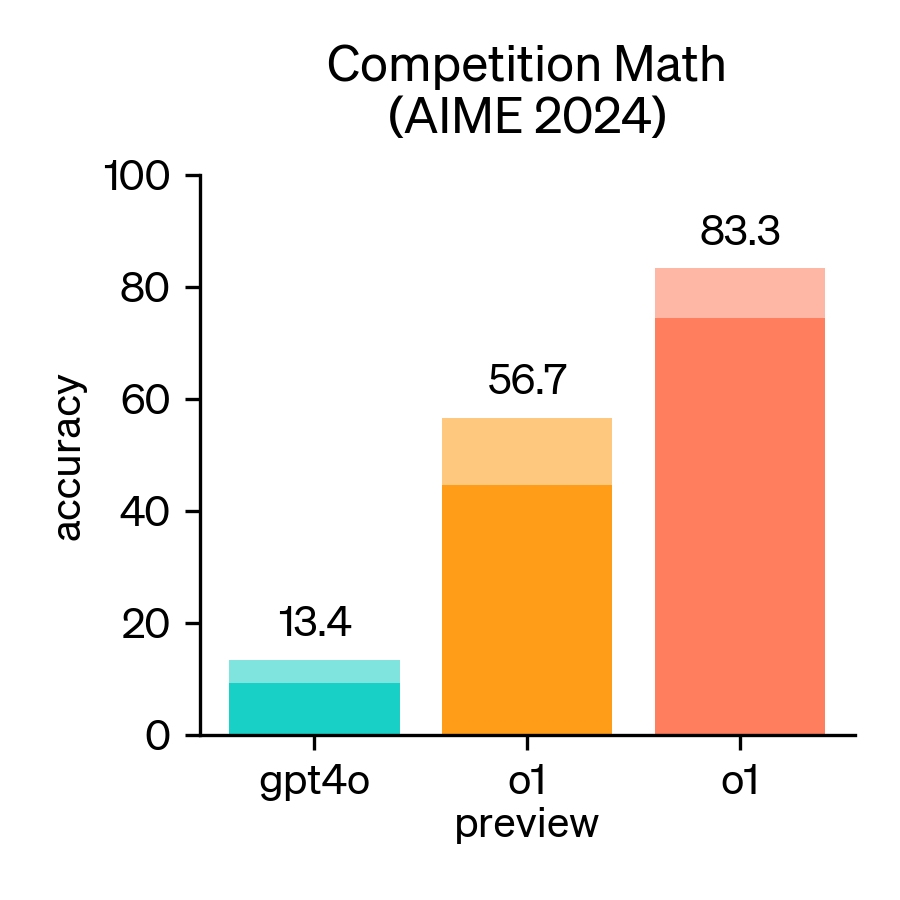
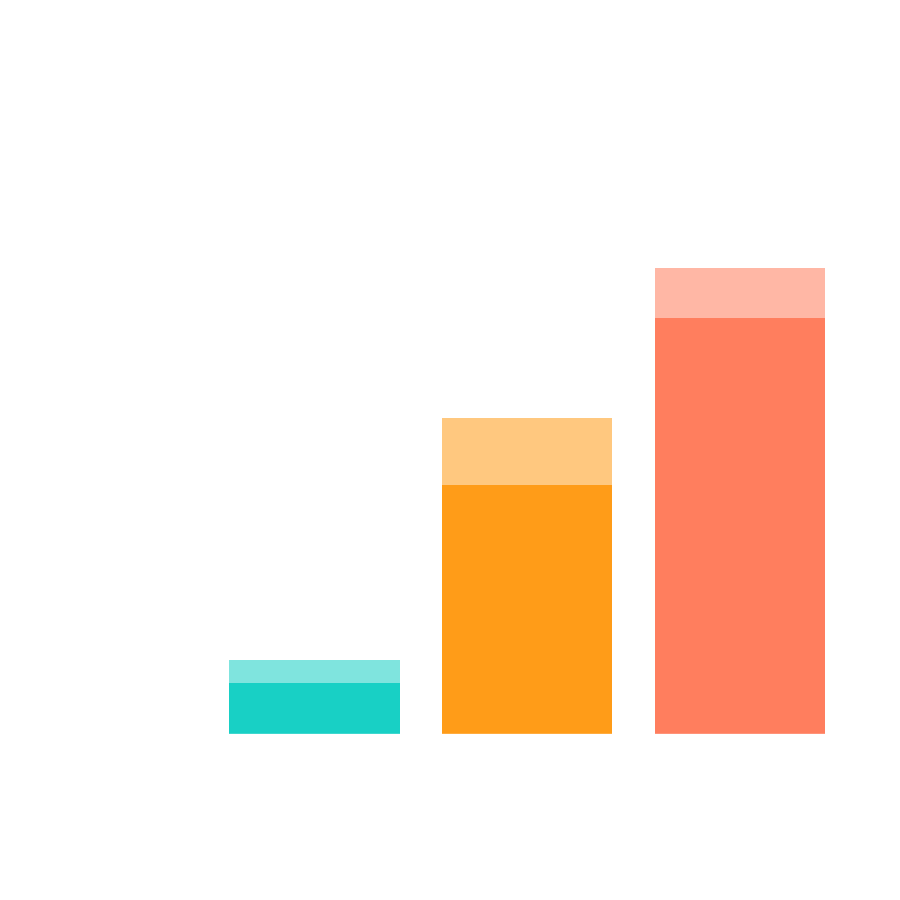
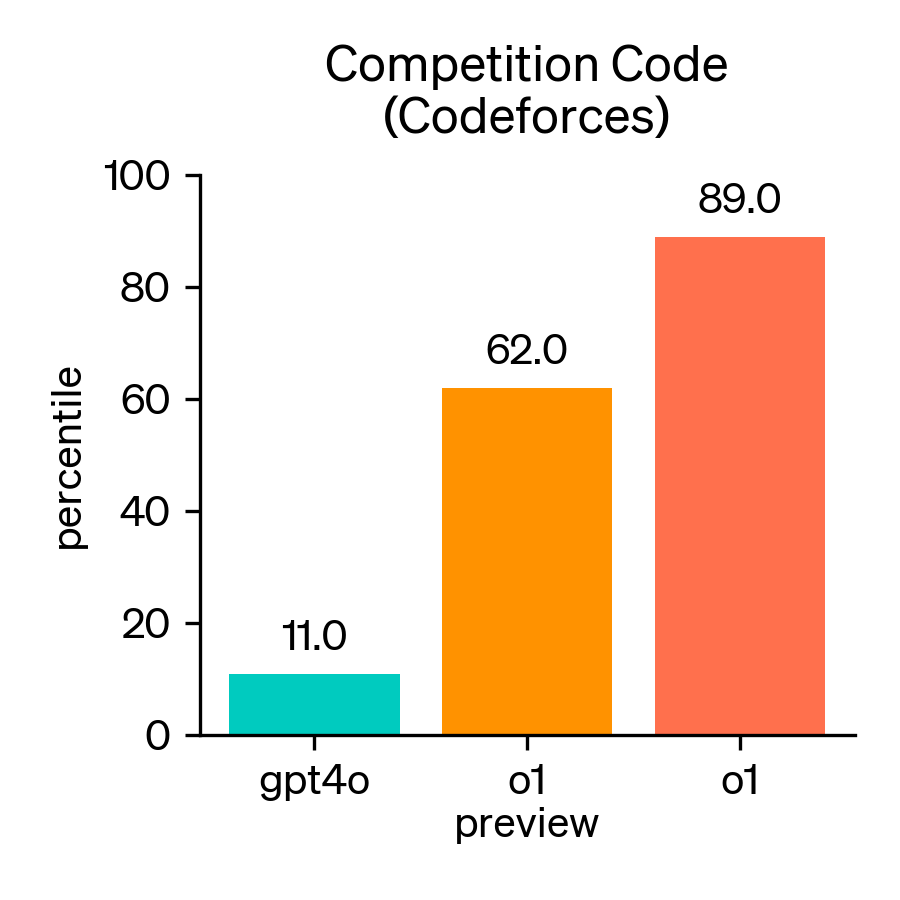
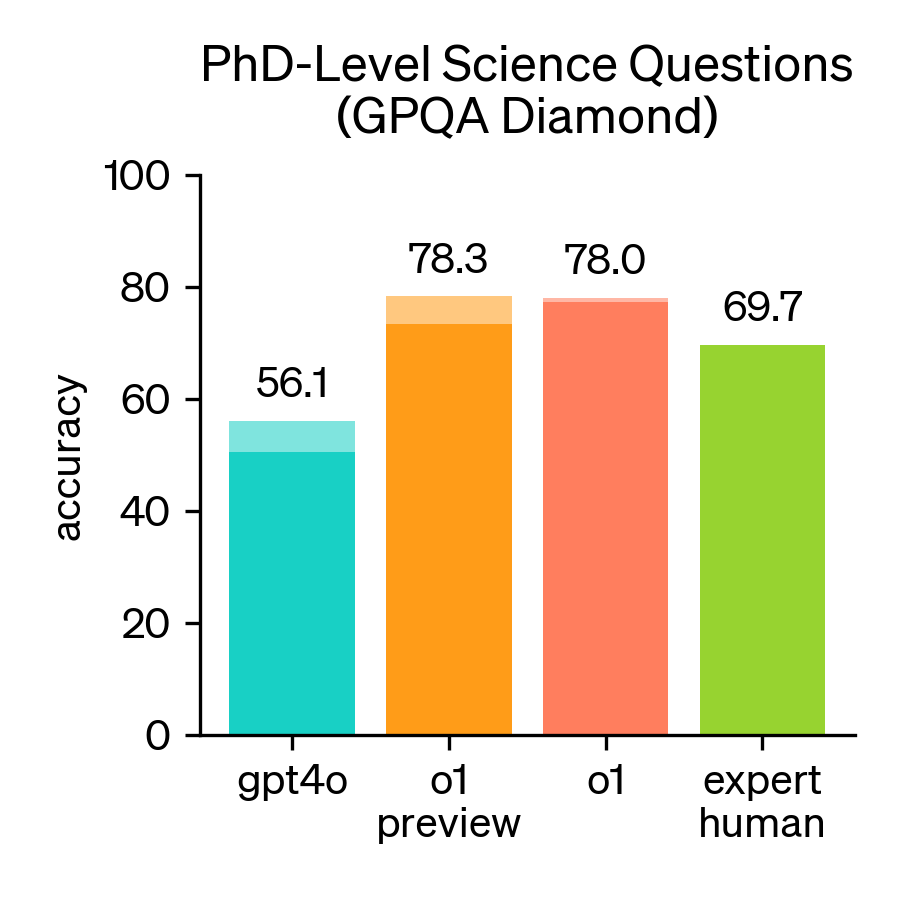
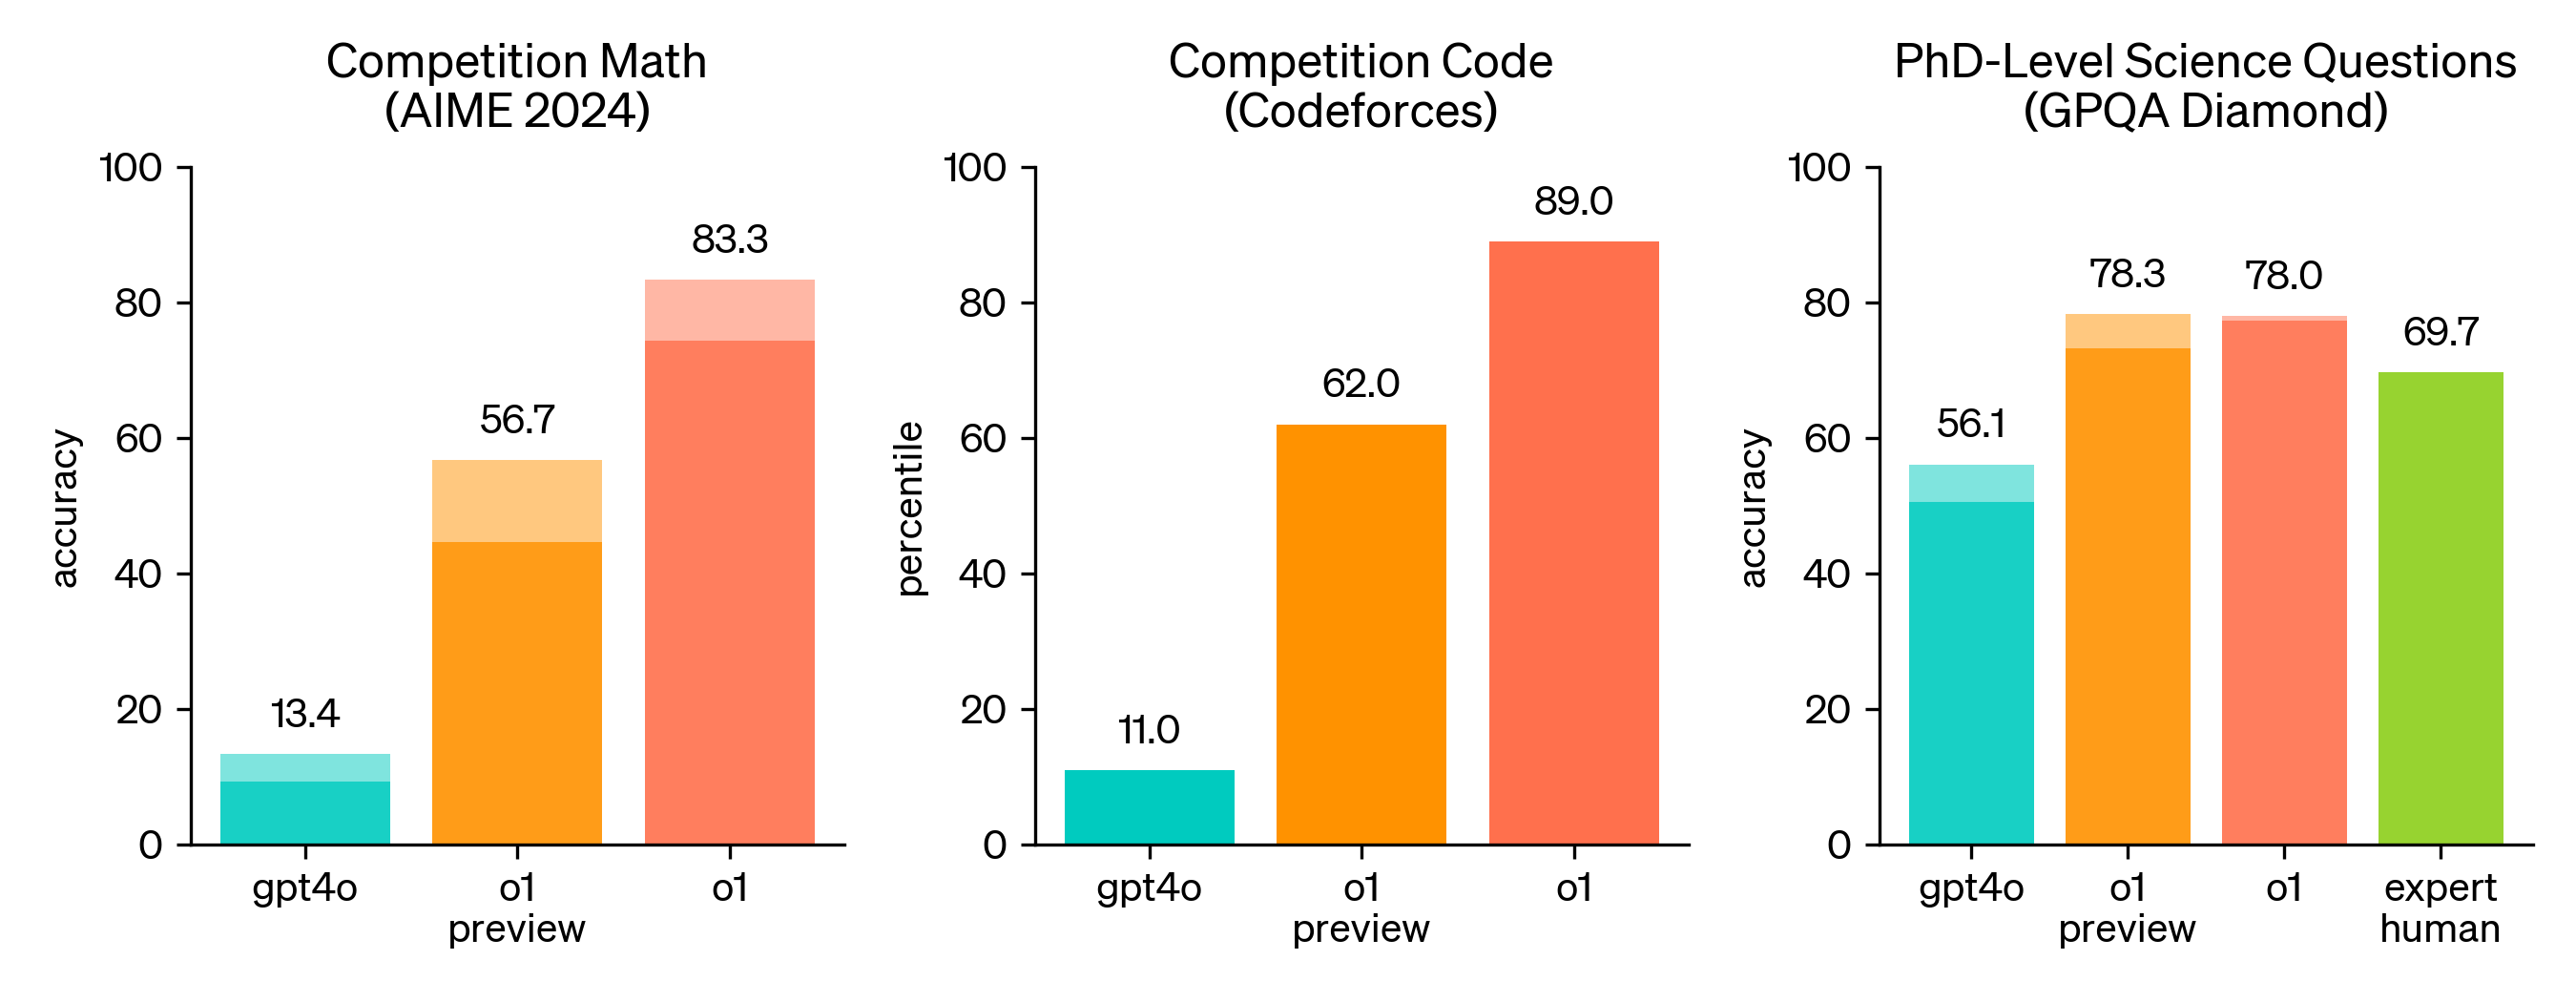
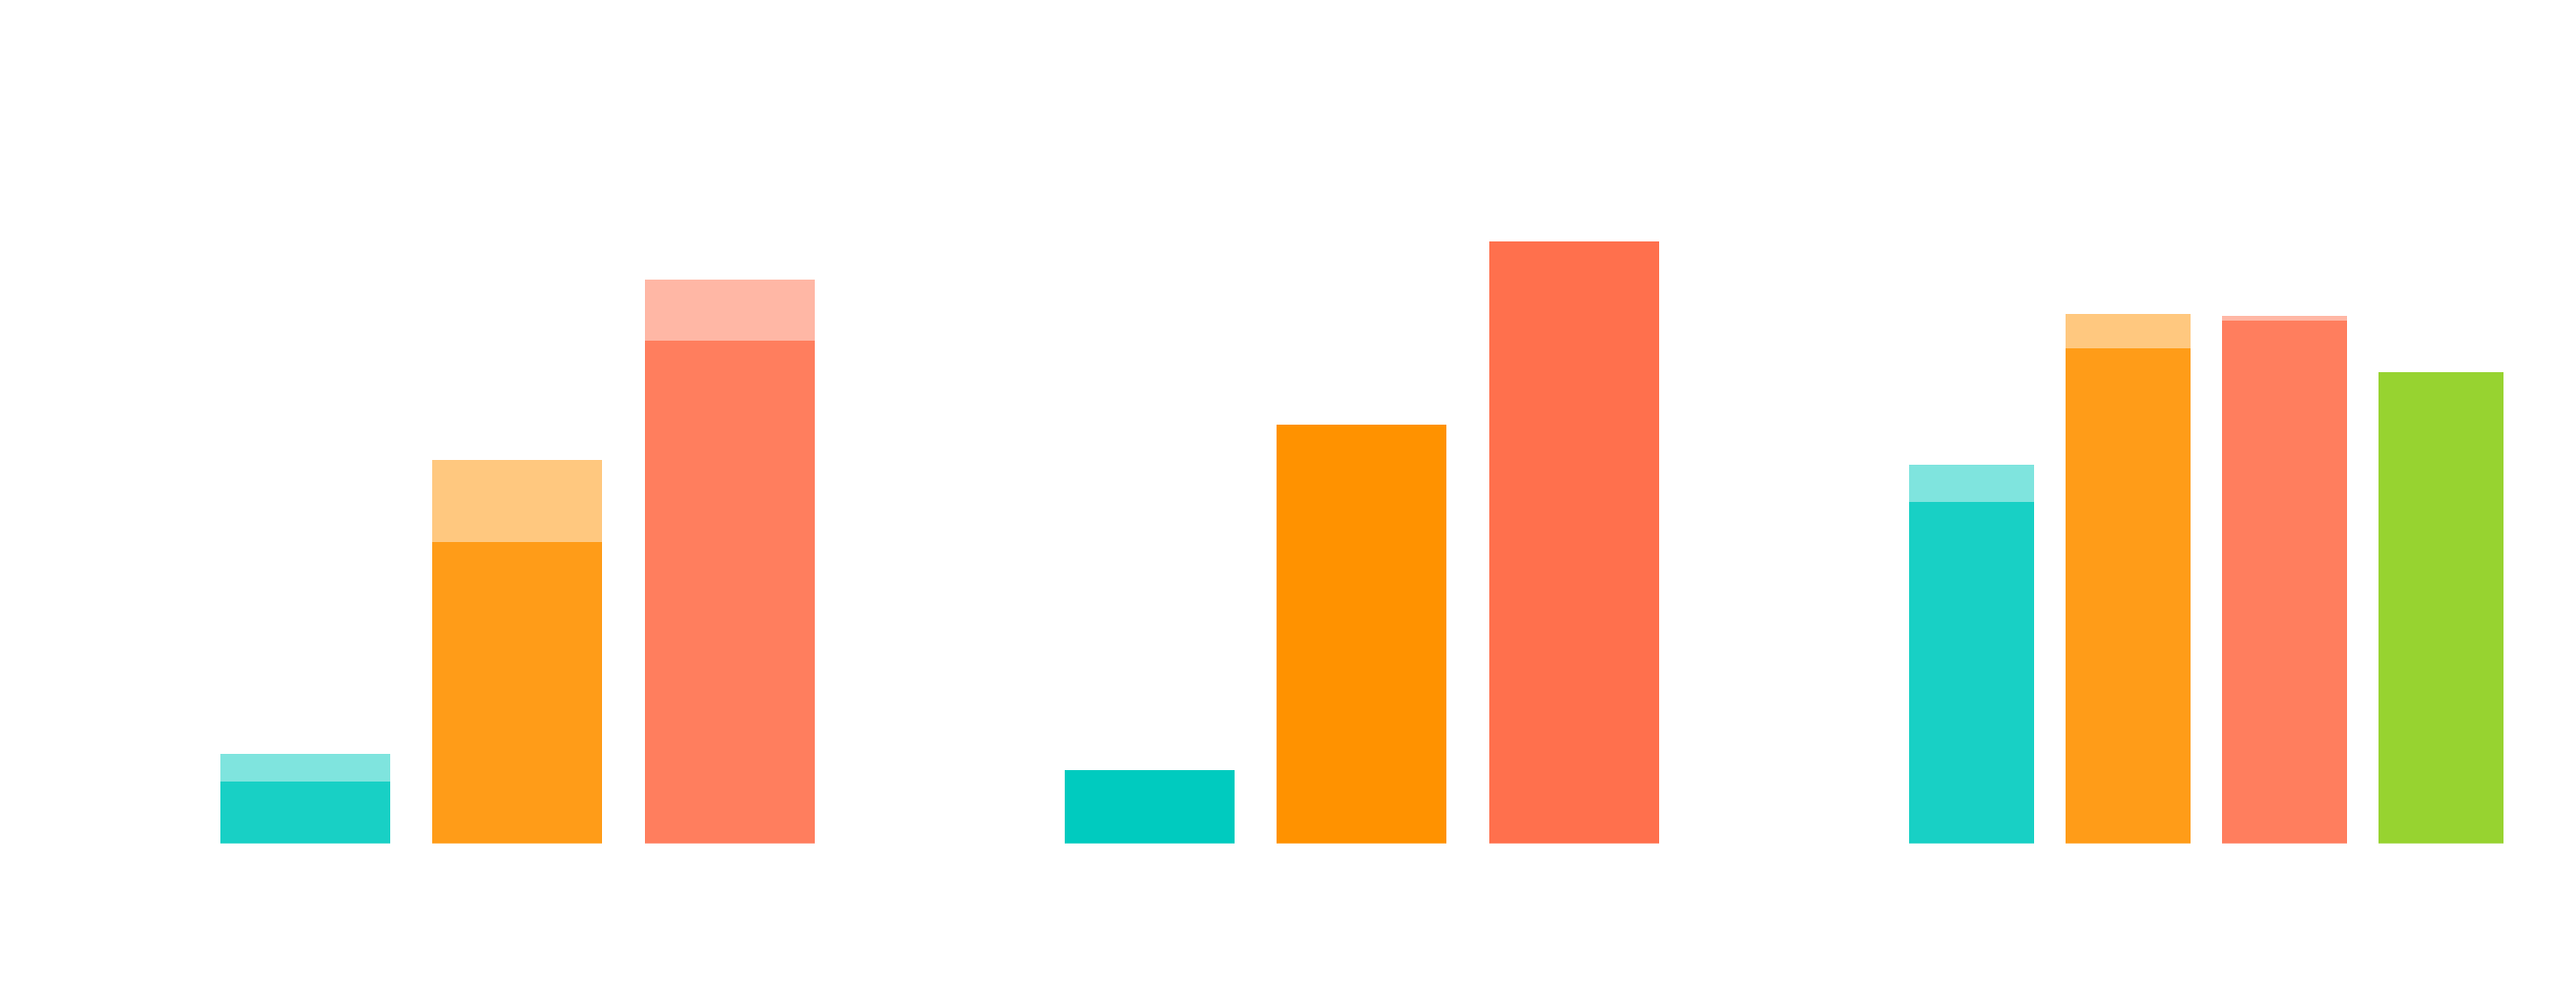
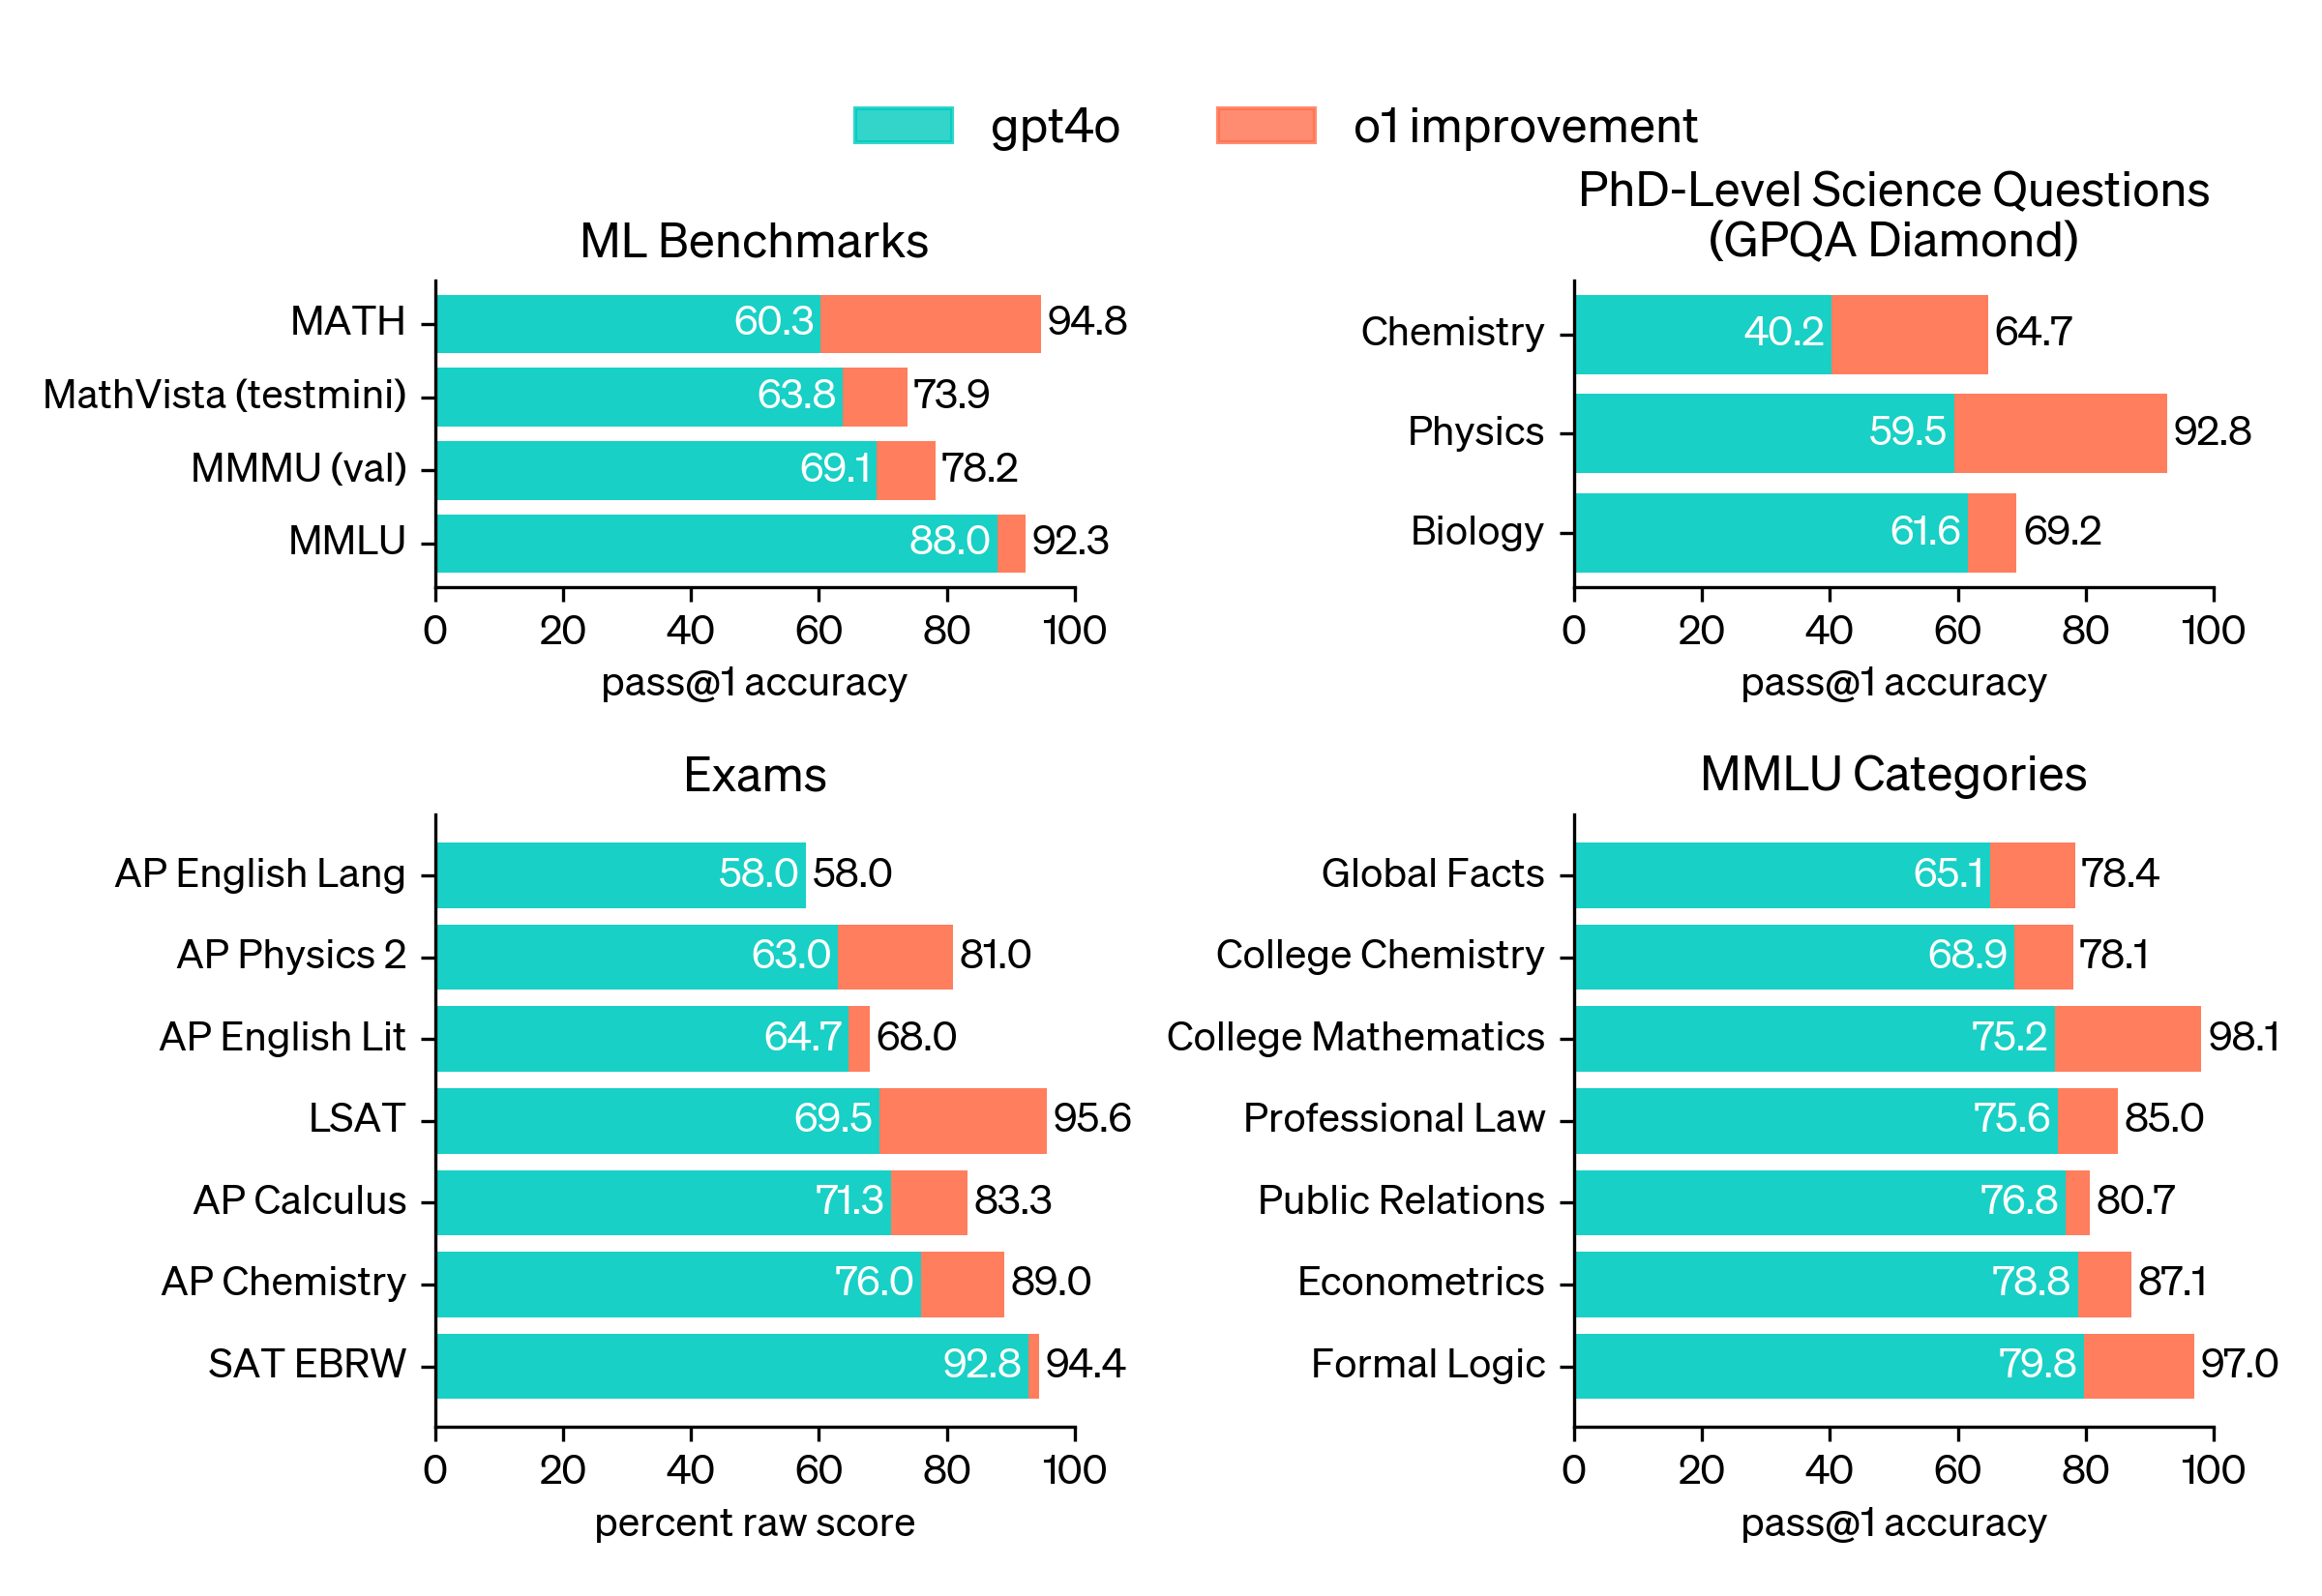
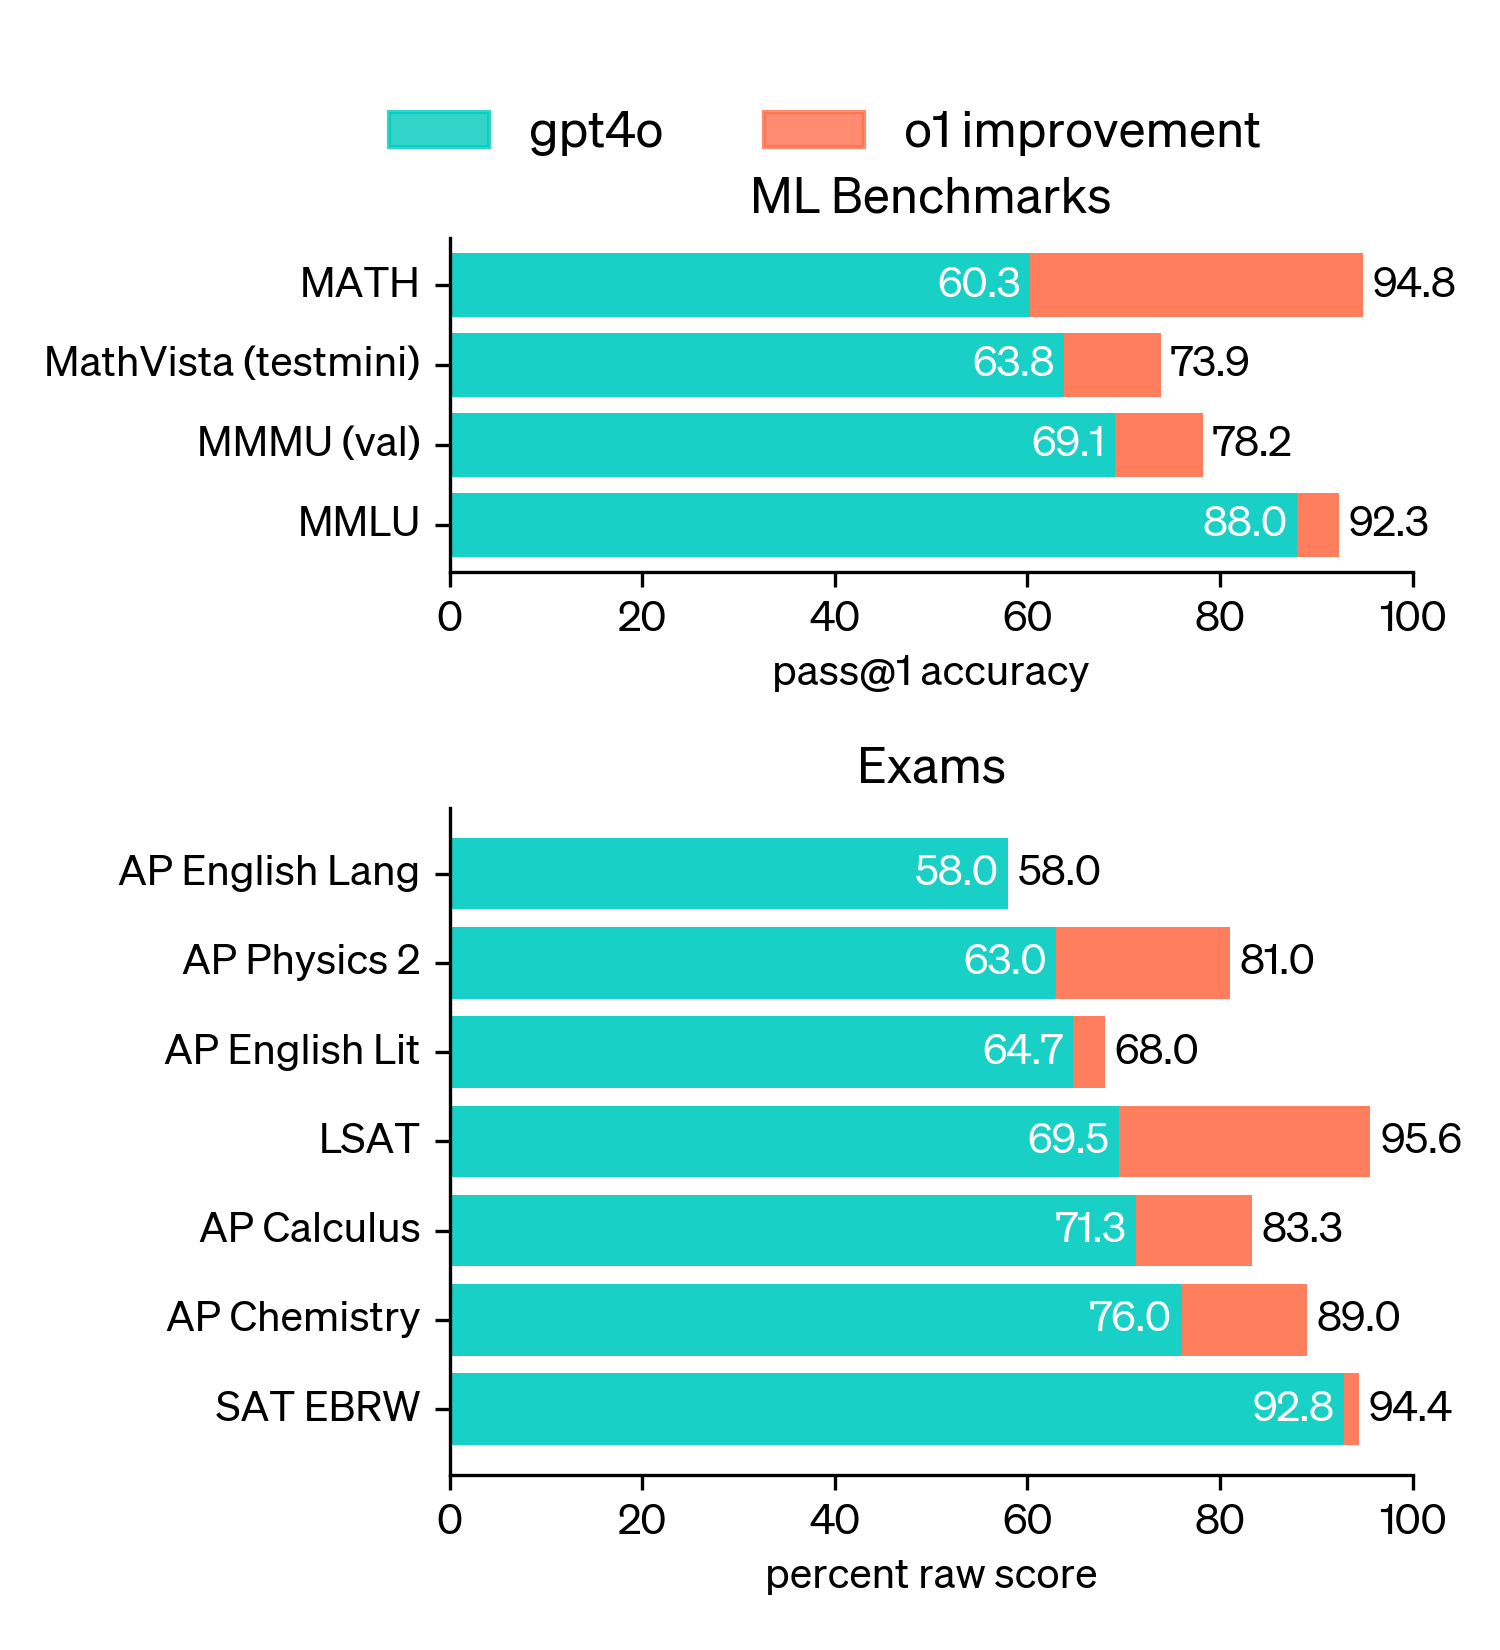
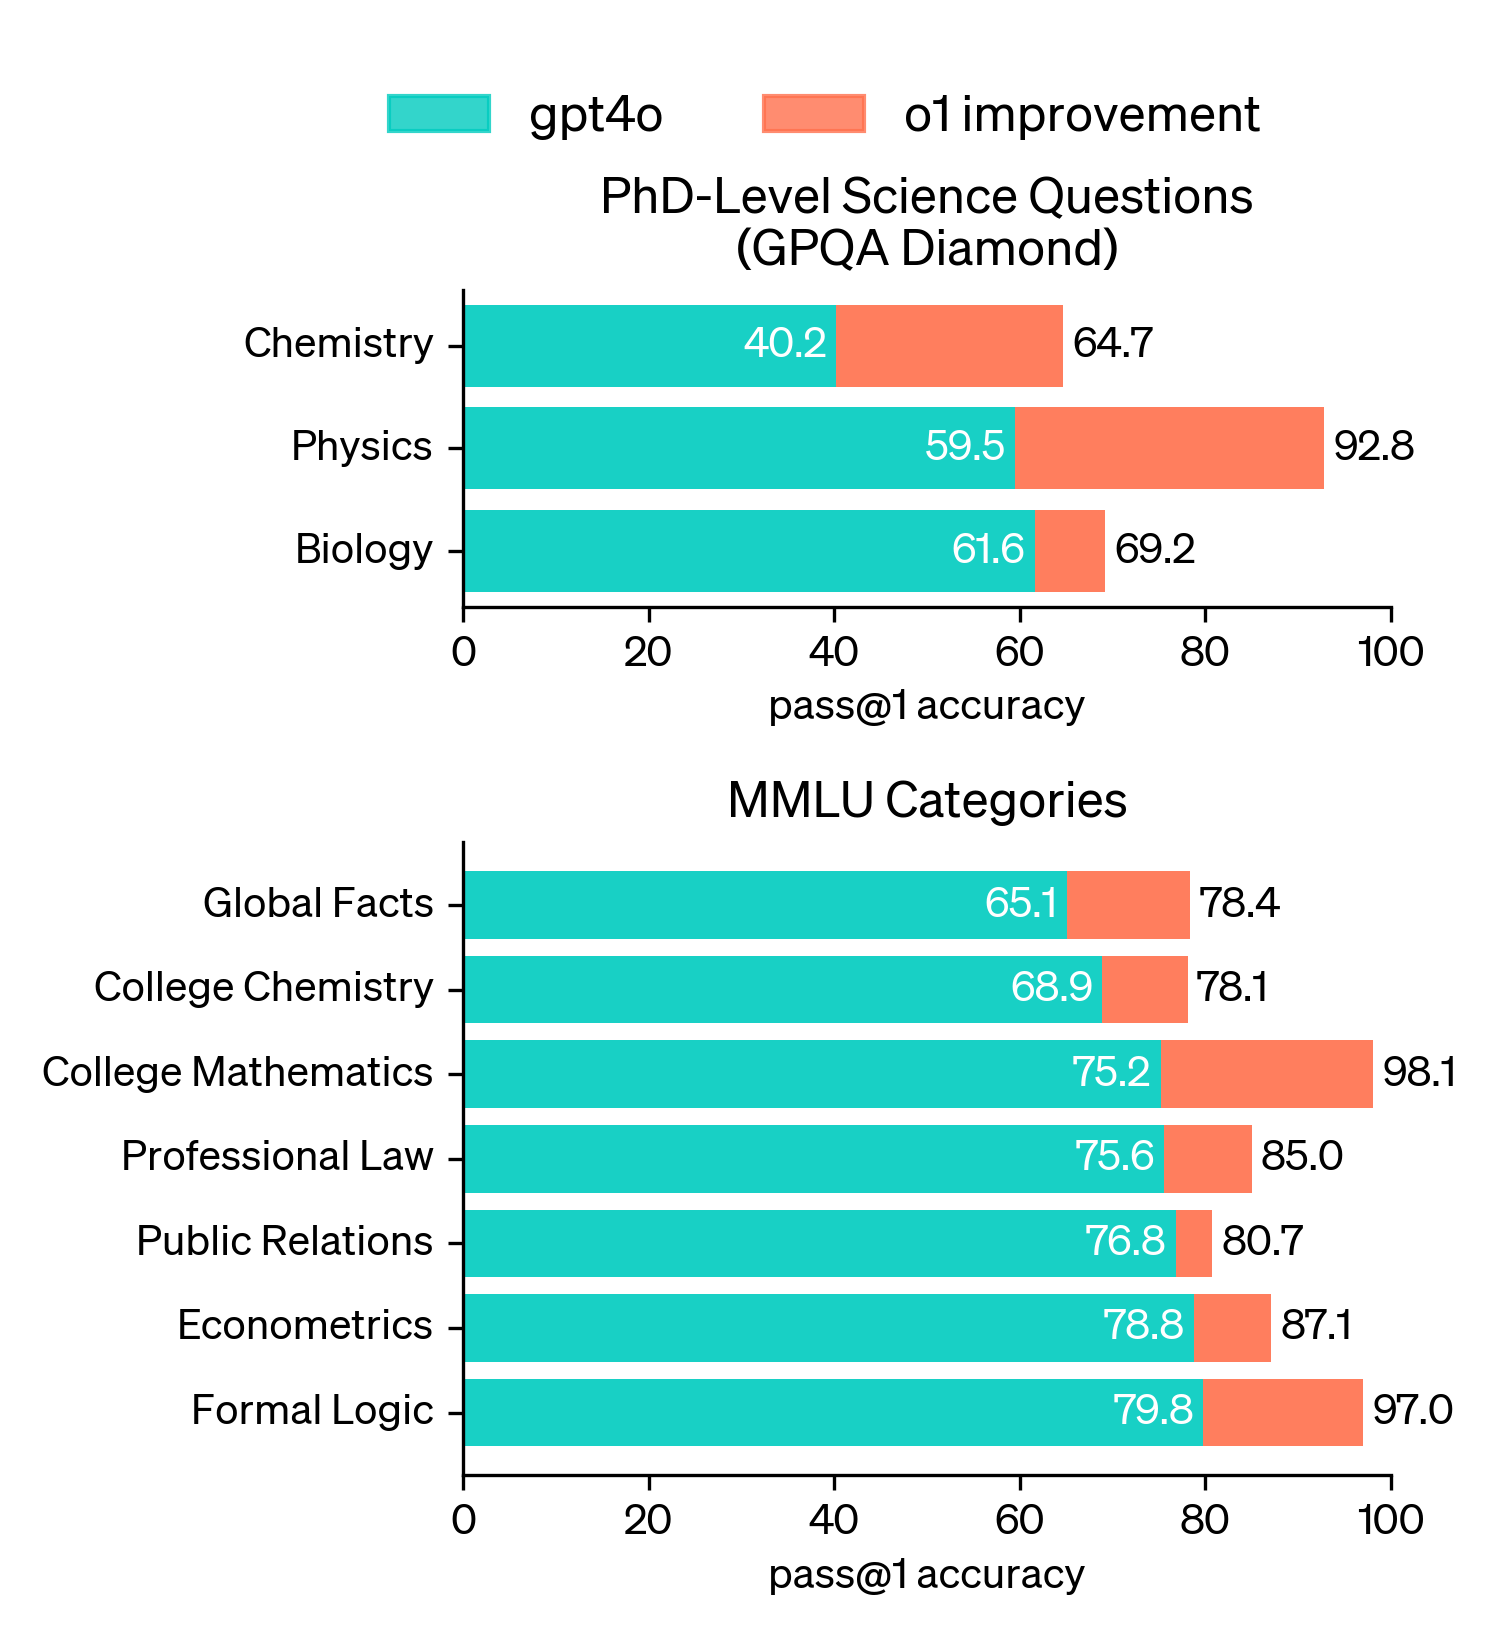
Ой қорытуға көбірек сүйенетін көптеген бенчмарктерде o1 адам сарапшыларының нәтижесімен тайталасады. Соңғы озық модельдер1 MATH2 және GSM8K бойынша соншалықты жақсы нәтиже көрсетеді, бұл бенчмарктер енді модельдерді ажыратуда тиімді емес. Біз математикалық өнімділікті Америкадағы ең мықты мектеп оқушыларына қиындық тудыру үшін жасалған AIME емтиханында бағаладық. 2024 жылғы AIME емтихандарында GPT‑4o есептердің орта есеппен тек 12%-ын (1.8/15) ғана шешті. Ал o1 әр есепке бір үлгімен орташа 74% (11.1/15), 64 үлгі арасындағы консенсуспен 83% (12.5/15) және үйретілген бағалау функциясымен 1000 үлгіні қайта ранжирлеу кезінде 93% (13.9/15) нәтижеге жетті. 13.9 балл оны ел бойынша үздік 500 оқушының қатарына енгізіп, USA Mathematical Olympiad өту шегінен жоғары қояды.
Біз сондай-ақ o1‑ді GPQA diamond бойынша бағаладық — бұл химия, физика және биология салаларындағы сараптаманы тексеретін күрделі интеллект бенчмаркі. Модельдерді адамдармен салыстыру үшін біз GPQA-diamond сұрақтарына жауап беру мақсатында PhD дәрежесі бар сарапшыларды тарттық. Нәтижесінде o1 сол адам сарапшылардың нәтижесінен асып түсті және бұл бенчмаркте мұны жасаған алғашқы модель болды. Бұл нәтижелер o1 барлық қырынан PhD-ден қабілетті дегенді білдірмейді — тек модель PhD шеше алады деп күтілетін кейбір есептерді шешуде анағұрлым біліктірек екенін көрсетеді. Тағы бірнеше ML бенчмарктерінде o1 ең үздік нәтижеден де асып түсті. Көру арқылы қабылдау мүмкіндіктері қосылғанда, o1 MMMU бойынша 78.2% жинап, адам сарапшыларымен бәсекелесе алған алғашқы модель болды. Сондай-ақ ол MMLU-дың 57 ішкі санатының 54-інде GPT‑4o‑дан озып түсті.
Адам қиын сұраққа жауап бермес бұрын ұзақ ойлануы мүмкін болғаны сияқты, o1 де мәселені шешуге тырысқанда ой тізбегін қолданады. Күшейтпелі оқыту арқылы o1 өз ой тізбегін ұштап, қолданатын стратегияларын жетілдіруді үйренеді. Ол қателерін тануды және түзетуді үйренеді. Ол күрделі қадамдарды қарапайымырақ бөліктерге бөлуді үйренеді. Қазіргі тәсіл жұмыс істемегенде, басқа жолды байқап көруді үйренеді. Бұл үдеріс модельдің ой қорыту қабілетін күрт жақсартады. Осы үлкен ілгерілеуді көрсету үшін төменде o1‑preview‑дің бірнеше қиын есептегі ой тізбегін ұсынамыз.
Бағдарламалау дағдыларын одан әрі жетілдіру үшін o1 негізінде бастапқы күйге келтіріп, қосымша жаттықтыру арқылы біз 2024 жылғы Халықаралық информатика олимпиадасында (IOI) 213 ұпай жинап, 49-процентильге енген модельді дайындадық. Бұл модель 2024 жылғы IOI жарысына адам қатысушылармен бірдей шарттарда қатысты. Оған алты күрделі алгоритмдік есепті шешуге он сағат берілді және әр есепке 50 жіберілім жасауға рұқсат етілді.
Әр есеп үшін біздің жүйе көптеген ықтимал жіберілімдерді іріктеп, тест кезіндегі таңдау стратегиясына сүйене отырып, олардың 50-сін жіберді. Жіберілімдер IOI-дың ашық тест жағдайларындағы нәтижеге, модель жасаған тест жағдайларына және үйретілген бағалау функциясына қарай таңдалды. Егер оның орнына біз кездейсоқ жібергенде, орта есеппен небәрі 156 ұпай ғана алар едік, бұл осы стратегияның жарыс шектеулері жағдайында шамамен 60 ұпайға татитынын көрсетеді.
Жіберілім шектеуі жеңілдетілгенде, модель өнімділігі айтарлықтай жақсарғанын байқадық. Әр есепке 10 000 жіберілім жасауға рұқсат етілгенде, модель ешқандай тест кезіндегі таңдау стратегиясынсыз-ақ 362.14 ұпайға жетті — бұл алтын медаль шегінен жоғары.
Соңында, осы модельдің код жазу шеберлігін көрсету үшін Codeforces өткізетін жарыстық бағдарламалау турнирлерін симуляцияладық. Біздің бағалаулар жарыс ережелеріне барынша жақын болды және 10 жіберілімге мүмкіндік берді. GPT‑4o 808 Elo3 рейтингіне жетті, бұл адам қатысушылардың 11-процентиліне сәйкес келеді. Бұл модель GPT‑4o мен o1‑ден әлдеқайда озық болды — ол 1807 Elo рейтингіне жетіп, қатысушылардың 93%-ынан жақсы нәтиже көрсетті.

Further fine-tuning on programming competitions improves o1. The improved model ranked in the 49th percentile in the 2024 International Olympiad in Informatics under competition rules.
Емтихандар мен академиялық бенчмарктерден бөлек, біз сондай-ақ әртүрлі салалардағы күрделі, ашық форматтағы көмексөздерде o1‑preview пен GPT‑4o‑ға қатысты адамның қалауын бағаладық. Бұл бағалауда адам жаттықтырушыларына o1‑preview мен GPT‑4o берген анонимдендірілген жауаптар көрсетіліп, қай жауапты қалайтыны бойынша дауыс берілді. Деректер талдауы, код жазу және математика сияқты ой қорытуға көбірек сүйенетін санаттарда o1‑preview gpt-4o-дан едәуір артық таңдалды. Алайда кейбір табиғи тіл тапсырмаларында o1‑preview артық таңдалмайды, бұл оның барлық қолдану жағдайына бірдей сай келмейтінін көрсетеді.

Ой тізбегі арқылы ой қорыту туралау мен қауіпсіздік үшін жаңа мүмкіндіктер береді. Біз модельдің мінез-құлқына қатысты саясаттарымызды ойлайтын модельдің ой тізбегіне кіріктіру адам құндылықтары мен қағидаларын сенімді түрде үйретудің тиімді жолы екенін анықтадық. Модельге қауіпсіздік ережелерімізді және олар туралы контексте қалай ой қорыту керегін үйрету арқылы, ой қорыту қабілетінің модельдің орнықтылығына тікелей пайда әкелетініне дәлел таптық: o1‑preview jailbreak-ті бағалаудағы негізгі тексерулерде және модельдің қауіпсіз бас тарту шекараларын бағалайтын ең күрделі ішкі бенчмарктерімізде айтарлықтай жақсы нәтиже көрсетті. Біз ой тізбегін қолдану қауіпсіздік пен туралау үшін елеулі ілгерілеу береді деп санаймыз, өйткені (1) ол модельдің қалай ойлайтынын түсінікті түрде бақылауға мүмкіндік береді, және (2) модельдің қауіпсіздік ережелері туралы ой қорытуы таралымнан тыс сценарийлерге берігірек болады.
Жақсартуларымызды стресс-тексеру үшін біз енгізу алдында Дайындық шеңберіне(жаңа терезеде ашылады) сәйкес қауіпсіздік сынақтары мен red-teaming жиынтығын өткіздік. Біз ой тізбегі арқылы ой қорыту бағалауларымыздың барлығында да қабілеттің жақсаруына ықпал еткенін анықтадық. Ерекше атап өтетіні, біз сыйақыны айламен пайдаланудың қызықты жағдайларын(жаңа терезеде ашылады) байқадық. Осы бағалаулардың егжей-тегжейлі нәтижелерін қоса берілген жүйе картасынан табуға болады.
| Метрика | GPT-4o | o1-preview |
|---|---|---|
| % Зиянды көмексөздерге қауіпсіз жауаптар стандартты | 0,990 | 0,995 |
| % Зиянды көмексөздер бойынша қауіпсіз толықтырулар Күрделі: джейлбрейктер мен шеткі жағдайлар | 0,714 | 0,934 |
| ↳ Қорлау (ауыр) | 0,845 | 0,900 |
| ↳ Қанаушылық сипаттағы жыныстық мазмұн | 0,483 | 0,949 |
| ↳ Кәмелетке толмағандардың қатысуымен жыныстық контент | 0,707 | 0,931 |
| ↳ Зорлық-зомбылықсыз құқық бұзушылық туралы кеңес | 0,688 | 0,961 |
| ↳ Зорлық-зомбылыққа қатысты құқықбұзушылық туралы кеңес | 0,778 | 0,963 |
| % WildChat-та санат бойынша модерация API ұпайлары ең жоғары топ 200 үшін қауіпсіз толықтырулар Zhao, et al. 2024 | 0,945 | 0,971 |
| Жақсылық@0.1 StrongREJECT джейлбрейк бағалау Souly et al. 2024 | 0,220 | 0,840 |
| Адамдардан алынған джейлбрейк бағасы | 0,770 | 0,960 |
| % Ішкі зиянсыз шеткі жағдайлар бойынша сәйкестік «шамадан тыс бас тарту емес» | 0,910 | 0,930 |
| % XSTest жүйесіндегі зиянсыз шеткі жағдайлар бойынша сәйкестік«шамадан тыс бас тартпау» Röttger, et al. 2023 | 0,924 | 0,976 |
Біз жасырын ой тізбегі модельдерді бақылауға бірегей мүмкіндік береді деп санаймыз. Егер ол шынайы әрі түсінікті болса, жасырын ой тізбегі бізге модельдің "ойын оқуға" мүмкіндік береді және оның ойлау үдерісін түсінуге көмектеседі. Мысалы, болашақта біз ой тізбегін пайдаланушыны манипуляциялау белгілеріне қарап бақылағымыз келуі мүмкін. Алайда мұның жұмыс істеуі үшін модельдің өз ойын өзгеріссіз түрде еркін жеткізе алуы қажет, сондықтан біз ой тізбегіне саясатқа сәйкестікті де, пайдаланушы қалауларын да үйрете алмаймыз. Сондай-ақ тураланбаған ой тізбегін пайдаланушыларға тікелей көрсеткіміз келмейді.
Сондықтан пайдаланушы тәжірибесі, бәсекелестік артықшылық және ой тізбегін бақылауды дамыту мүмкіндігі сияқты бірнеше факторды таразылай келе, біз пайдаланушыларға шикі ой тізбектерін көрсетпеу туралы шешім қабылдадық. Бұл шешімнің кемшіліктері бар екенін мойындаймыз. Оның орнын ішінара толтыру үшін біз модельге ой тізбегіндегі кез келген пайдалы идеяны жауапта қайта беруді үйретуге тырысамыз. o1 модельдер сериясы үшін біз ой тізбегінің модель жасаған қысқаша мазмұнын көрсетеміз.
o1 AI-дағы ой қорыту бойынша ең үздік нәтижені айтарлықтай алға жылжытады. Біз бұл модельді жетілдіруді жалғастыра отырып, оның жақсартылған нұсқаларын шығаруды жоспарлап отырмыз. Бұл жаңа ой қорыту мүмкіндіктері модельдерді адам құндылықтары мен қағидаларына туралау қабілетімізді жақсартады деп күтеміз. o1 — және оның мұрагерлері — ғылымда, код жазуда, математикада және соған жақын салаларда AI үшін көптеген жаңа қолдану жағдайларын ашады деп сенеміз. Пайдаланушылар мен API әзірлеушілері оның күнделікті жұмысын қалай жақсарта алатынын ашатынына қуаныштымыз.
| Деректер жиынтығы | Метрика | gpt-4o | o1-preview | o1 |
|---|---|---|---|---|
| Олимпиадалық математика AIME (2024) | cons@64 | 13,4 | 56,7 | 83,3 |
| pass@1 | 9,3 | 44,6 | 74,4 | |
| Байқау коды CodeForces | Эло | 808 | 1 258 | 1 673 |
| Пайыздық көрсеткіш | 11,0 | 62,0 | 89,0 | |
| GPQA Diamond | cons@64 | 56,1 | 78,3 | 78,0 |
| pass@1 | 50,6 | 73,3 | 77,3 | |
| Биология | cons@64 | 63,2 | 73,7 | 68,4 |
| pass@1 | 61,6 | 65,9 | 69,2 | |
| Химия | cons@64 | 43,0 | 60,2 | 65,6 |
| pass@1 | 40,2 | 59,9 | 64,7 | |
| Физика | cons@64 | 68,6 | 89,5 | 94,2 |
| pass@1 | 59,5 | 89,4 | 92,8 | |
| Математика | pass@1 | 60,3 | 85,5 | 94,8 |
| MMLU | pass@1 | 88,0 | 92,3 | 90,8 |
| MMMU (val) | pass@1 | 69,1 | n/a | 78,2 |
| MathVista (testmini) | pass@1 | 63,8 | n/a | 73,9 |
Авторлар
Дәйексөздер
- 1
- 2
Біздің бағалаулар https://arxiv.org/abs/2305.20050(жаңа терезеде ашылады) еңбегінде қолданылған дәл сол 500 есептік тест бөлінісін пайдаланды
- 3