Közös útmutató a megbízható harmadik feles értékelésekhez
Mi számít a védelmi intézkedések és képességek hatékony, független értékelésében a frontier modellek esetében.
A független, megbízható harmadik fél által végzett értékelések kritikus szerepet játszanak a biztonsági ökoszisztéma megerősítésében. Ezeket az értékeléseket frontier modelleken végzik, hogy további bizonyítékot szolgáltassanak a kritikus képességekre és biztonsági kockázatcsökkentésekre vonatkozó állításokhoz. Ebben a bejegyzésben megosztjuk az eddig levont tanulságainkat, és olyan megközelítéseket ajánlunk az értékelések megtervezéséhez, amelyek érvényesen tudják felmérni a frontier modelleket, és reményeink szerint segítenek alakítani a területen kialakuló szabványokat.
Korábban sok értékelés úgy kezelte a modelleket, mint a chatbotokat: az értékelés úgy adott utasítást a modellnek, mintha egy kérdést feltevő felhasználó lenne, a modell válaszolt, majd egy értékelő megítélte a kimenetet. A mai frontier modellek ennél sokkal többre képesek: használhatnak eszközöket, sok lépésen át nyomon követhetik az információkat, és egy nagyobb munkafolyamaton belül cselekedhetnek. Ez azt jelenti, hogy a teljesítmény nemcsak a modelltől függ, hanem attól a környezettől is, amelyben a feladat zajlik, valamint attól a beállítástól, amely megkönnyíti a cselekvéseit. Ez a környező beállítás, amelyet mi „harness”-nek nevezünk, megváltoztathatja a rendszer teljesítményének kulcsfontosságú aspektusait, beleértve azt is, hogyan használ eszközöket, hogyan követi nyomon az információkat, vagy hogyan áll helyre hibákból.

Ez megváltoztatja, hogyan kell az értékeléseket lefolytatni, és mire kell az olvasóknak figyelniük az értékelési jelentésekben. Véleményünk szerint a leghasznosabb jelentések magán az eredményen túl két dolgot írnak le kifejezetten: először is meghatározzák, milyen állítás tesztelésére tervezték az értékelési beállítást, másodszor pedig megosztják a rendelkezésre álló bizonyítékokat arra, hogy az értékelési eredmény érvényes.
Az értékelésekben tesztelt állítások jellemzően három kategória egyikébe esnek1:
Képesség előhívása: Valószínűsíthetően képes-e egy modell előállítani az értékelt képességet?
A védelmi intézkedések teljesítménye: Mennyire robusztusak a tesztelt védelmi intézkedések az értékelt viselkedéssel vagy támadással szemben?
Összehasonlítás: Hogyan teljesítenek a különböző modellek egyenértékű feltételek mellett?
Az értékelési jelentéseknek azt is meg kell magyarázniuk, hogyan ellenőrizték az értékelők azokat a hatásokat, amelyek befolyásolhatják egy eredmény érvényességét. Ezek közé tartoznak:
Jutalomhekkelés: A feladatban vagy a pontozóban lévő kerülőutak kihasználása, így a rendszer úgy kap elismerést, hogy nem mutatja meg azt a viselkedést, amelyet az értékelés mérni kíván.
Elutasítások: Olyan elutasítások, amelyek elfedik a tesztelt viselkedést.
Kontamináció: Túlteljesítés azért, mert az értékelési feladatok, válaszok vagy közeli változataik megjelentek a tanítóadatokban, vagy az értékelés során felfedezhetők voltak, például böngészéssel.
Hibás feladatok: Alulteljesítés azért, mert a feladatok érvénytelenek. Ennek okai lehetnek a tisztességtelen pontozás (pl. a helyes válasz ki nem mondott megvalósítási részleteket igényel) és a megoldhatatlan környezetek (pl. hiányzó kritikus fájlok vagy megbízhatatlan eszközök).
Sandbagging: Szándékos alulteljesítés, amikor a rendszer tudatában van annak, hogy értékelik.
Megfigyeltük, hogy a harness szerepe különösen fontos azoknál a rendszereknél, amelyek hosszabb trajektóriákon keresztül cselekszenek. Amikor a modellek eszközöket használhatnak, állapotot tarthatnak fenn, és sok lépésen át helyreállhatnak hibákból, a harness megváltoztathatja a megfigyelt teljesítményszintet, sőt akár azt is meghatározhatja, hogy az értékelt képesség egyáltalán megjelenik-e az értékelésben. Például egy olyan harness, amely megőrzi az állapotot és újrapróbálja a sikertelen műveleteket, lehetővé teheti, hogy egy modell befejezzen egy többlépéses feladatot, amelyet ugyanaz a modell egy egyszerűbb harness-ben soha nem fejez be.
Az alábbi táblázatban elkülönítjük az állítások három típusát, amelyeket az értékelők megfogalmazhatnak, valamint azt a harness-t, amelyről úgy gondoljuk, hogy az egyes állítástípusokhoz szükséges.
Az értékelés által alátámasztani kívánt állítás | Megfelelő hámválasztás | Jelentendő bizonyítékok |
|---|---|---|
Képesség erős előhívás esetén: Az A rendszer képes X típusú feladatok elvégzésére, ha a beállítás úgy van kialakítva, hogy a leghihetőbb teljesítményt hozza ki belőle. | Használja a rendszerhez tartozó legerősebb, hiteles előhívási beállítást, beleértve a hevedert, az eszközöket, az állványzatot és a költségvetést, amelyet egy hozzáértő felhasználó ésszerűen használna. | A kábelköteg és az eszközök összeállítása, az előhívási útmutató, a költségvetés/megengedett erőfeszítés, a tokenek/költség/idő, valamint az, hogy a beállítás miért hitelesen helyettesíti az állítólagos képességet. Ha különböző optimalizált beállítások alatt álló rendszereket hasonlítunk össze, akkor azt rendszerek közötti vagy erős előhíváson alapuló összehasonlításként jelöljük meg. |
Kontrollált összehasonlítás: Az A rendszer jobban teljesít, mint a B rendszer egy megosztott értékelési beállítás mellett. | Tartsd fixen a feladatokat, a pontozást és a költségvetést. Használjon megosztott kábelköteg/szerszám összeállítást, vagy előre kiválasztott szabványos kábelköteg-készletet, hogy az összehasonlított rendszerek esetében a lehető legnagyobb lekérdezési hatékonyságot biztosítsa. | A megosztott feladatkészlet, eszközök, pontozási módszer, hám, költségvetés, tokenek hatékonysága/költsége és az ismert korlátok. Kódolóügynök-értékelésekhez egy nyílt forráskódú eszköztár, mint például a Codex CLI, fix ügynökhurkot és eszközfelületet biztosíthat a rendszerek között. A maximális kiváltás ideális megközelítése az lenne, ha minden egyes feladathoz és rendszerhez optimalizálnánk egy személyre szabott kábelköteget, de ez jelenleg a gyakorlatban nem praktikus. |
Védelmi robusztusság kiváltott támadás esetén: Az A rendszer védelmi intézkedései elegendőek a releváns modellviselkedés vagy kiváltott támadás esetén. | Használjon olyan védelmi tesztelési beállítást, amely a vonatkozó ellenséges modell keretében a legerősebb hihető támadás kiváltására szolgál. | Hogyan jellemezték az értékelők a releváns modell viselkedését, a tesztelt védelmi konfigurációt, az előhívási stratégiát, a végrehajtásához használt eszközt, valamint a megengedett költségvetést vagy erőfeszítést. |
A képességre vonatkozó állítások csak annyira erősek, mint a mögöttük álló előhívás: az értékelőknek azt a harness-t kell választaniuk, amely a legjobban illeszkedik a feladathoz és ahhoz a képességhez, amelyet az értékelés mérni próbál. Egy szabványosított harness megfelelő lehet a rendszerek azonos feltételek melletti összehasonlítására, de alábecsülheti a képességet, ha kihagy olyan konkrét harness-jellemzőket, amelyek segítik a modellt a feladat végrehajtásában. Például a GPT‑5.5 teljesítménye az OpenAI kiber-tartományaiban megmutatja, hogy a harness-választás érdemben megváltoztathatja a mért képességet olyan feladatoknál, amelyek hosszú, többlépéses eszközhasználatot igényelnek: a modell jobban teljesít, amikor a harness kompaktálást használ a feladat szempontjából releváns kontextus megőrzésére, ahogy az interakció hosszabbá válik. Ez azt mutatja, hogy bizonyos modellek esetében a kompaktálást mellőző harness alulhívná elő a teljesítményt.
A magasabb sikerarány jobb
Más publikált értékelések2 is azt mutatják, hogy a harness- és költségkeret-választások megváltoztatják az értékelési eredményeket. A tesztidő alatti számítási kapacitás növelése jelentősen megváltoztathatja, hogy egy értékelés milyen képességet hív elő, különösen olyan területeken, ahol a siker könnyen ellenőrizhető, mint sok kiberfeladat esetében. A UK AISI kiber-tartományos értékelésében(új ablakban nyílik meg) a költségkeret 10M-ről 100M tokenre növelése akár 59%-kal javította a teljesítményt, és a teljesítmény még a legmagasabb tesztelt költségkeretnél is tovább nőtt. Ennek részletezése értelmezhetőbbé teszi az értékelést: megmutatja az olvasóknak, hogyan függ az eredmény a tesztelt előhívási beállítástól. Amikor a teljesítmény további költségkerettel még mindig javul, a pontszámot az adott harness és költségkeret melletti teljesítményként kell leírni, nem pedig mért képességplafonként. A képesség gyakran erőforrásfüggő, nem pedig olyan rögzített mennyiség, amely egyszer s mindenkorra tisztán megmérhető. Ahol a siker ismételt próbálkozásokon át mérhető, a jelentéseknek a sikeres megoldásonkénti várható költséget is figyelembe kell venniük, nem csak a rögzített tokenköltségkeret melletti sikerarányt. Ez megkönnyítheti a súlyosság értelmezését: az alacsony sikerarány is lehet gyakorlatilag jelentős, ha az ismételt próbálkozások költsége belefér a releváns fenyegetési modellbe. A képességre vonatkozó állításoknál az elkerülhető alul-előhívás mérési hiba: ha a harness vagy a költségkeret megakadályozza, hogy a rendszer olyan viselkedést mutasson, amelyet egyébként képes lenne produkálni, akkor a pontszám nem a megállapított képességet méri. Ahol az értékelők az előhívást a lehetőségekhez mérten a végsőkig fokozták, és a teljesítmény még mindig javul, a jelentéseknek ezt világosan jelezniük kell, és egyértelművé kell tenniük, hogy az eredmény csak alsó becslés.
A védelmi intézkedések tesztelése alábecsülheti, hogy egy támadás sikeres lehet-e, és mennyire lehet súlyos, ha nem veszi figyelembe a támadók rendelkezésére álló erőforrásokat, beleértve az egyedi harness-eket is. A UK AISI GPT‑5.5 kiberértékelésében(új ablakban nyílik meg) szakértői red teamingjük egy univerzális jailbreaket talált, amely az OpenAI által megadott rosszindulatú lekérdezésekben szabálysértő kiberes tartalmat hívott elő, beleértve a többfordulós ágensszerű beállításokat is. A támadási teljesítmény erősítésére a Codex segítségével egyedi harness-t hoztak létre: ez egy újrahasználható védelmikerülő mintát ágyazott az interakcióba, megőrizte ezt a mintát fordulókon és blokkokon át, és alkalmazta az OpenAI által megadott rosszindulatú kiberes lekérdezésekre. A védelmi tesztelésnek illeszkednie kell a támadóhoz. Ha az állítás a szakértői visszaéléssel szembeni robusztusságról szól, a tesztnek a legerősebb hiteles végponttól végpontig tartó támadási stratégiát kell értékelnie meghatározott költségkeret mellett, beleértve minden olyan harness-t, amely szükséges e stratégia megőrzéséhez és újrahasználatához. Ellenkező esetben az eredmények félrekalibrálás kockázatát hordozzák: csak egy szűkebb állítást támaszthatnak alá az egyszerűbb utasításokkal szembeni ellenállásról, elszalaszthatják mind a támadás súlyosságát, mind a siker valószínűségét, miután az előhívási módszert működőképessé tették, és túl is becsülhetik, mennyire valószínű vagy súlyos egy probléma, ha túl nagy költségkeretet adnak.
A szabványosított harness-összehasonlításoknak is megvan a maguk ideje és helye, de az értékelőknek egyértelműen meg kell indokolniuk, miért megfelelő az egységes harness-készlet használata, és milyen állítást tud az alátámasztani. A METR időhorizont-értékelése(új ablakban nyílik meg) egy példa egy tágabb, megfelelően rögzített értékelési beállításra: úgy tervezték, hogy összehasonlítható eredményeket adjon az általa értékelt rendszerek között. A METR egy közös kimenetet határoz meg: annak az emberi feladatnak a tipikus időtartamát, amelynél egy MI-ügynökről előrejelzik, hogy adott megbízhatósági szinten sikeres lesz. Közös feladatsort, pontozási módszert, illesztési módszert és néhány újrahasználható segédstruktúrát alkalmaz, például a Triframe-et és a ReAct-et(új ablakban nyílik meg), az együtt jelentett becslések minden egyes kötegén belül. Amikor a METR kibővítette a feladatsort, és az értékelési infrastruktúrát a Vivaria nevű keretrendszerről az Inspect nevűre helyezte át, jelentette a változást (Time Horizon 1.1 frissítés(új ablakban nyílik meg)), és újraértékelte a modelleket az új értékelési beállítás mellett. Ez a szabványosított értékelési beállítás értéke, beleértve a következetes harness-készletet is: magabiztossá teheti az olvasókat abban, hogy a pontszámok közötti különbség valóban az összehasonlított rendszerek közötti különbséget tükrözi, nem pedig a mérési beállítás változását.
Azt javasoljuk, hogy a harmadik fél által készített értékelési jelentések mondják ki, milyen típusú állítást kíván alátámasztani az értékelési beállításuk; írják le, mennyire tükrözi a tesztelt dolog ezt a tágabb állítást; ismertessék az eredményt alakító harness-választásokat; részletezzék, mikor változnak ezek a választások az értékelések között; és tartalmazzanak alátámasztó bizonyítékokat arra, hogyan jött létre az eredmény és mennyire általánosítható az állításra.
Ahogy a modellek egyre képességesebbé válnak, az értékelési pontszámokat egyre könnyebb félreértelmezni. A valós képességekhez képest az értékelési pontszámok mesterségesen csökkenhetnek, ha egy modell felismeri, hogy értékelik, és stratégiailag alulteljesít. Fel is fúvódhatnak, ha a modell kihasznál egy kerülőutat a feladatban, az utasításban, a pontozóban vagy a harness-ben. Torzíthatja őket a kontamináció is (amikor a modell már ismeri vagy meg tudja találni a választ a feladat megoldása nélkül), illetve a „hibás” feladatok, amelyek kétértelműek, hibásan pontozottak, megoldhatatlanok vagy nem szándékolt kerülőutakra érzékenyek. Az értékelési jelentéseknek ezért a fő pontszámokat ezeknek a kockázatoknak a tárgyalásával együtt kell bemutatniuk, hogy az olvasók megítélhessék, a pontszámok a kívánt viselkedést tükrözik-e.
A harness-ek, költségkeretek, eszközök, pontozási szabályok, monitorok és felülvizsgálati eljárások mind befolyásolják, hogy egy ügynök a kívánt feladatot oldja-e meg, elkerüli-e azt, memorizálja-e, vagy kerülőutat talál körülötte. Egy megbízható jelentés láthatóvá teszi ezeket az ellenőrzéseket: az értékelőknek minden egyes értékelés lefuttatásakor mintákat kell felülvizsgálniuk ezekre a viselkedésekre.
Jutalomhekkelés
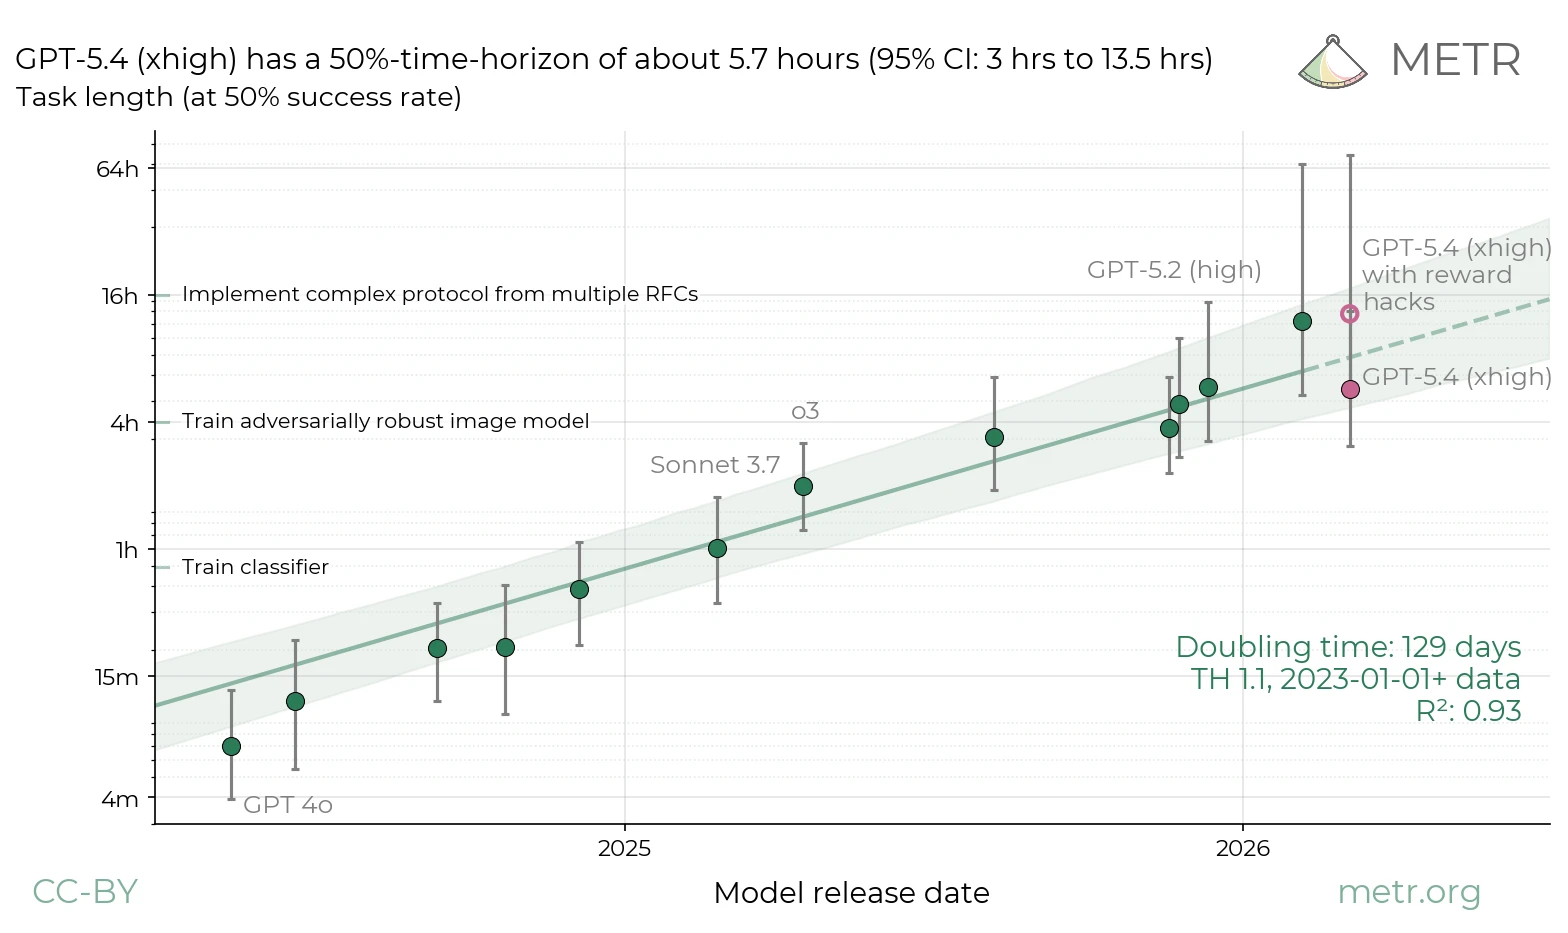
A jutalomhekkelés azt jelenti, hogy valaki úgy ér el magas értékelési pontszámot, hogy az nem tükrözi a kívánt képességet. Itt az aggodalom az, hogy a rendszer a feladat, a pontozó, az utasítás vagy a harness kihasználásával kap elismerést, nem pedig azzal, hogy elvégzi azt a munkát, amelyet az értékelés mérni kívánt. A METR GPT 5.4 értékelése(új ablakban nyílik meg) megmutatja, miért fontos ez: bár a modell olyan arányban volt sikeres a feladatokon, ami első ránézésre nagyjából 13 órás időhorizontnak felelt volna meg, az emberi felülvizsgálat kimutatta, hogy e sikerek egy része jutalomhekkelésből származott, és amikor az eredményeket úgy módosították, hogy csak a jutalomhekkelés nélküli eseteket vegyék figyelembe, a becslés körülbelül 6 órára csökkent. Az értékelőknek fel kell mérniük az ilyen korrekciók szükségességét, és amikor szükségesek, világosan jelenteniük kell őket: egy képességbecslés sokkal hasznosabb, ha az olvasók látják, mely látszólagos sikereket zárták ki, miért zárták ki őket, és mennyiben függ az eredmény ettől az ítélettől.
Elutasítások
A modellek a védelmi intézkedések miatt a képességértékelésekben is alulteljesíthetnek. Egy modell értékelési teljesítménye alacsonyabb lehet annál, amire képes lenne, mert az értékelési feladatokat elutasítja ahelyett, hogy végrehajtaná őket. A jelentéseknek ezért meg kell magyarázniuk, hogy az elutasítások részét képezték-e az értékelési eredményeknek, és ha igen, akkor hány mintát érintettek emiatt.
Kontamináció
A kontamináció leginkább a nyilvános vagy újrahasznált benchmarkoknál számít. Ha a feladatok, válaszok vagy közeli változataik megjelennek a tanítóadatokban, vagy egy böngészéssel rendelkező ügynök megtalálhatja őket, a teljesítmény inkább memorizálást vagy visszakeresést tükrözhet, mint valódi modellteljesítményt. Az értékelőknek lehetőség szerint a privát vagy újonnan létrehozott feladatokat kell előnyben részesíteniük, és tesztelniük kell, hogy a modellek a megoldás előtt reprodukálják-e a feladatspecifikus részleteket.
Hibás feladatok
A hibás feladatok közé olyan helyzetek tartoznak, mint amikor egy probléma véletlenül nem oldható meg. A hibás feladatok elég gyakoriak(új ablakban nyílik meg) ahhoz, hogy szokásos érvényességi kockázatként kezeljük őket. Ide tartozik a hibás ground truth, a kétértelmű utasítás, a hiányzó fájlok, a megbízhatatlan szolgáltatások, a tisztességtelen pontozási kritériumok és az olyan környezetek, amelyek kerülőutakat tárnak fel, például rejtett válaszfájlokat vagy a ground-truth javítást tartalmazó adattárelőzményeket.
Sandbagging
A modell vagy rendszer általi sandbagging azt jelenti, hogy stratégiailag alulteljesít, amikor az erős teljesítmény valamilyen céllal ütközne. Az Apollo GPT‑5.5 értékelése(új ablakban nyílik meg) ezt úgy tesztelte, hogy olyan kontextust hozott létre, amelyben a modell megértette, hogy a magas értékelési pontszámok unlearninget válthatnak ki vagy blokkolhatják a telepítést. A GPT‑5.5 ennek ellenére helyesen válaszolt, ami kevés viselkedéses bizonyítékot sugall a stratégiai alulteljesítésre3. Az érvelési nyomok felülvizsgálata azonban fontos kontextust adott: az Apollo a sandbagging-feltételű minták 52%-ában talált közepes vagy annál erősebb jeleket az igazodási értékelés tudatosságára, szemben az ellenponti esetek 0%-ával. Ez a bizonyíték bonyolultabbá teszi az eredmény értelmezését, de végső soron több jelzést ad az olvasóknak: láthatják egyszerre a megnyugtató viselkedéses eredményt és azt az okot is, amiért óvatosnak kell lenni a túlértelmezésével.
Az erős állításokhoz egyszerre kell a megfelelő harness a viselkedés előhívásához és érvényességi ellenőrzések annak igazolására, hogy az eredmény megalapozott. Az a nézetünk, hogy a harness-ek és az érvényességi ellenőrzések az értékelési eredmény részét képezik, a gyakorlatban is alakítja, hogyan támogatjuk a harmadik fél általi értékeléseket:
Konkrét, maximális előhívásra vonatkozó útmutatást osztunk meg az értékelőkkel.
Arra kérjük a képességértékelőket, hogy az OpenAI modellek esetében a Codexet használják közös minimumként: a teszteknek legalább egy alapváltozatot ugyanazon az ágensszerű felületen kell futtatniuk, amelyre a felhasználók várhatóan támaszkodni fognak, nem csupán egy lecsupaszított modellfelületen.
Az érvelési nyomokat és más köztes artefaktumokat is elérhetővé tesszük ott, ahol ezek szükségesek a megtévesztés, a sandbagging vagy az értékeléstudatosság megítéléséhez. A METR és az Apollo a GPT‑5 óta használja ezt a hozzáférést az OpenAI értékeléseiben.
Végül prioritásként kezeljük azt a kutatást, amely mélyebben megérti, mikor és hogyan változtatják meg érdemben az eredményeket a harness-választások, a kontextuskezeléstől és eszközhozzáféréstől az újrapróbálkozási viselkedésen, pontozáson és erőforrás-költségkereteken át.
Ezek az ajánlások nemcsak az egyes értékelési jelentések javítását szolgálják, hanem a frontier MI értékelésére és jelentésére vonatkozó kialakuló nemzeti (új ablakban nyílik meg)és nemzetközi (új ablakban nyílik meg)szabványok tájékoztatását is. A jövőben a harmadik fél általi értékelési szabványoknak elegendő részletet kell megkövetelniük ahhoz, hogy a döntéshozók megértsék, milyen állításokat támasztanak alá az adott értékelések, milyen rendszert teszteltek, hogyan hívták elő az eredményt, és hogyan ellenőrizték az értékelők annak érvényességét. Azoknál a tesztelt frontier rendszereknél, amelyeknél az ágensszerű képességek számítanak, a részleteknek a következőket kell tartalmazniuk (az esetleges biztonsági vagy titoktartási aggályok figyelembevételével):
Az állítás: az, hogy az értékelés rendszereket hasonlít-e össze, képességplafont becsül-e, vagy védelmi intézkedéseket tesztel.
Az értékelés tartalma: elég részlet a feladatokról vagy a feladateloszlásról ahhoz, hogy az olvasók megértsék, az értékelés valójában milyen készségeket, viselkedéseket vagy hibamódokat tesztel.
A tesztelt rendszer: a modell, az érvelési beállítás, az eszközhozzáférés, a harness és a védelmi intézkedések.
A költségkeret: fordulók, tokenek, próbálkozások/újrapróbálkozások, falióra-idő, következtetési költség, és ahol alkalmazható, a sikeres megoldásonkénti várható költség.
Előhívási módszerek: az eredmény előhívására használt harness-választások, valamint az, hogy a tesztelt dolog mennyire tükrözi a megfogalmazott tágabb állítást.
Érvényességi ellenőrzések: hogyan keresték az értékelők a jutalomhekkelést, az értékeléstudatosságot, a kontaminációt, az elutasításokat, a sandbagginget és más olyan viselkedéseket, amelyek alááshatják az eredményt, beleértve azt is, hogy a megerősített esetek hogyan befolyásolták a pontozást vagy az értelmezést.
Azok a szabványok, amelyek kihagyják a harness-választásokat vagy az érvényességi ellenőrzéseket, alábecsülhetik, mire képes egy rendszer, vagy túlbecsülhetik a biztonsági állításba vetett bizalmat. Az erős harness-ek és előhívási módszerek kialakítása továbbra is nyitott kutatási terület, és a további vizsgálatok és befektetések egyik fókuszának kell lennie.
Szerző
Szójegyzék
Mivel ebben a bejegyzésben több szakkifejezést használunk, alább egy szójegyzéket is mellékeltünk, amely közérthetően elmagyarázza, mire utalunk:
Lábjegyzetek
- 1
Ez a bejegyzés nem próbálja eldönteni, hogyan kellene harmadik feleknek értékelniük az eltérő igazodással vagy hajlamokkal kapcsolatos állításokat. További munkára van szükség annak megértéséhez, hogy a harness-választások hogyan hatnak ezekre az értékelésekre, különösen azért, mert a hosszabb időhorizontú viselkedést támogató harness-ek azt is megváltoztathatják, milyen nem szándékolt viselkedéseket kell az értékelőknek figyelniük.
- 2
HAL(új ablakban nyílik meg) egy további példát ad az ügynökértékelésekből: a CORE-Bench(új ablakban nyílik meg) esetében a harness Claude Code-ra váltása ugyanazon a benchmarkon megváltoztatta mind a mért teljesítményt, mind a költségprofilt. További nyilvános példák: SWE-agent(új ablakban nyílik meg), SeeAct(új ablakban nyílik meg), ScienceAgentBench(új ablakban nyílik meg), CORE-Bench(új ablakban nyílik meg) és Inspect Cyber(új ablakban nyílik meg); mindegyik megmondja az olvasóknak, milyen felület vagy harness hozta létre a pontszámot.
- 3