Päättelyn oppiminen laajan kielimallin (LLM) kanssa
Esittelemme OpenAI o1:n, uuden laajan kielimallin, joka on opetettu vahvistusoppimisen avulla suorittamaan monimutkaista päättelyä. o1 ajattelee ennen kuin vastaa, ja se voi tuottaa pitkän sisäisen ajatusketjun ennen vastaamista käyttäjälle.
OpenAI o1 sijoittuu 89. persentiiliin kilpailukykyisissä ohjelmointikysymyksissä (Codeforces), sijoittuu Yhdysvaltojen 500 parhaan opiskelijan joukkoon USA Math Olympiadin (AIME) karsinnassa ja ylittää tohtoritason tarkkuuden fysiikan, biologian ja kemian tehtävien vertailukokeessa (GPQA). Vaikka työ, jonka tarkoituksena on tehdä tästä uudesta mallista yhtä helppokäyttöinen kuin nykyisistä malleista on vielä käynnissä, julkaisemme siitä varhaisen version, OpenAI o1‑preview -mallin, välittömään käyttöön ChatGPT:ssä ja luotetuille API-käyttäjille(avautuu uudessa ikkunassa).
Laajamittainen vahvistusoppimisen algoritmimme opettaa mallille, kuinka ajatella tuottavasti käyttämällä ajatusketjuaan erittäin datatehokkaassa koulutusprosessissa. Olemme havainneet, että o1:n suorituskyky paranee johdonmukaisesti vahvistusoppimisen (opetusaikaisen laskennan) ja ajatteluun käytetyn ajan (testausaikaisen laskennan) lisääntyessä. Tämän lähestymistavan skaalaamisen rajoitukset eroavat huomattavasti LLM-esikoulutuksen rajoituksista, ja jatkamme niiden tutkimista.
o1:n suorituskyky paranee tasaisesti sekä koulutus- että testiaikaisen laskennan aikana
Korostaaksemme päättelyn parannusta GPT‑4o‑malliin verrattuna, testasimme mallejamme useilla ihmiskokeilla ja koneoppimisen vertailuarvoilla. Osoitamme, että o1 suoriutuu merkittävästi GPT‑4o:ta paremmin valtaosassa näistä päättelypainotteisista tehtävistä. Ellei toisin mainita, arvioimme o1:n maksimaalisella testiajan laskenta-asetuksella.
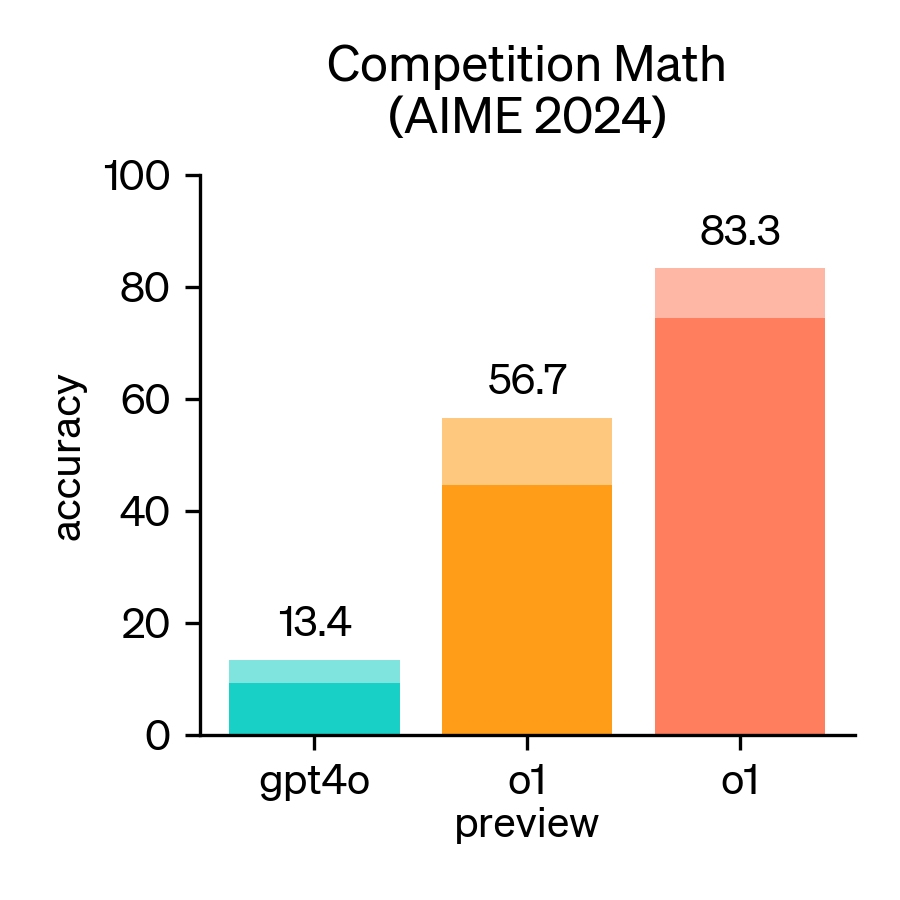
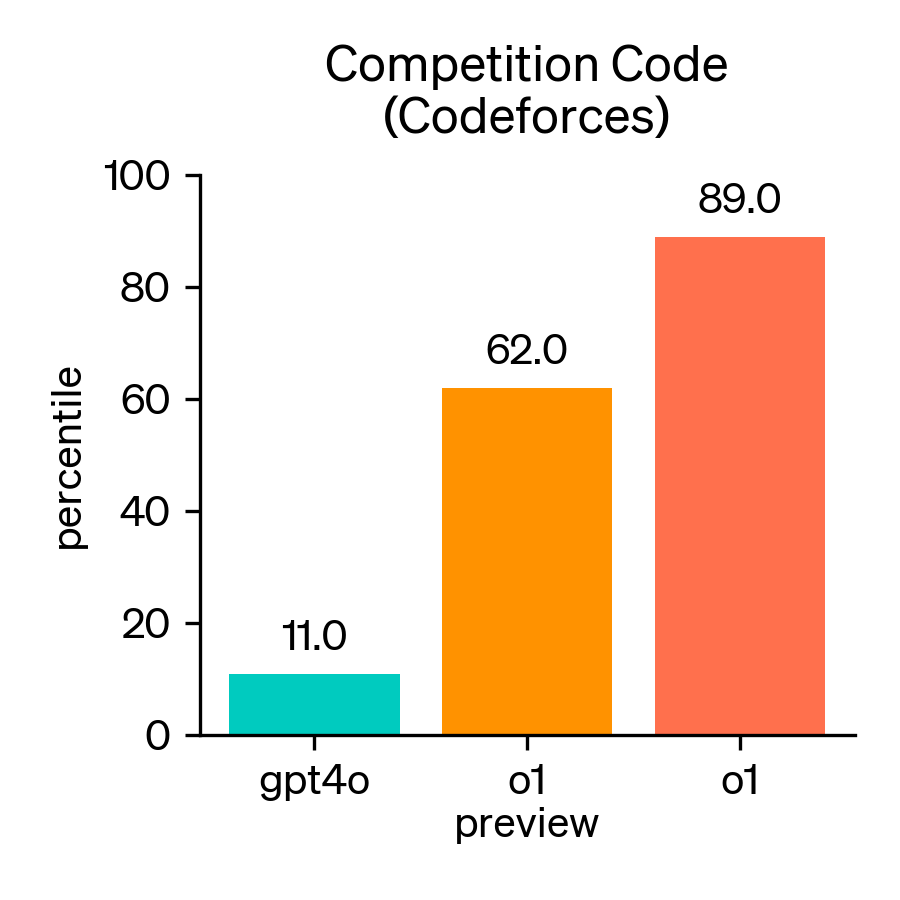
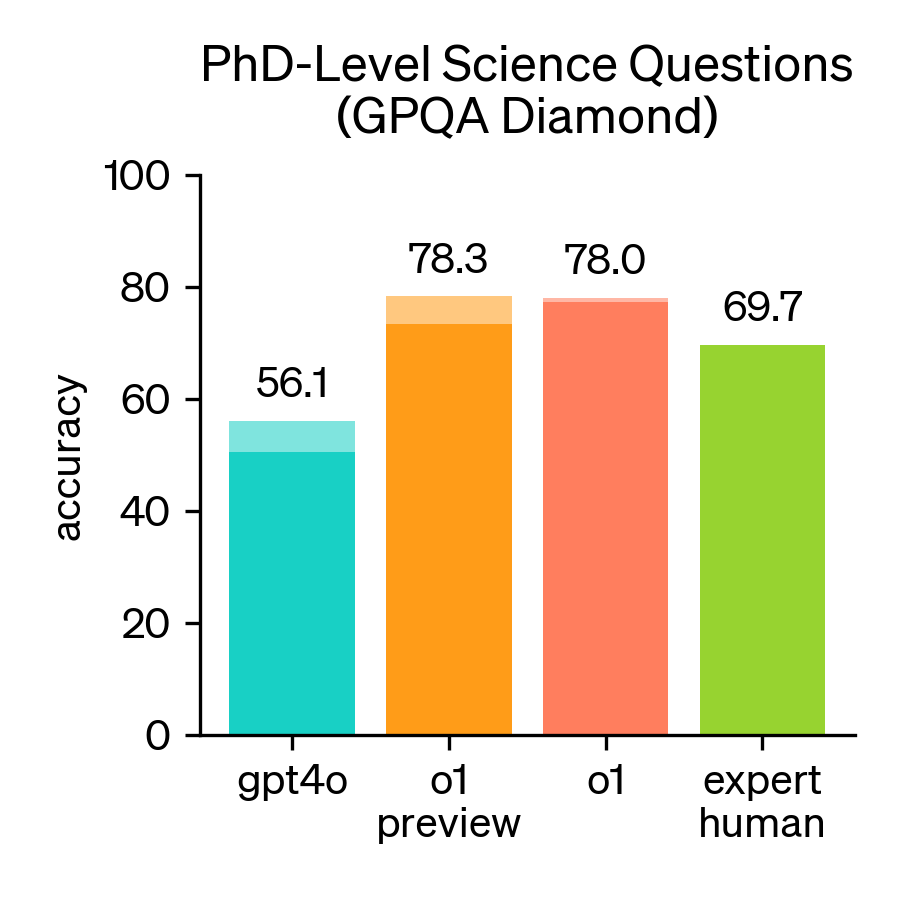
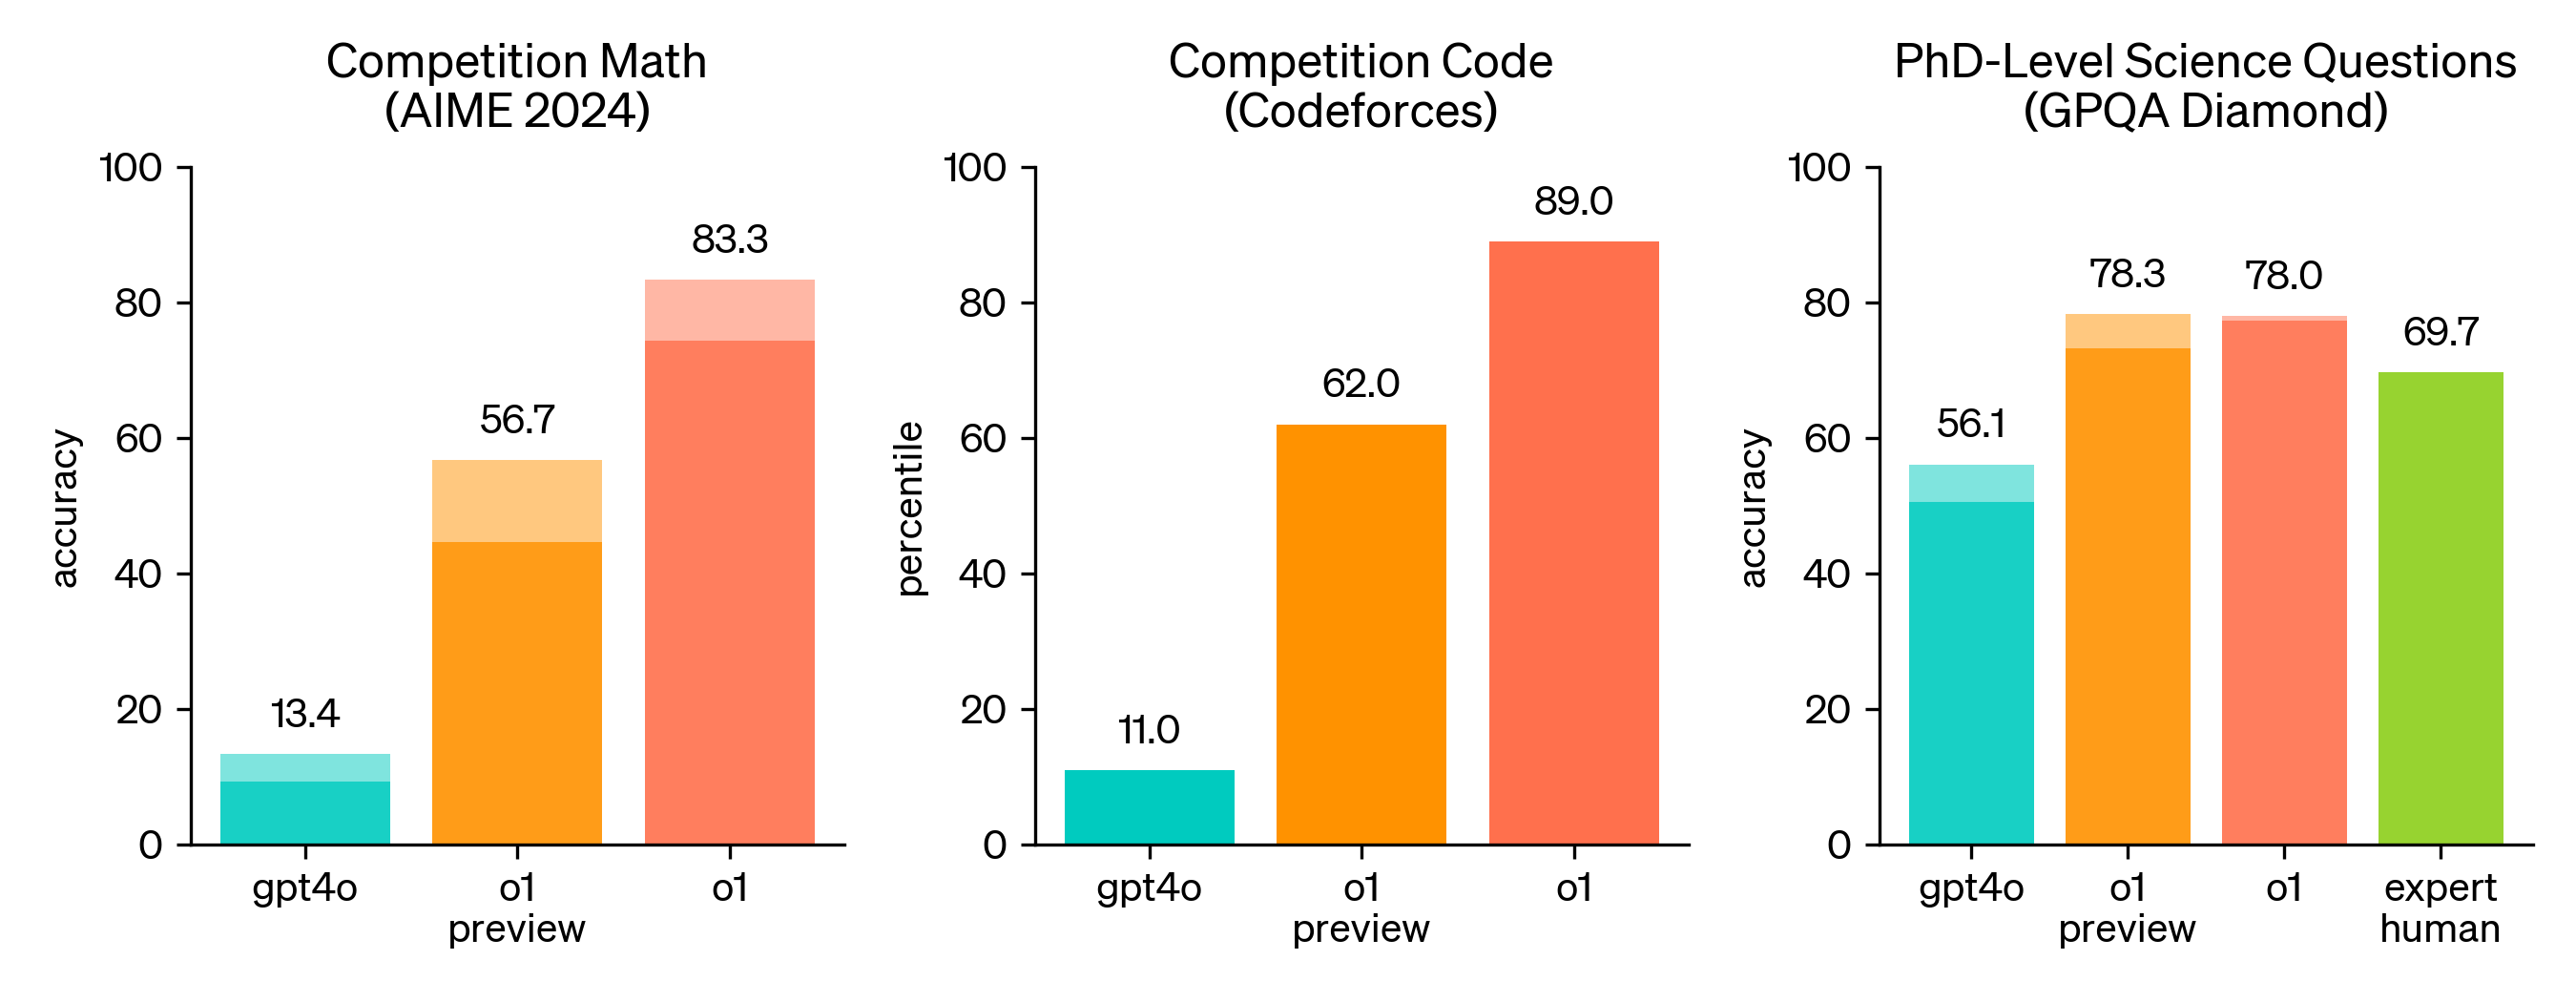
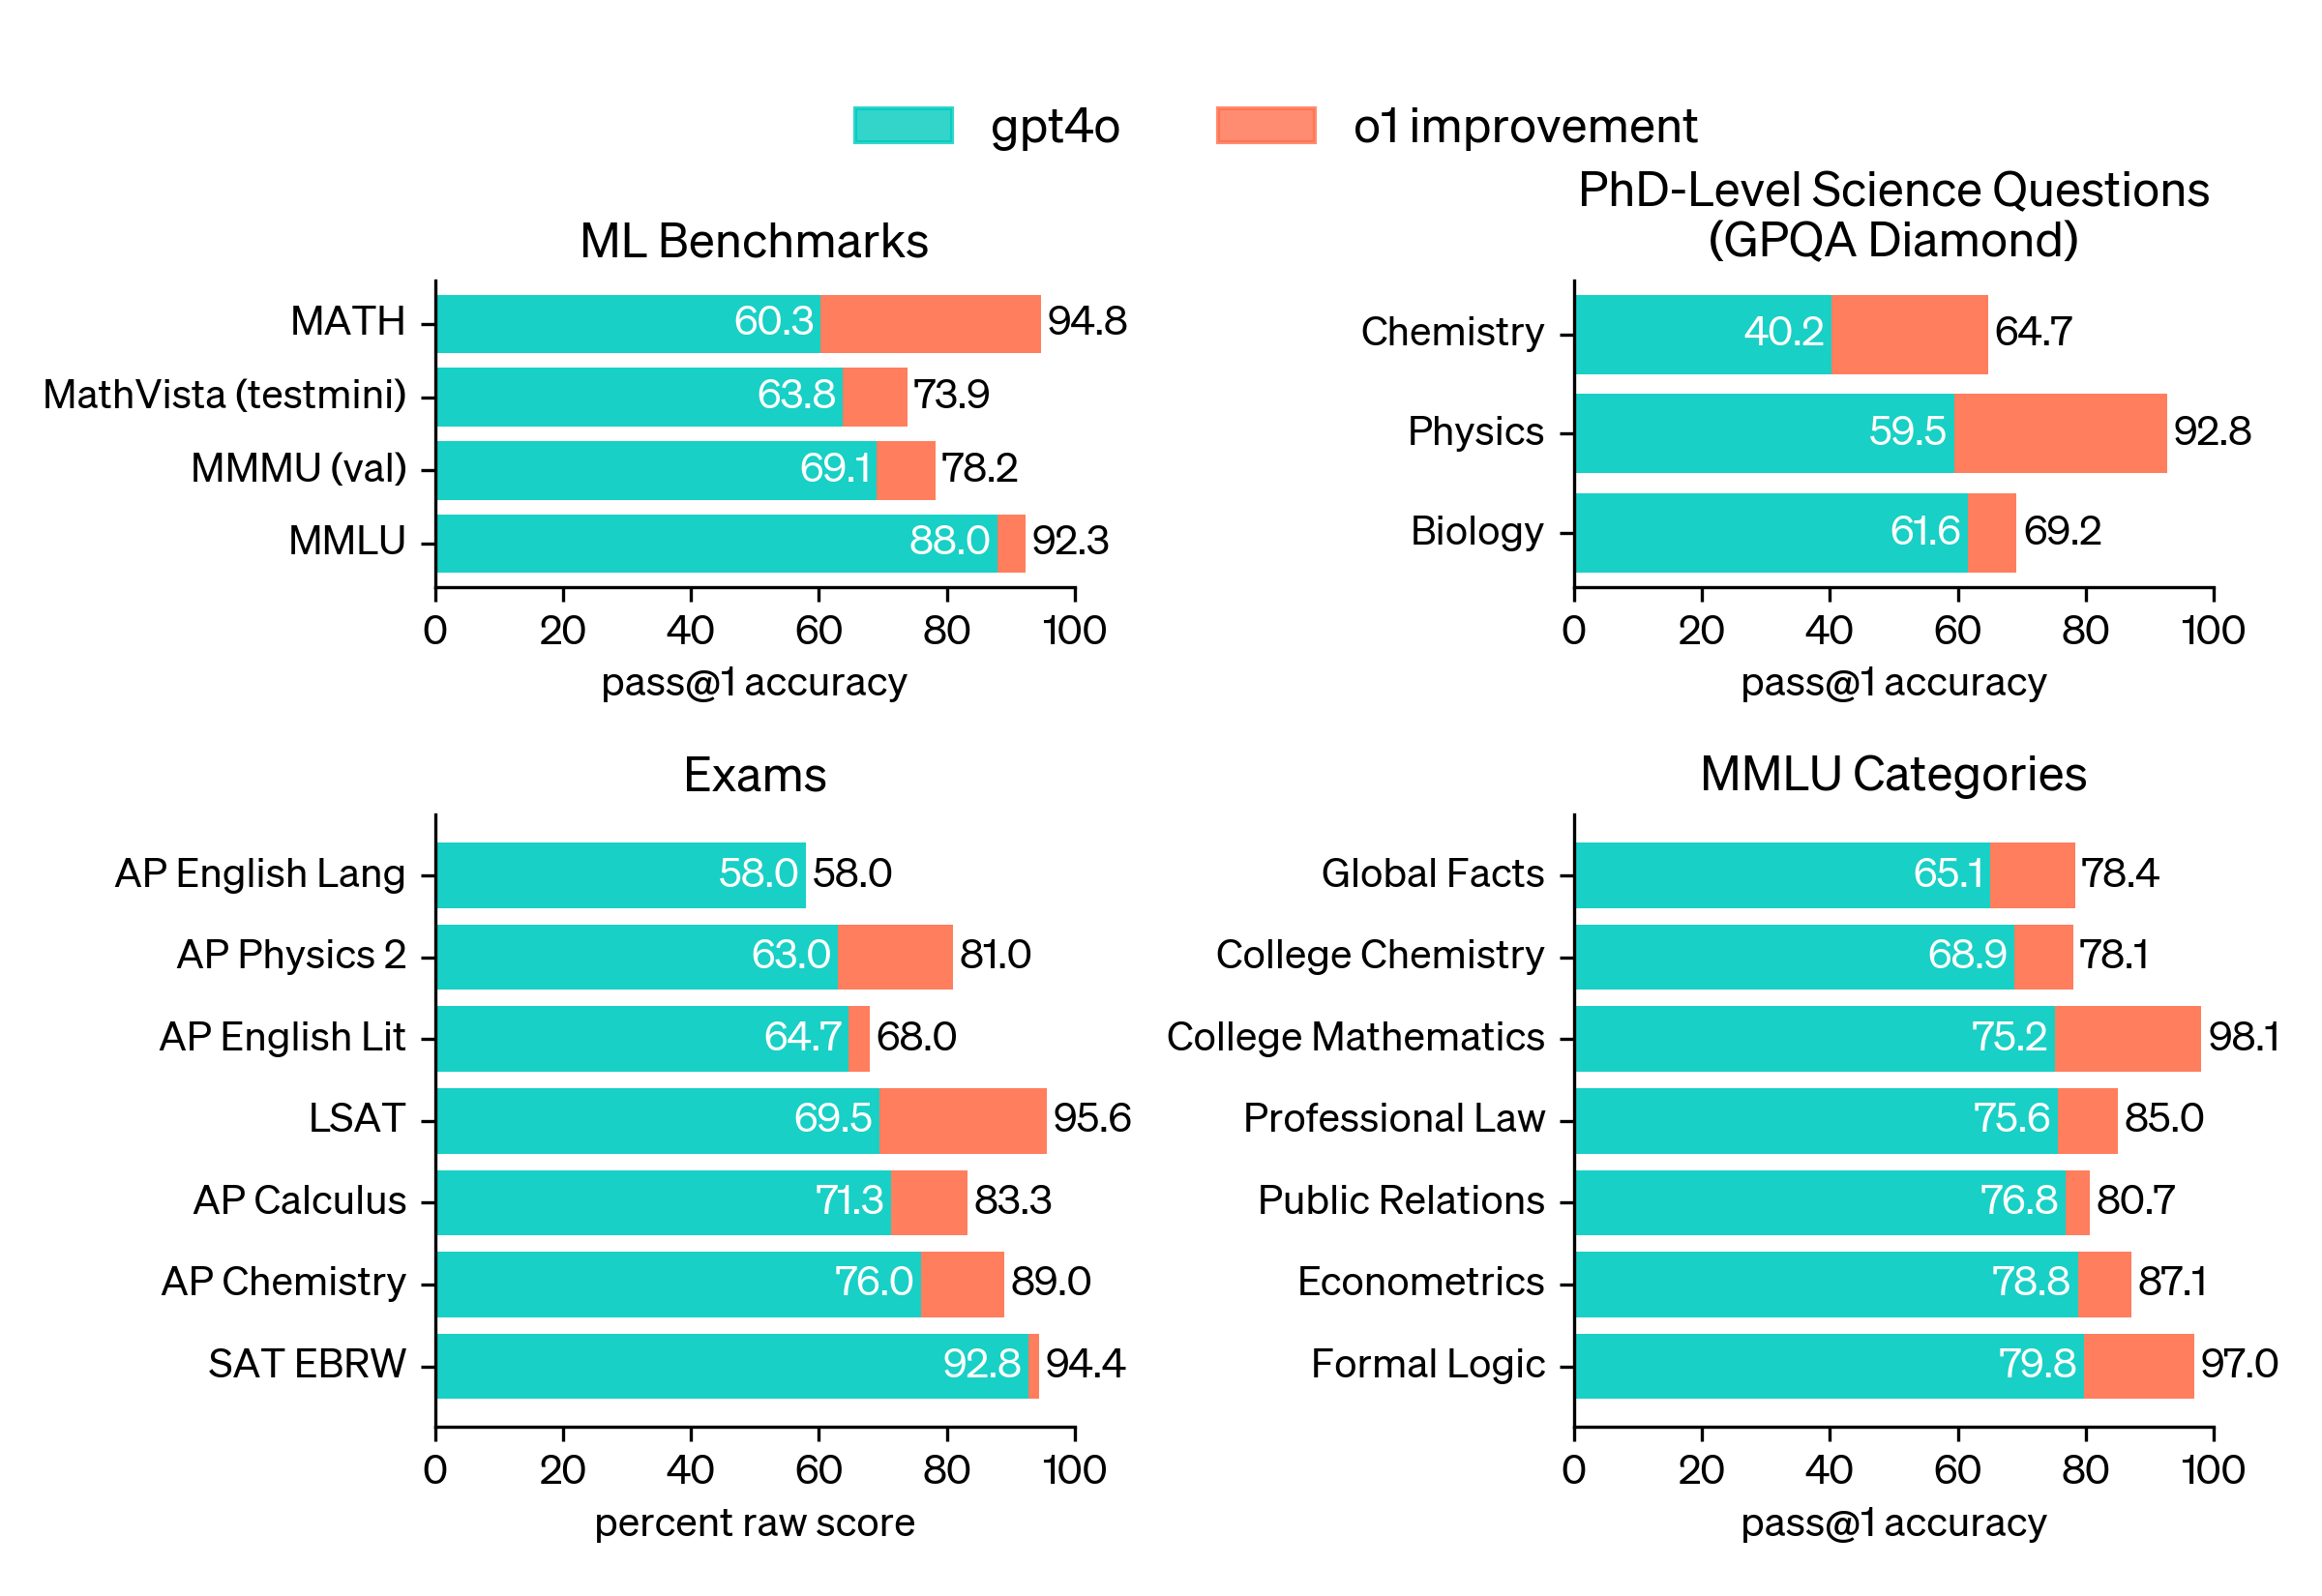
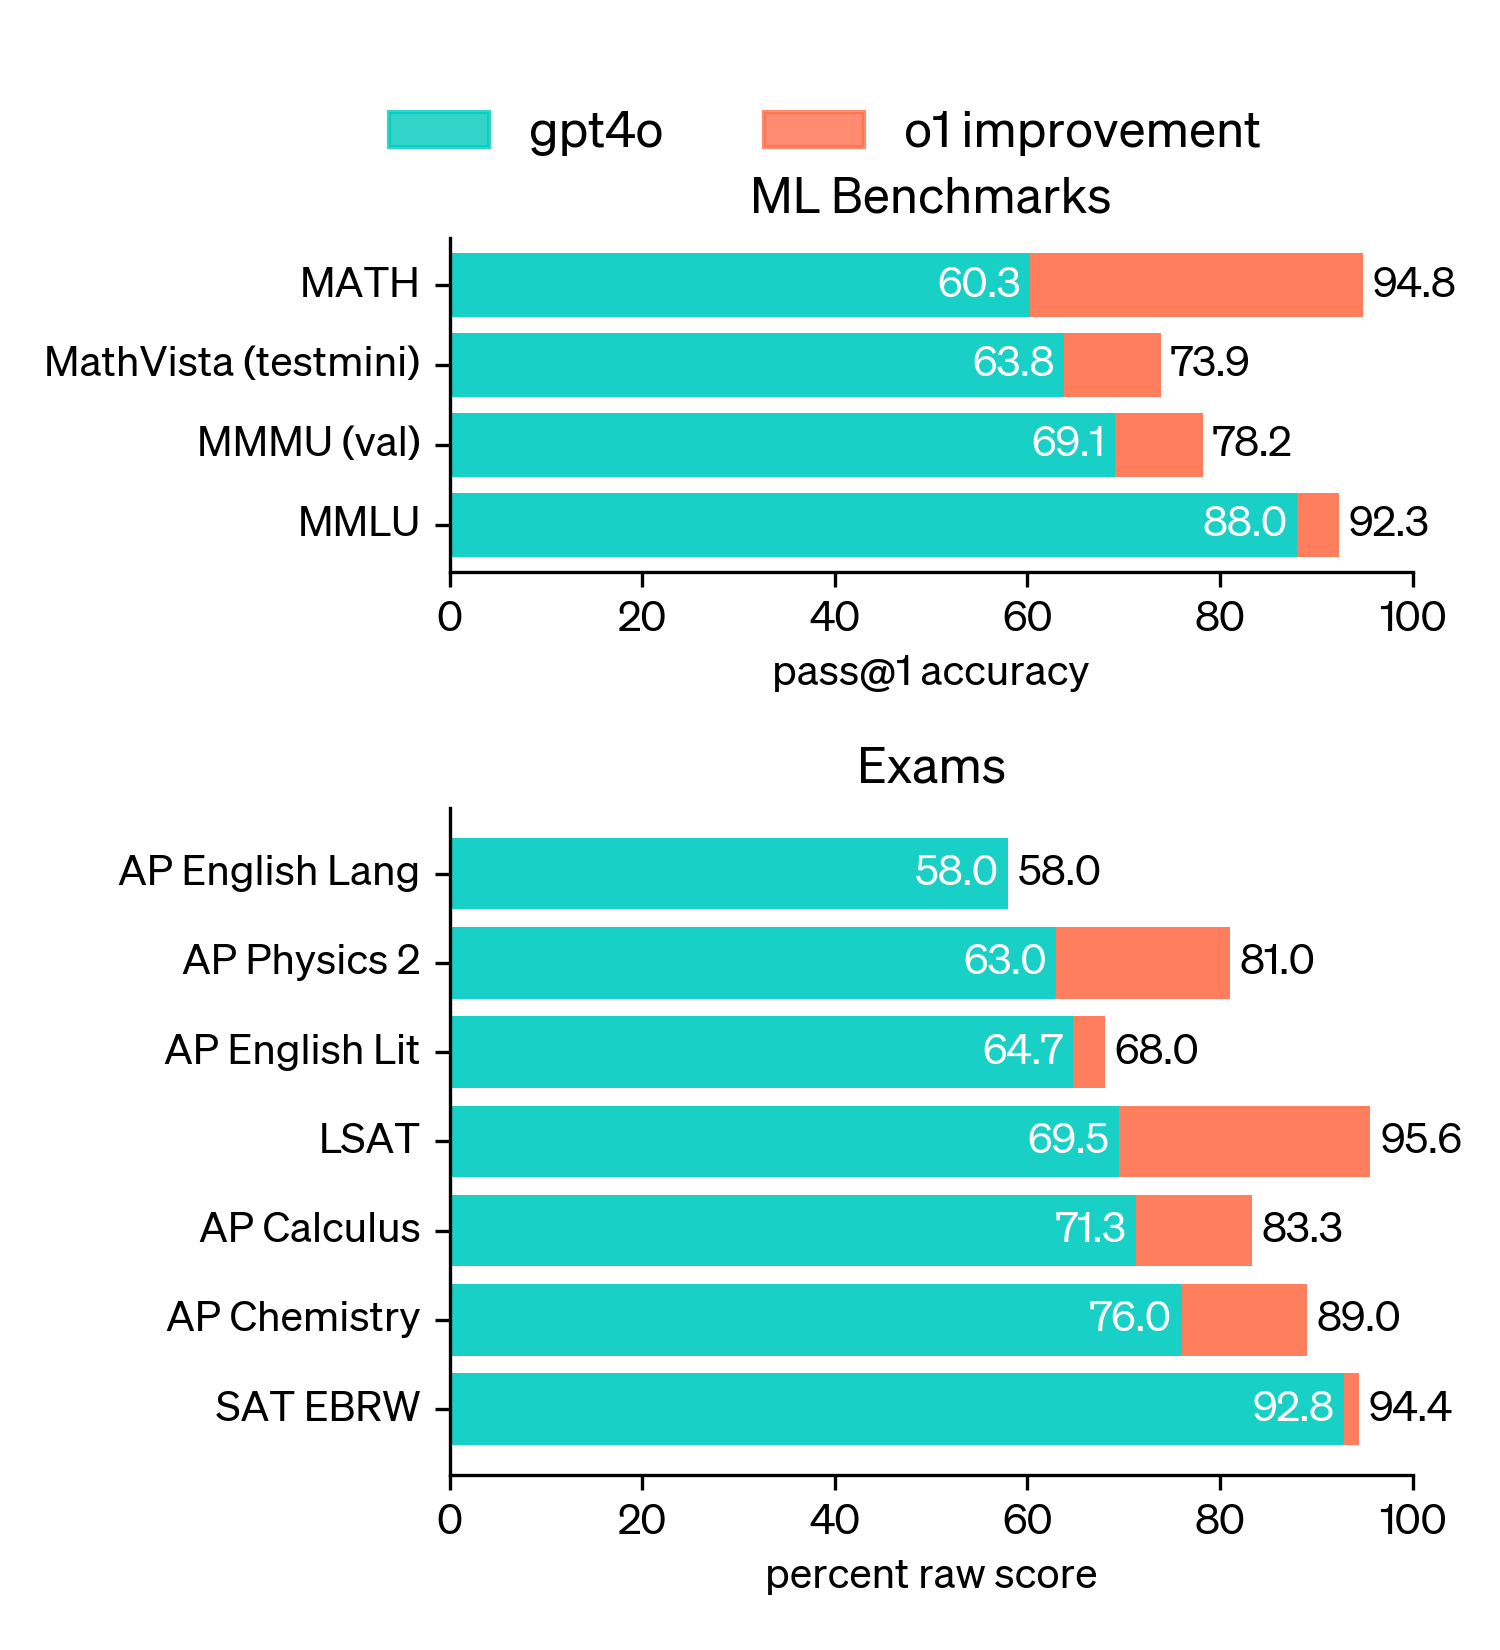
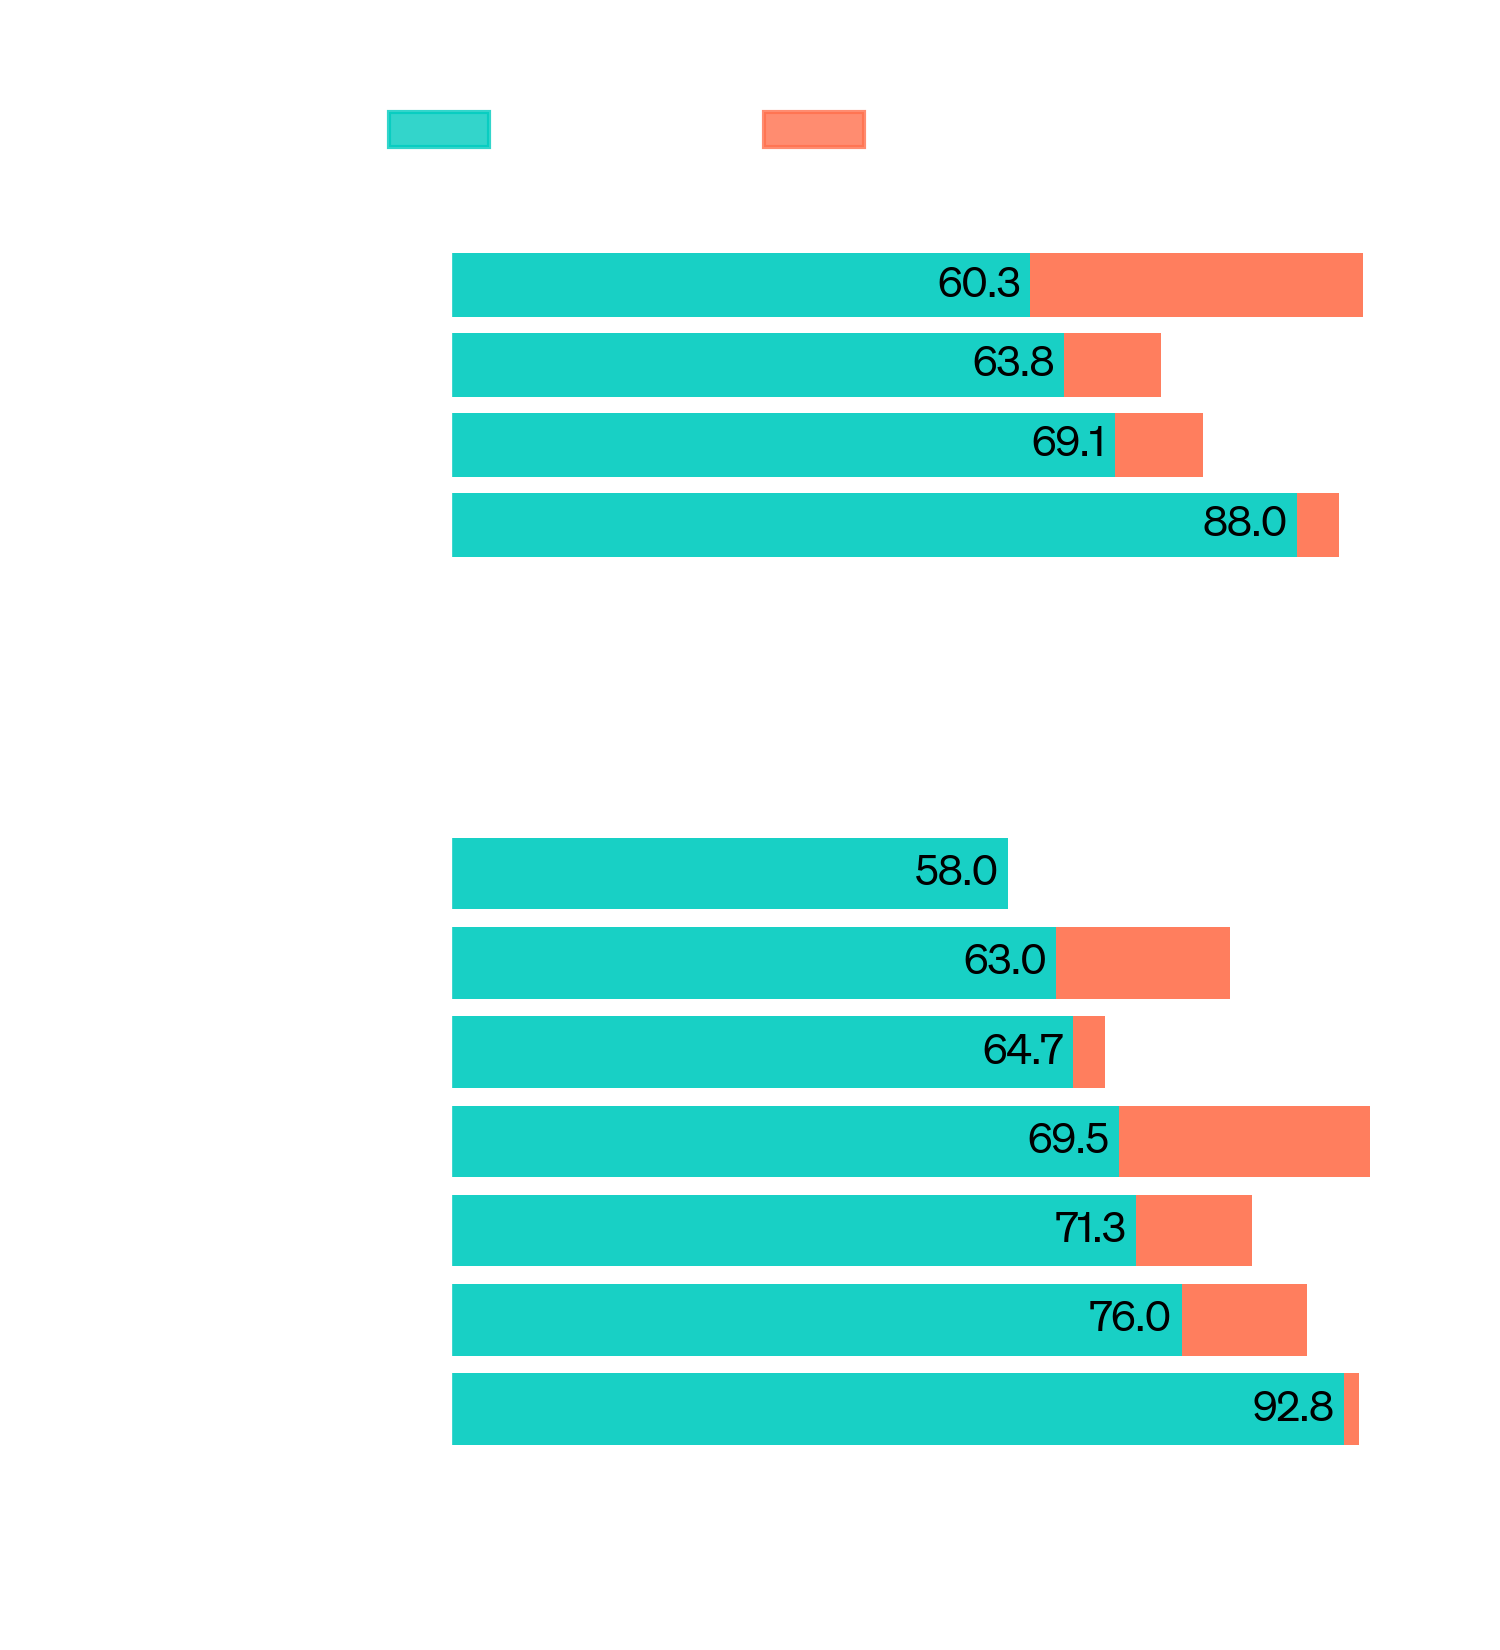
Monissa päättelypainotteisissa vertailuarvoissa o1 kilpailee ihmisasiantuntijoiden suorituskyvyn kanssa. Viimeaikaiset eturintamassa olevat mallit1 pärjäävät niin hyvin MATH2- ja GSM8K-testeissä, etteivät nämä vertailuarvot enää ole tehokkaita mallien erottamisessa toisistaan. Arvioimme suoriutumista matematiikassa AIME-kokeessa, joka on suunniteltu haastamaan Amerikan lahjakkaimmat lukiolaiset matematiikassa. Vuoden 2024 AIME-kokeissa GPT‑4o ratkaisi keskimäärin vain 12 % (1,8/15) tehtävistä. o1 ratkaisi keskimäärin 74 % (11,1/15) yhdellä otoksella tehtävää kohden, 83 % (12,5/15) konsensusratkaisulla 64 otoksen kesken ja 93 % (13,9/15) uudelleenjärjestettäessä 1 000 näytettä opitulla pisteytysfunktiolla. Pisteet 13,9 sijoittavat sen maan 500 parhaan oppilaan joukkoon ja ylittävät Yhdysvaltain matematiikkaolympialaisten osallistumisrajan.
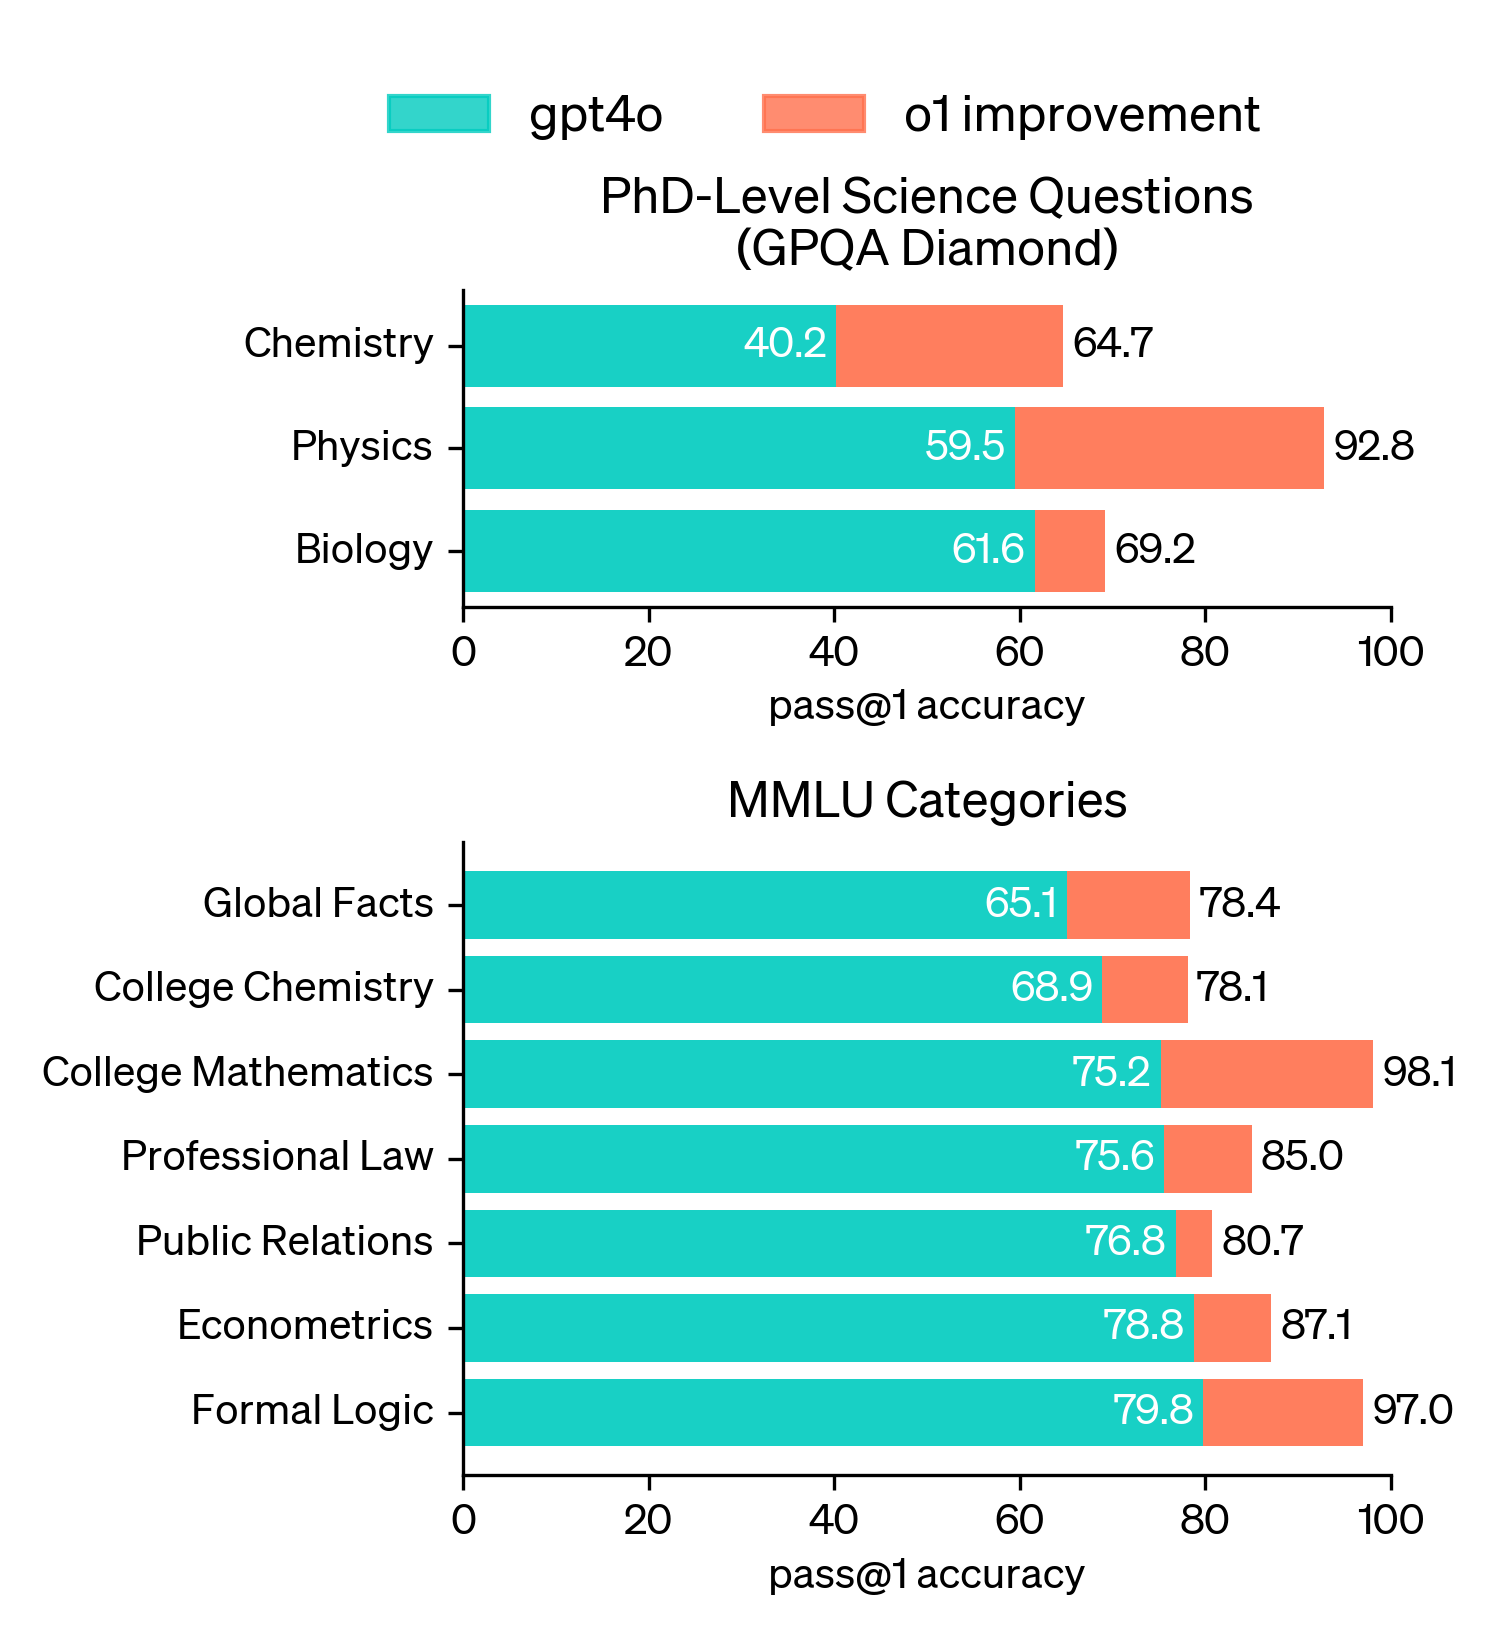
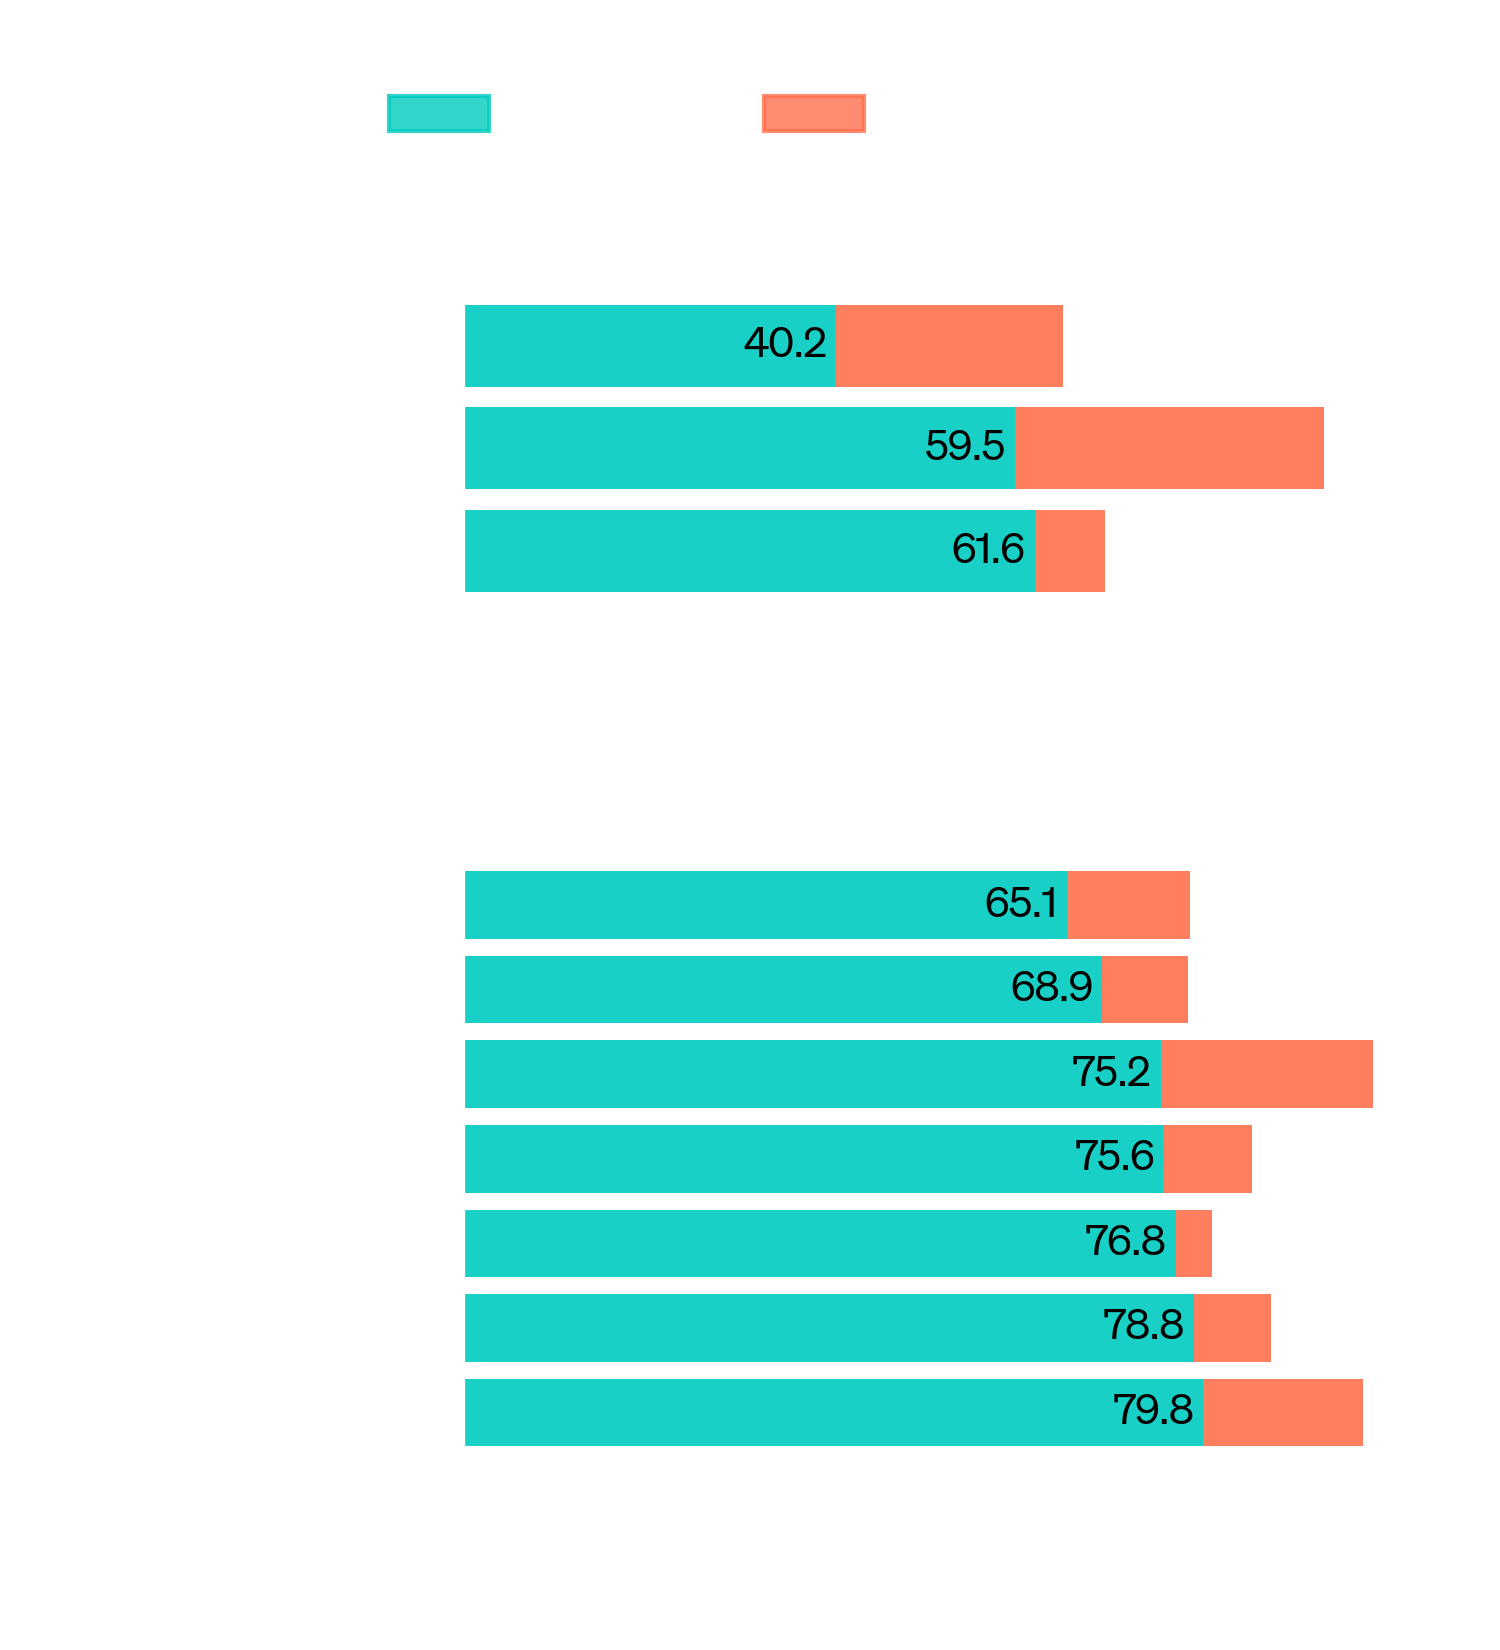
Arvioimme myös o1:tä GPQA Diamondilla, joka on vaikea älykkyystesti, joka testaa asiantuntemusta kemiassa, fysiikassa ja biologiassa. Jotta voisimme verrata malleja ihmisiin, rekrytoimme tohtorin tutkinnon suorittaneita asiantuntijoita vastaamaan GPQA-timanttikysymyksiin. Havaitsimme, että o1 ylitti kyseisten ihmisasiantuntijoiden suorituskyvyn ja se oli ensimmäinen malli, joka teki niin tässä vertailukokeessa. Nämä tulokset eivät tarkoita, että o1 olisi kaikissa suhteissa tohtorikoulutettavaa kyvykkäämpi vaan ainoastaan, että malli on kyvykkäämpi ratkaisemaan joitakin ongelmia, jotka tohtorikoulutettavan odotetaan ratkaisevan. Useissa muissa koneoppimisen vertailuarvoissa o1 parani huipputeknologiaan verrattuna. Näön havaitsemisominaisuuksiensa ansiosta o1 sai MMMU-testissä 78,2 % pisteistä, mikä tekee siitä ensimmäisen mallin, joka on kilpailukykyinen ihmisasiantuntijoiden kanssa. Se suoriutui myös GPT‑4o:ta paremmin 54:ssä 57 MMLU-alaluokassa.
Samalla tavalla kuin ihminen saattaa ajatella pitkään ennen kuin vastaa vaikeaan kysymykseen, o1 käyttää ajatusketjua yrittäessään ratkaista ongelmaa. Vahvistusoppimisen avulla o1 oppii hiomaan ajatusketjuaan ja tarkentamaan käyttämiään strategioita. Se oppii tunnistamaan ja korjaamaan virheensä. Se oppii jakamaan hankalat vaiheet yksinkertaisemmiksi. Se oppii kokeilemaan erilaista lähestymistapaa, kun nykyinen ei toimi. Tämä prosessi parantaa merkittävästi mallin kykyä päätellä. Havainnollistaaksemme tätä edistysaskelta esittelemme alla o1‑preview'n ajatusketjun useiden vaikeiden ongelmien osalta.
Koulutimme mallin, joka sai 213 pistettä ja sijoittui 49. persentiiliin vuoden 2024 kansainvälisissä informatiikan olympialaisissa (IOI). Se aloitettiin alusta o1:stä ja koulutettiin ohjelmointitaitojen parantamiseksi. Tämä malli kilpaili vuoden 2024 IOI:ssa samoissa olosuhteissa kuin ihmiskilpailijat. Sillä oli kymmenen tuntia aikaa ratkaista kuusi haastavaa algoritmiongelmaa, ja kuhunkin tehtävään sallittiin 50 vastausta.
Jokaista ongelmaa varten järjestelmämme valitsi useita ehdokaslähetyksiä ja lähetti niistä 50 testiajan valintastrategian perusteella. Lähetykset valittiin IOI:n julkisissa testitapauksissa, mallin luomissa testitapauksissa ja opitussa pisteytysfunktiossa saavutettujen tulosten perusteella. Jos olisimme sen sijaan lähettäneet vastauksemme satunnaisesti, olisimme saaneet keskimäärin vain 156 pistettä, mikä viittaa siihen, että tämä strategia oli kilpailun rajoissa lähes 60 pisteen arvoinen.
Vapaamman lähetysrajoituksen avulla havaitsimme mallin suorituskyvyn parantuneen merkittävästi. Kun tehtävää kohden sallittiin 10 000 vastausta, malli saavutti 362,14 pistemäärän ylittäen kultamitalin rajan, jopa ilman testiaikaista valintastrategiaa.
Lopuksi simuloimme Codeforcesin isännöimiä kilpailullisia ohjelmointikilpailuja osoittaaksemme tämän mallin koodaustaidot. Arvioimme tarkasti kilpailun sääntöjä ja mahdollistimme 10 ehdotuksen lähettämisen. GPT‑4o saavutti Elo-luokituksen3 808, joka on ihmiskilpailijoiden 11. persentiilissä. Tämä malli ylitti reilusti sekä GPT‑4o:n että o1:n saavuttaen Elo-luokituksen 1807, mikä on parempi suoritus kuin 93 % kilpailijoista.

Ohjelmointikilpailujen jatkohienosäätö parantaa o1:tä. Parannettu malli sijoittui kilpailusääntöjen mukaan 49. persentiiliin vuoden 2024 kansainvälisissä informatiikan olympialaisissa.
Testien ja akateemisten vertailuarvojen lisäksi arvioimme myös ihmisten mieltymystä o1‑preview'hin verrattuna GPT‑4o:hon haastavissa, avoimissa tehtävissä laajalla kirjolla osa-alueita. Tässä arvioinnissa ihmiskouluttajille näytettiin anonymisoituja vastauksia o1‑preview'n ja GPT‑4o:n kysymyksiin, ja he äänestivät haluamaansa vastausta. o1‑preview sai suuren enemmistön gpt-4o:hon verrattuna päättelypainotteisissa kategorioissa, kuten data-analyysissä, koodauksessa ja matematiikassa. o1‑preview'ta ei kuitenkaan suositella joissakin luonnollisen kielen tehtävissä, mikä viittaa siihen, ettei se sovi hyvin kaikkiin käyttötapauksiin.

Ajatusketjupäättely tarjoaa uusia mahdollisuuksia yhdenmukaisuuteen ja turvallisuuteen. Havaitsimme, että mallikäyttäytymistä koskevien käytäntöjemme integrointi päättelymallin ajatusketjuun on tehokas tapa opettaa vankasti inhimillisiä arvoja ja periaatteita. Opettamalla mallille turvallisuussääntömme ja niiden analysoinnin kontekstissa, havaitsimme todisteita siitä, että päättelykyky hyödytti suoraan mallin luotettavuutta: o1‑preview osoitti huomattavaa parannusta keskeisissä suojauksen murtoarvioinneissa ja vaikeimmissa sisäisissä vertailuarvoissamme mallimme turvallisuuskieltorajojen arvioinnissa. Uskomme, että ajatusketjun käyttö tarjoaa merkittäviä edistysaskeleita turvallisuuden ja yhdenmukaisuuden parantamisessa, koska (1) se mahdollistaa mallin ajattelun havainnoinnin selkeällä tavalla ja (2) mallin turvallisuussääntöjä koskeva päättely on vankempaa jakelun ulkopuolisissa skenaarioissa.
Parannustemme stressitestaamiseksi suoritimme ennen käyttöönottoa sarjan turvallisuustestejä ja maaliosastotestausta valmiusviitekehyksemme(avautuu uudessa ikkunassa) mukaisesti. Havaitsimme, että ajatusketjupäättely edisti kyvykkyyksien paranemista kaikissa arvioinneissamme. Erityisen huomionarvoista on, että havaitsimme mielenkiintoisia esimerkkejä palkkioiden hakkeroinnista(avautuu uudessa ikkunassa). Näiden arviointien yksityiskohtaiset tulokset löytyvät liitteenä olevasta järjestelmäkortista.
| Metrinen | GPT-4o | o1-preview |
|---|---|---|
| % Safe completions on harmful prompts Vakio | 0,990 | 0,995 |
| % Safe completions on harmful prompts Challenging: jailbreaks & edge cases | 0,714 | 0,934 |
| ↳ Häirintä (vakava) | 0,845 | 0,900 |
| ↳ Hyväksikäyttävä seksuaalinen sisältö | 0,483 | 0,949 |
| ↳ Seksuaalista sisältöä, johon liittyy alaikäisiä | 0,707 | 0,931 |
| ↳ Neuvoja väkivallattomasta väärinkäytöksestä | 0,688 | 0,961 |
| ↳ Neuvoja väkivaltaisesta väärinkäytöksestä | 0,778 | 0,963 |
| % Safe completions for top 200 with highest Moderation API scores per category in WildChat Zhao, et al. 2024 | 0,945 | 0,971 |
| Goodness@0.1 StrongREJECT jailbreak eval Souly et al. 2024 | 0,220 | 0,840 |
| Ihmisten tuottamat jailbreak-arvioinnit | 0,770 | 0,960 |
| % Compliance on internal benign edge cases “ei ylikieltäytyminen” | 0,910 | 0,930 |
| % Compliance on benign edge cases in XSTest “ei ylikieltäytyminen” Röttger, et al. 2023 | 0,924 | 0,976 |
Uskomme, että piilotettu ajatusketju tarjoaa ainutlaatuisen mahdollisuuden mallien seurantaan. Olettaen, että se on uskottava ja luettava, piilotettu ajatusketju antaa meille mahdollisuuden ikään kuin lukea mallin mieltä ja ymmärtää sen ajatusprosessia. Esimerkiksi tulevaisuudessa saatamme haluta seurata ajatusketjua siltä varalta, että käyttäjän manipuloinnista on merkkejä. Jotta tämä toimisi, mallilla on kuitenkin oltava vapaus ilmaista ajatuksiaan muuttumattomassa muodossa, joten emme voi kouluttaa ajatusketjuun mitään käytäntöjen noudattamista tai käyttäjien mieltymyksiä. Emme myöskään halua tehdä epäjohdonmukaisesta ajatusketjusta suoraan näkyvää käyttäjille.
Siksi, punnittuamme useita tekijöitä, kuten käyttäjäkokemusta, kilpailuetua ja mahdollisuutta seurata ajatusketjua, olemme päättäneet olla näyttämättä raakoja ajatusketjuja käyttäjille. Myönnämme, että tällä päätöksellä on haittoja. Pyrimme osittain korvaamaan sen opettamalla mallille mahdollisuuden toistaa kaikki hyödylliset ideat vastauksen ajatusketjusta. o1‑mallisarjalle esittelemme mallin luoman yhteenvedon ajatusketjusta.
o1 edistää merkittävästi tekoälypäättelyn huippua. Aiomme julkaista paranneltuja versioita tästä mallista jatkaessamme iterointia. Odotamme näiden uusien päättelykykyjen parantavan kykyämme sovittaa mallit yhteen inhimillisten arvojen ja periaatteiden kanssa. Uskomme, että o1 – ja sen seuraajat – avaavat tekoälylle monia uusia käyttötapauksia tieteessä, koodauksessa, matematiikassa ja niihin liittyvillä aloilla. Odotamme innolla, että käyttäjät ja API-kehittäjät pääsevät huomaamaan, miten se voi parantaa heidän päivittäistä työtään.
| Tietojoukko | Metrinen | gpt-4o | o1-preview | o1 |
|---|---|---|---|---|
| Kilpailumatematiikka AIME (2024) | cons@64 | 13,4 | 56,7 | 83,3 |
| pass@1 | 9,3 | 44,6 | 74,4 | |
| Kilpailukoodi CodeForces | Elo | 808 | 1 258 | 1 673 |
| Prosenttiosuus | 11,0 | 62,0 | 89,0 | |
| GPQA-diamond | cons@64 | 56,1 | 78,3 | 78,0 |
| pass@1 | 50,6 | 73,3 | 77,3 | |
| Biologia | cons@64 | 63,2 | 73,7 | 68,4 |
| pass@1 | 61,6 | 65,9 | 69,2 | |
| Kemia | cons@64 | 43,0 | 60,2 | 65,6 |
| pass@1 | 40,2 | 59,9 | 64,7 | |
| Fysiikka | cons@64 | 68,6 | 89,5 | 94,2 |
| pass@1 | 59,5 | 89,4 | 92,8 | |
| MATEMATIIKKA | pass@1 | 60,3 | 85,5 | 94,8 |
| MMLU | pass@1 | 88,0 | 92,3 | 90,8 |
| MMMU (val) | pass@1 | 69,1 | n/a | 78,2 |
| MathVista (testmini) | pass@1 | 63,8 | n/a | 73,9 |
Tekijät
Sitaatit
- 1
- 2
Arvioinneissamme käytettiin samaa 500 ongelman testijakoa kuin https://arxiv.org/abs/2305.20050(avautuu uudessa ikkunassa)
- 3