Terminal X matcher erfarne investorers skøn 88,6 % med GPT‑6.1
Terminal X's Eval Agent bedømmer output ud fra 54 kriterier og opdager 25 % flere afvigelser fra en fonds mandat med GPT‑6.1 Sol.
25 %
Flere agentsvar uden for fondens mandat opdages med GPT‑6.1 Sol end med den næstbedste model
2,4 mio. $
Besparelser omregnet til årsbasis for én kunde på due diligence og investeringsarbejdsgange
+220 basispoint
Større enighed mellem agenter og menneskelige bedømmere med GPT‑6.1 Sol end med den næstbedste model
30 %
Lavere omkostning pr. forespørgsel med GPT‑6.1 Sol end med den næstbedste model
Et investeringsselskabs konkurrencefordel opbygges handel for handel, men dømmekraften bag hver beslutning findes som regel kun i hovedet på nogle få erfarne investorer. Når de forlader selskabet, pådrager det sig det, Terminal X(åbner i et nyt vindue) kalder hukommelsesgæld: Selskabet beholder måske dokumenterne, men mister ræsonneringen.
Terminal X's Capital Memory-operativsystem er udviklet til at nedbringe den gæld. Virksomhedens ingeniører arbejder ude hos kunderne og har en fortid som finans- og investeringsspecialister hos JPMorgan og Blackstone. Sammen med kundernes investeringsteams designer de selskabets agentarkitektur og indkoder dets investeringstilgang i agenter, som selskabet selv ejer og kører lokalt eller i sin egen cloud.
OpenAI-modeller, herunder GPT‑6.1 Sol og GPT‑6 Luna, står for ræsonneringen i disse agenter. Og Terminal X's Eval Agent bedømmer agenternes output ud fra selskabets standarder. GPT‑6.1 Sol hjalp Eval Agent med at opdage cirka 25 % flere anbefalinger, der afveg fra en fonds mandat, og kørte de samme arbejdsgange med cirka 30 % lavere omkostning pr. forespørgsel end den næstbedste model.
»GPT-6.1 Sols ræsonnering over lang kontekst og effektive tokenforbrug gør det muligt for os at bygge mere dybdegående evalueringsprocesser. Det hjælper vores Eval Agents med at gøre investeringsmæssig dømmekraft målbar og efterprøvbar.«
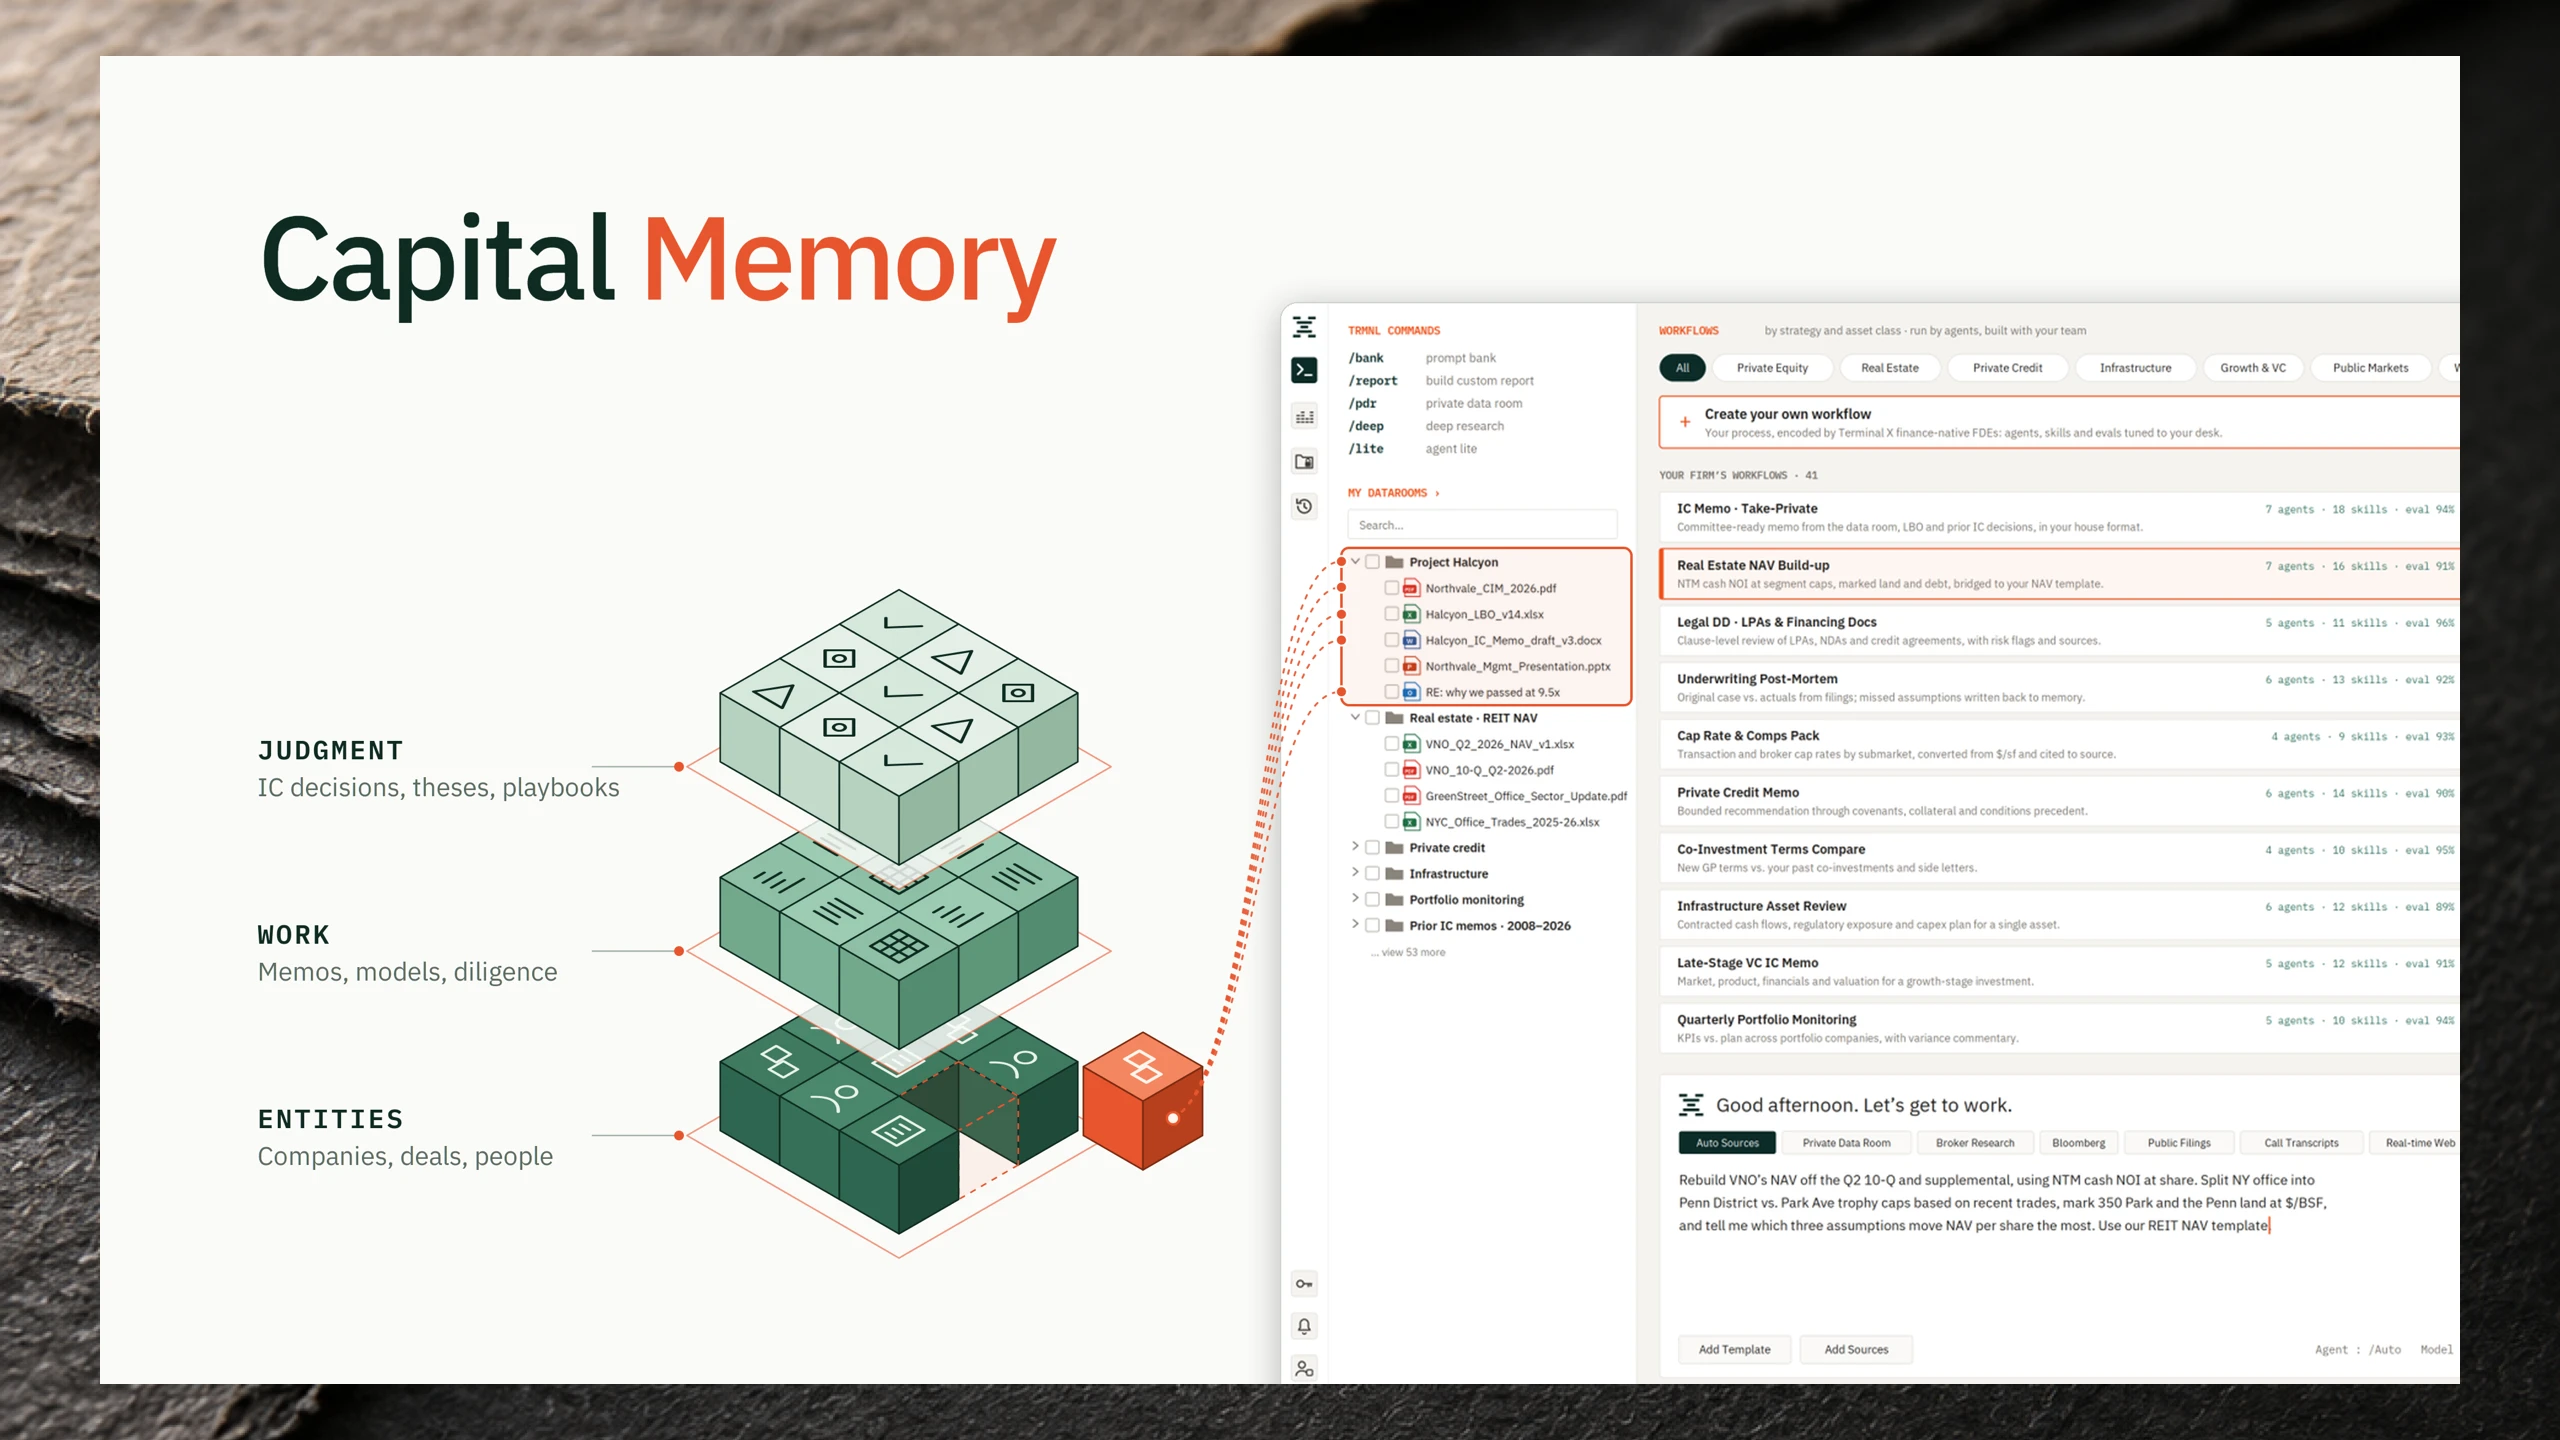
Til hver kunde bygger Terminal X agenter, der er udviklet til at investere, som selskabets bedste investorer gør. Terminal X's ingeniører tilbringer flere uger hos kunden, hvor de udleder arbejdsmetoderne bag selskabets betroede investeringsnotater og kortlægger processer, der aldrig er blevet skrevet ned. Det kan være, hvordan kreditteamet screener en låntager, eller hvilke kilder teamet for medinvesteringer indhenter, før det skriver et notat.
Derefter indkodes processerne i hundredvis af agenter, som tilpasses aktivklasse og strategi, med underagenter til hver fase af investeringen. GPT‑6.1 Sol håndterer de faser, der kræver dømmekraft og et meget stort kontekstvindue: at samle investeringstesen, identificere centrale hensyn og vurdere, om investeringen passer til selskabets mandat. GPT‑6 Luna håndterer de mange gentagne trin, hvor effektivt tokenforbrug er vigtigere end dybde.
Agenterne arbejder i hvert selskabs private datarum, et dedikeret miljø, hvor virksomheder kan dele og administrere følsomme investeringsdata. Agenterne behandler dokumenter på engelsk, koreansk, japansk og kinesisk og gemmer det, de lærer, som en selskabsspecifik Memory-post: en versionsstyret registrering af, hvordan ét team træffer én slags beslutning, herunder tidligere analyser, komitébeslutninger, instruktioner til arbejdsgange og selskabets investeringssyn.
Ingeniørerne omsætter hver Memory-post til en gentagelig arbejdsgang på Terminal X's platform. Her kan hver forespørgsel i drift efterprøves med fuld sporbarhed: de udførte trin, de hentede kilder, den anvendte model og ræsonneringen.
Ifølge Terminal X giver denne tilgang kunderne betydelige besparelser. En kapitalfond rapporterede for eksempel besparelser svarende til 2,4 millioner dollar om året ved at automatisere arbejdsgange for due diligence og investeringsnotater.
Terminal X byggede en Eval Agent til at kontrollere agenternes svar ud fra selskabets egen standard. Det er en orkestreret arbejdsgang baseret på GPT‑6.1 Sol og andre OpenAI-modeller, som er udviklet til at læse hvert agentoutput, som en VP læser en analytikers arbejde.
Eval Agent kontrollerer hvert output ud fra et bedømmelsesskema med 54 kriterier. Den spørger: Er tallene, sammenligningsgrundlaget, konsensusestimaterne og citaterne hentet fra de rigtige kilder? Hænger argumentationen sammen? Er anbefalingen i tråd med selskabets investeringssyn?
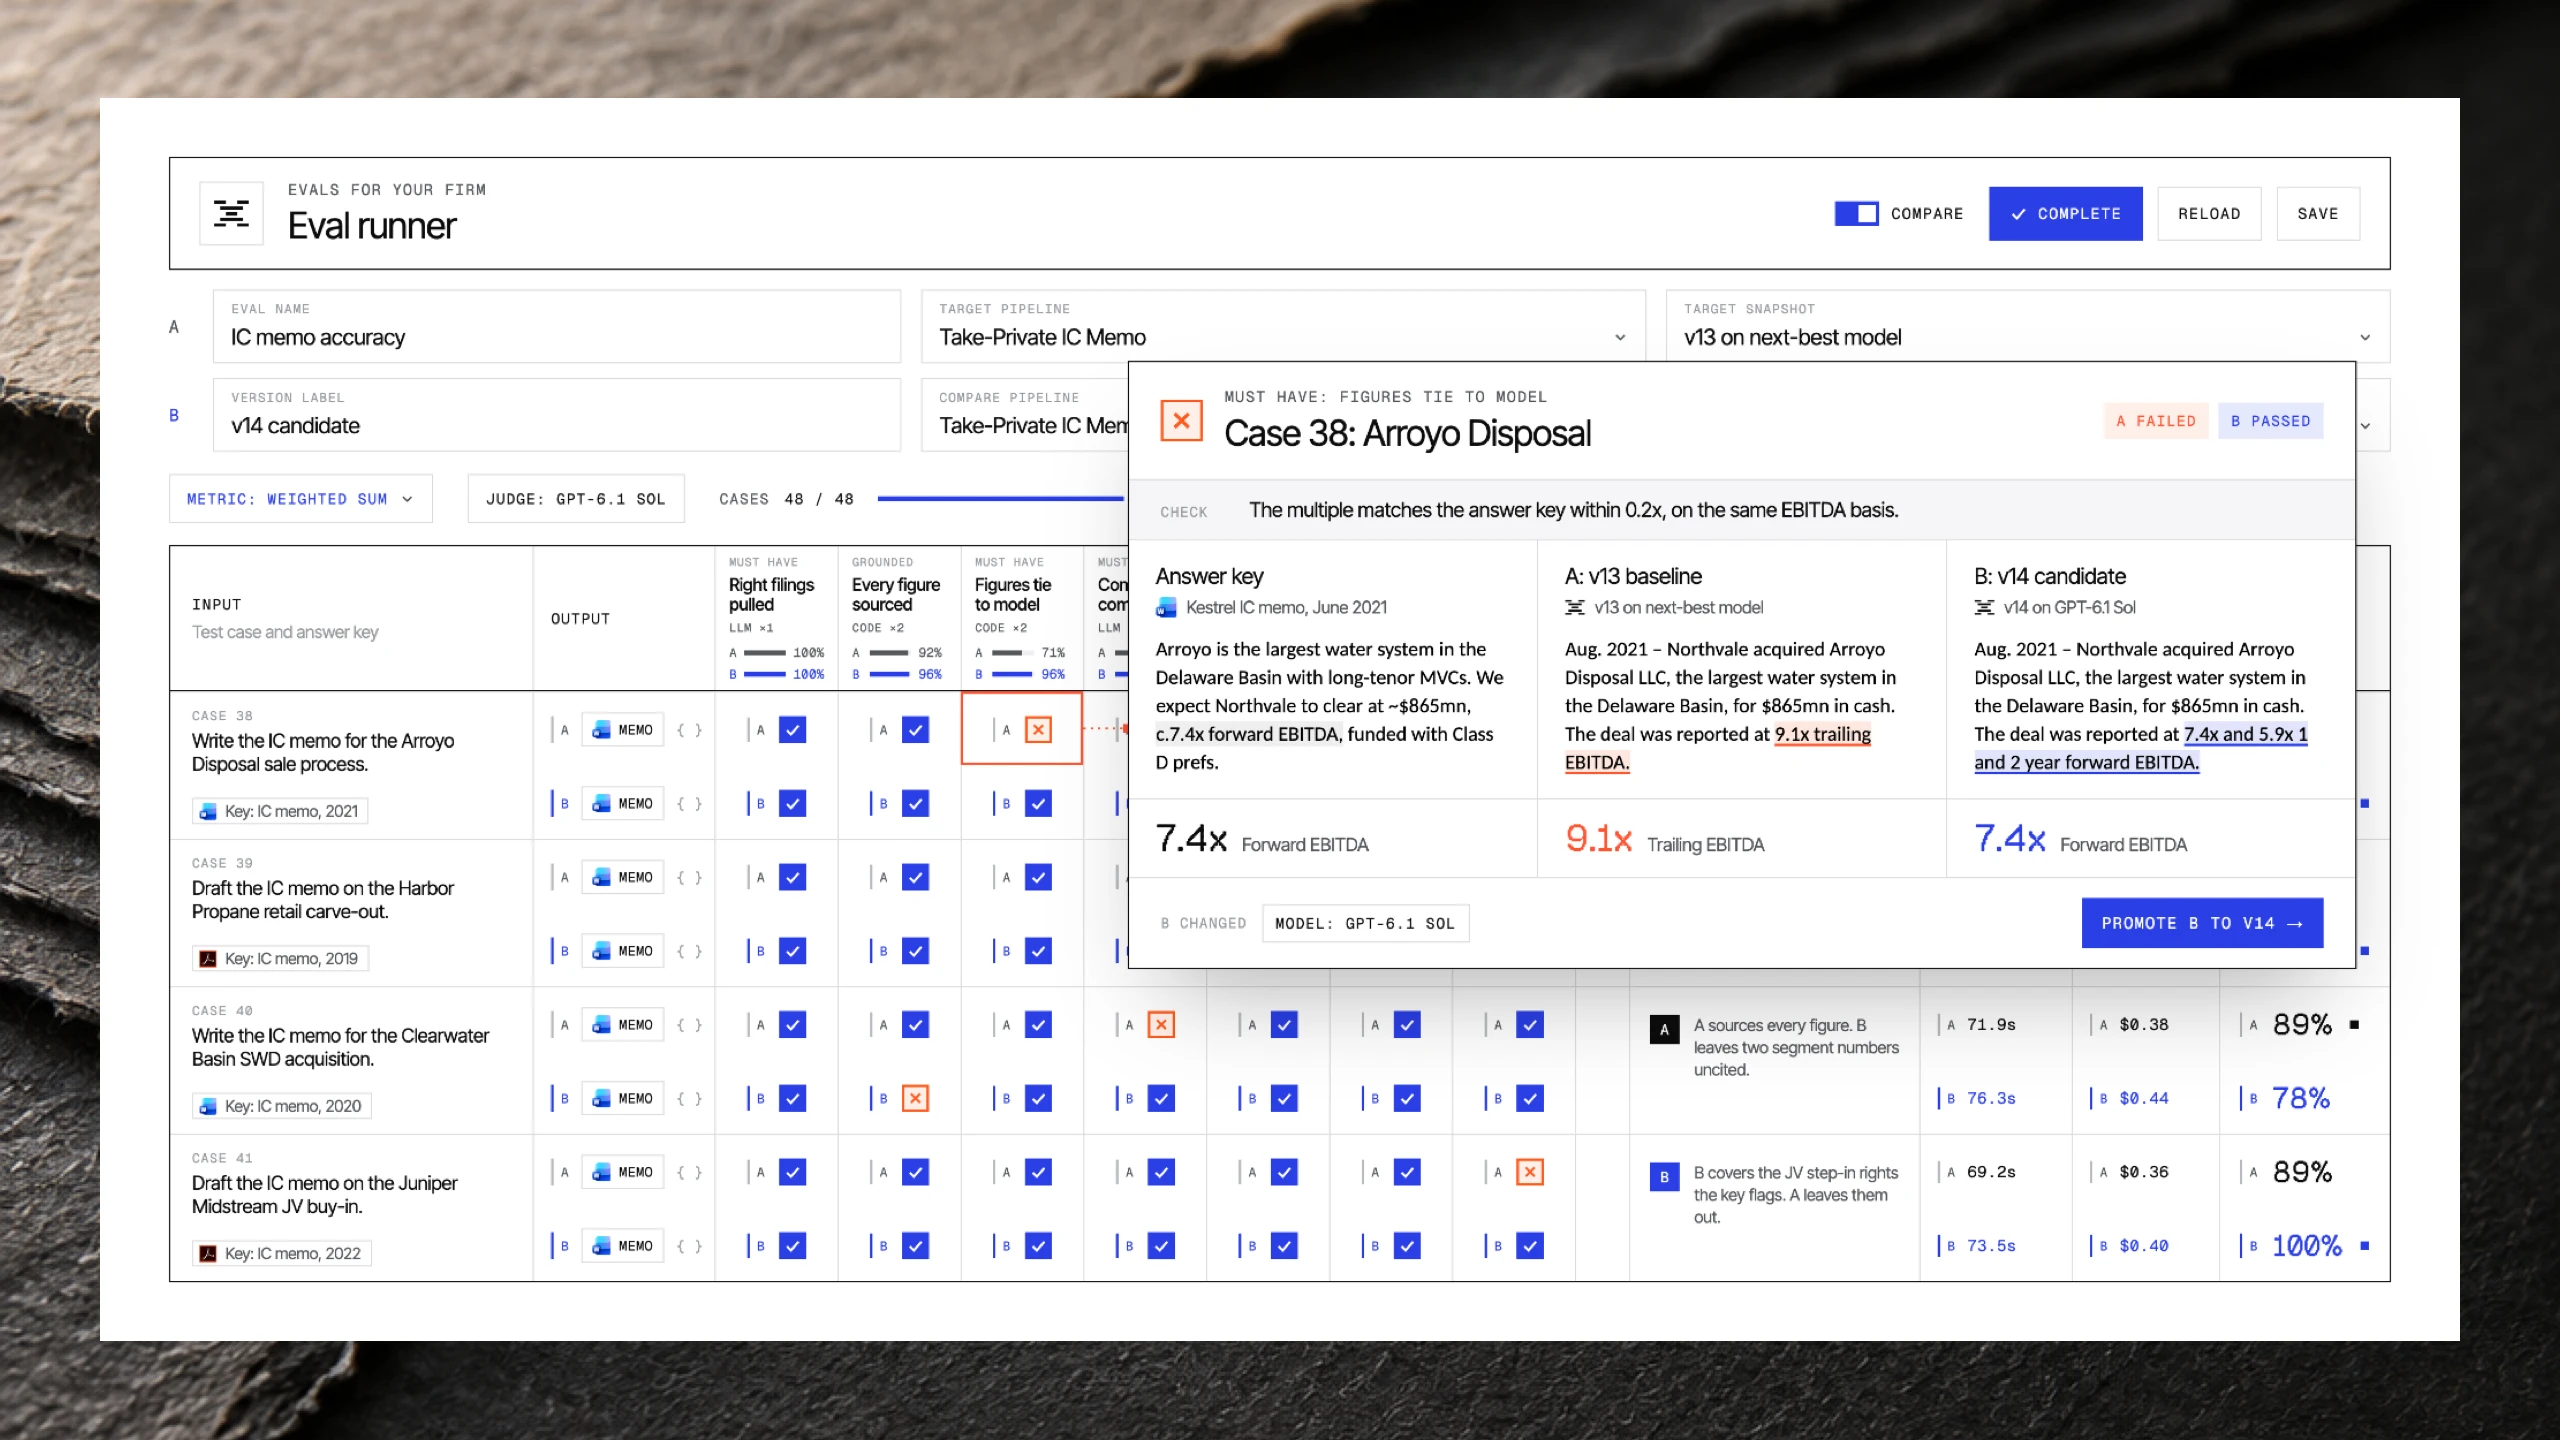
Hver kontrol giver resultatet bestået eller ikke bestået. Hver fejl ledsages af en begrundelse på én linje og en bedre kilde eller en rettet tekst og gemmes som en Memory-post. For eksempel bliver en overset kilde, et forkert sammenligningsselskab eller en investeringstese, der afviger fra selskabets investeringssyn, indkodet som en ny instruktion i arbejdsgangen eller en ny testcase for det pågældende team.
»Hvert svar bliver evalueret, og hver rettelse fra analytikeren lærer systemet lidt mere om, hvordan selskabet arbejder,« siger Ken Lee, medstifter og teknologidirektør i Terminal X. »Så jo længere et selskab bruger det, desto mere tænker det som selskabets eget team.«
Terminal X vælger modeller ud fra sine egne evalueringsresultater. I 500 bedømte vurderinger var virksomhedens Eval Agent med GPT‑6.1 Sol enig med den erfarne menneskelige bedømmer i 88,6 % af tilfældene mod 86,4 % for den næstbedste model – en forbedring på 220 basispoint.
Én fejltype, som GPT‑6.1 Sol var bedre til at opdage, var afvigelser fra investeringsstilen. En opkøbsfond har for eksempel mandat til at finde kandidater til opkøb og afnotering, der handles under den indre værdi (NAV), vurdere deres forretningsgrundlag og strukturere finansieringen. Når scenariemodeller peger på en vending i markedet, begynder anbefalingerne i stedet at gå på investeringer i nødlidende gæld eller redningsfinansiering. Eval Agent med GPT‑6.1 Sol opdagede cirka 25 % flere af disse afvigelser end den næstbedste model.
Det effektive tokenforbrug i GPT‑6.1 Sol ved arbejde med lang kontekst gjorde det muligt for Terminal X at bygge en mere dybdegående kontrolproces inden for samme budget. Investeringstesen afprøves først mod fondens mandat og derefter mod dens seneste handler. Usikre vurderinger køres igen, og agenten afstemmer resultaterne, før den rapporterer dem.
Den mere dybdegående kontrol markerede handler, som en sammenlignelig model havde godkendt efter en enkelt gennemgang. GPT‑6.1 Sol kørte også de samme arbejdsgange med cirka 30 % lavere omkostning pr. forespørgsel end den næstbedste model og med omtrent samme hastighed.
Med GPT‑6.1 Sol og GPT‑6 Luna har Terminal X oprettet 1.700 selskabsspecifikke Memory-poster, kørt over 1 million tilpassede arbejdsgange og nået et antal ugentligt aktive brugere, der svarer til 81 % af de månedligt aktive brugere.
Terminal X's næste skridt er at udvide selskabernes Memory-poster fra teams til enkeltpersoner, så den enkelte investeringsspecialists standard bliver registreret, som den praktiseres – ikke kun som den beskrives.
For Hyun, medstifter og administrerende direktør i Terminal X, er det netop pointen: »De selskaber, der vinder i det næste årti, vil eje deres dømmekraft som data. Vores opgave er at gøre den dømmekraft målbar, så den kan bevares, forbedres og genbruges.«