Amplitude forbedrer produkter på 1–2 dage med OpenAI
Amplitudes proaktive produktagent Wave bygger primært på OpenAI-modeller. Den identificerer, hvad der skal udvikles, hjælper teams med at lancere ændringer med kodeagenter og måler effekten.
160 %
Stigning i interaktion med agenten i forhold til kontrolgruppen efter én dag
1–2 dage
Anslået tid til at lancere en produktforbedring med Wave
51 %
Lavere gennemsnitlig modelomkostning pr. opgavekørsel for GPT‑6.1 Sol i Amplitudes evaluering af Data Science Agent.
1,34 USD
Modelomkostning for GPT‑6.1 Sol i Amplitudes evaluering af Opportunity Investigator.
Amplitude har altid hjulpet teams med at forstå, hvordan folk rent faktisk bruger deres produkter. Virksomhedens proaktive produktagent Wave hjælper teams med at omsætte denne indsigt til forbedringer, der når ud til brugerne. Ifølge Amplitude er Wave cirka 80 % drevet af OpenAI-modeller, herunder GPT‑6.1 Sol, GPT‑6 Luna og GPT‑Image‑2.5 Flare. Wave omsætter produktindsigt til implementeringsplaner, som teams kan sende til kodeagenter, herunder Codex, og måler derefter effekten.
Amplitude anslår, at Wave kan hjælpe teams med at lancere produktforbedringer på 1–2 dage i stedet for cirka en måned. På Amplitudes egen startside hjalp Wave med at gøre forslagskort mere personlige, hvilket øgede antallet af beskeder sendt via kortene med 160 %.
»AI kan nu finde nyttige opgaver, som vi aldrig havde tænkt på at give den. OpenAI's modeller kan undersøge et problem, skrive og køre kode og bruge resultaterne til at afgøre, hvad de skal prøve som det næste.«
Wave er Amplitudes proaktive produktagent. Teams giver den et produktområde og angiver de mål og målepunkter, de vil forbedre. Wave samler data fra Amplitude, sessionsoptagelser, kundefeedback og kode for at identificere og prioritere forbedringsmuligheder, udvikle løsninger og koordinere implementeringen med mennesker og kodeagenter. Derefter følger den resultaterne og bruger erfaringerne til at kvalificere den næste runde af forbedringer.
Bag denne arbejdsgang bruger Amplitude forskellige OpenAI-modeller til forskellige opgaver. GPT‑6.1 Sol understøtter styringen af forbedringsmuligheder og dybdegående undersøgelser af kode og data. GPT‑6 Luna håndterer hyppige opgaver med lavere omkostninger, såsom at gennemgå kode og udføre mindre evalueringstjek. GPT‑Image‑2.5 Flare genererer produktmockups med skærmbilleder fra sessionsoptagelser som visuelle referencer.
Når en forbedringsmulighed er klar til implementering, kan teams sende den direkte fra Wave til kodeagenter, herunder Codex, sammen med en teknisk plan og acceptkriterier, der sætter rammerne for arbejdet.
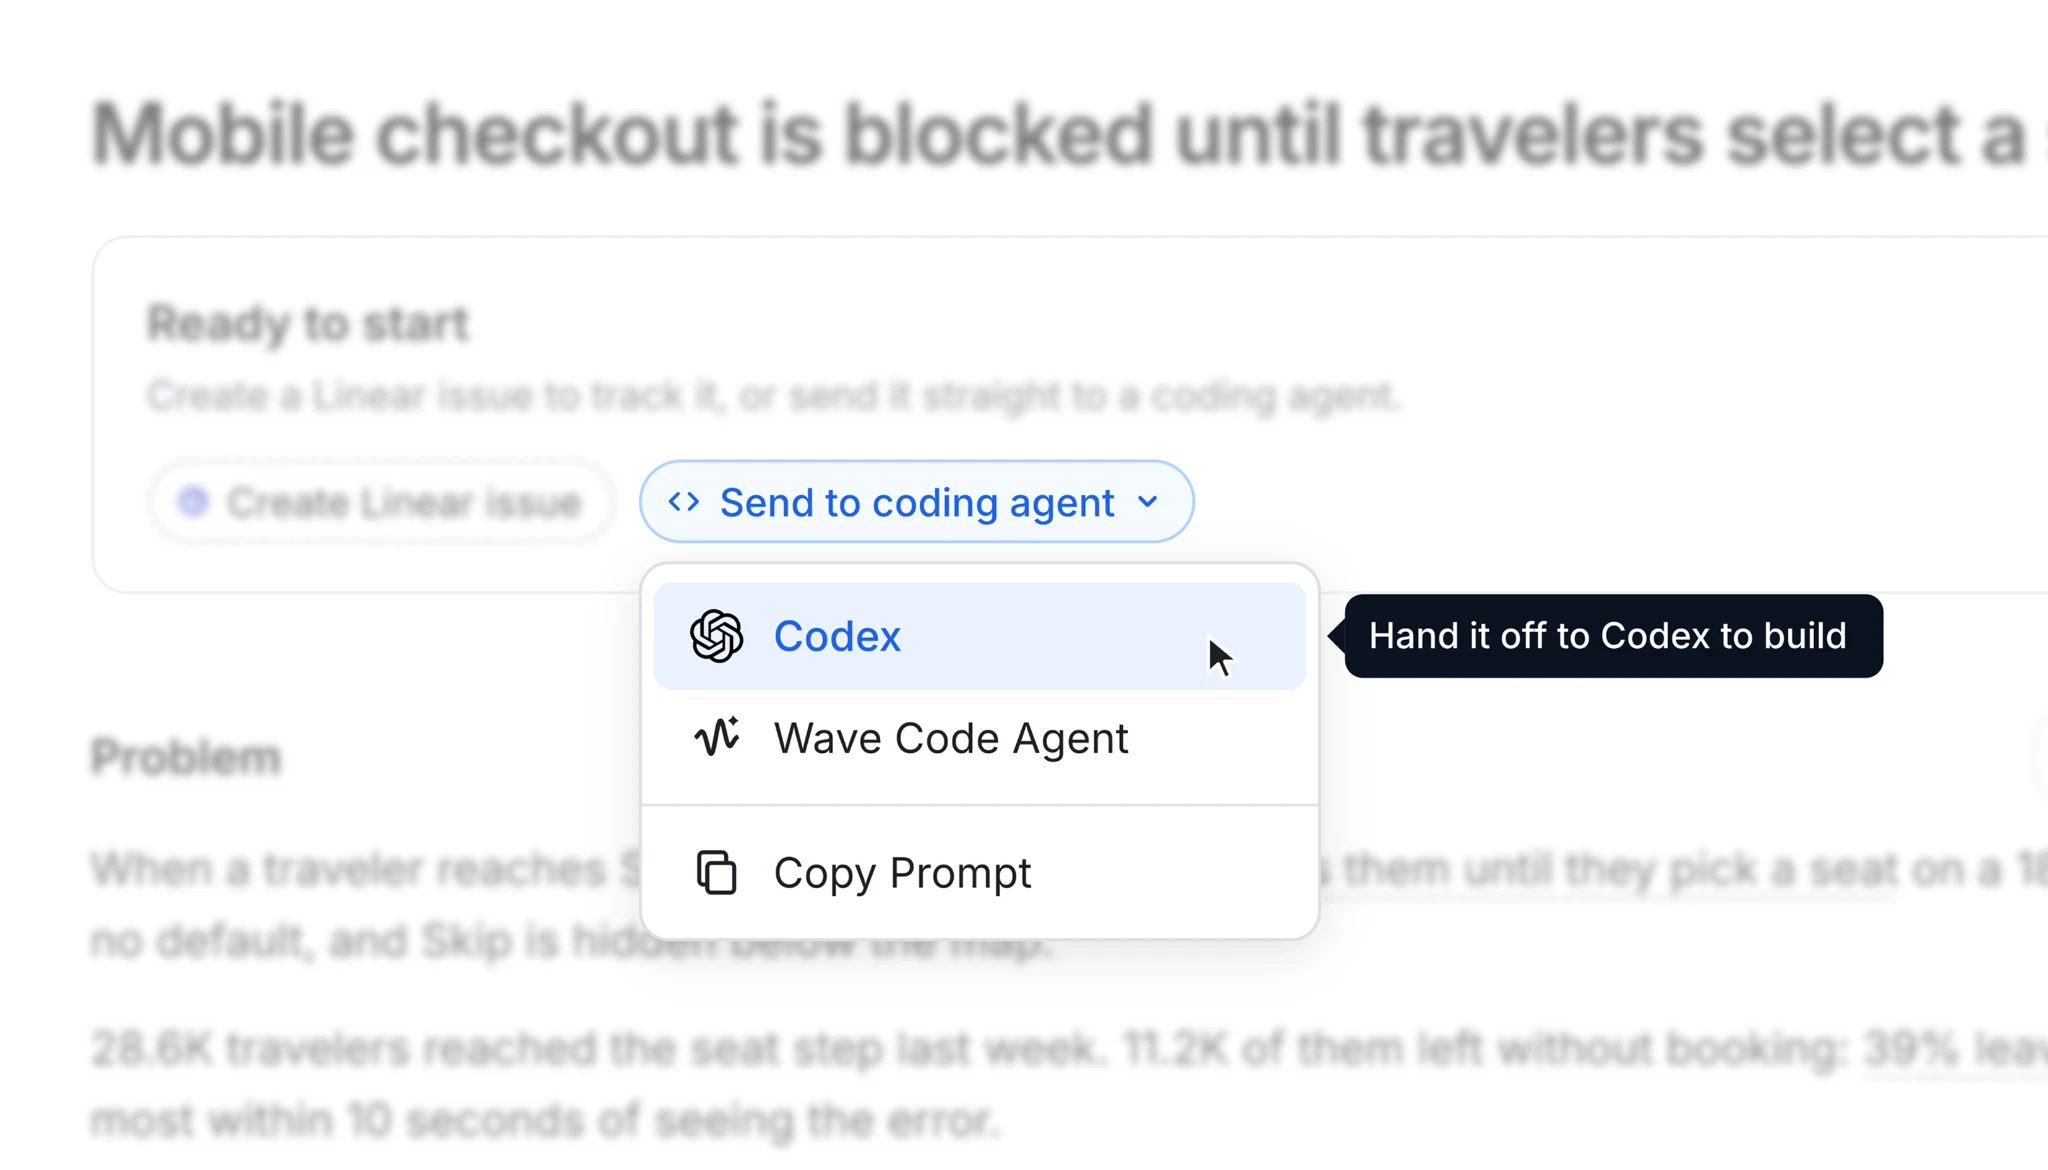
»Idéen med Wave er at have én samlet platform med agenter, der gennemgår enorme mængder sessionsoptagelser, analysedata og kode for at finde muligheder for at forbedre produkter,« forklarer Jacob Newman, ledende AI-produktchef hos Amplitude.
Amplitude testede Wave på sin egen startside, hvor generiske forslagskort skulle hjælpe brugerne med at starte en samtale med en AI-agent. Wave opdagede, at folk ofte sprang dem over: I en stikprøve på 100 sessionsoptagelser skrev 80 brugere deres egne spørgsmål, og kun 12 valgte et forslag.
Wave foreslog at gøre kortene personlige ud fra nyligt anvendte diagrammer, dashboards eller den side, brugeren kom fra. Den illustrerede ændringen og udarbejdede en teknisk plan, som blandt andet bevarede muligheden for at skrive frit og viste generiske forslag, når der ikke var tilstrækkelig kontekst til at tilpasse dem. Efter en kort gennemgang overlod teamet arbejdet til en kodeagent og A/B-testede ændringen.
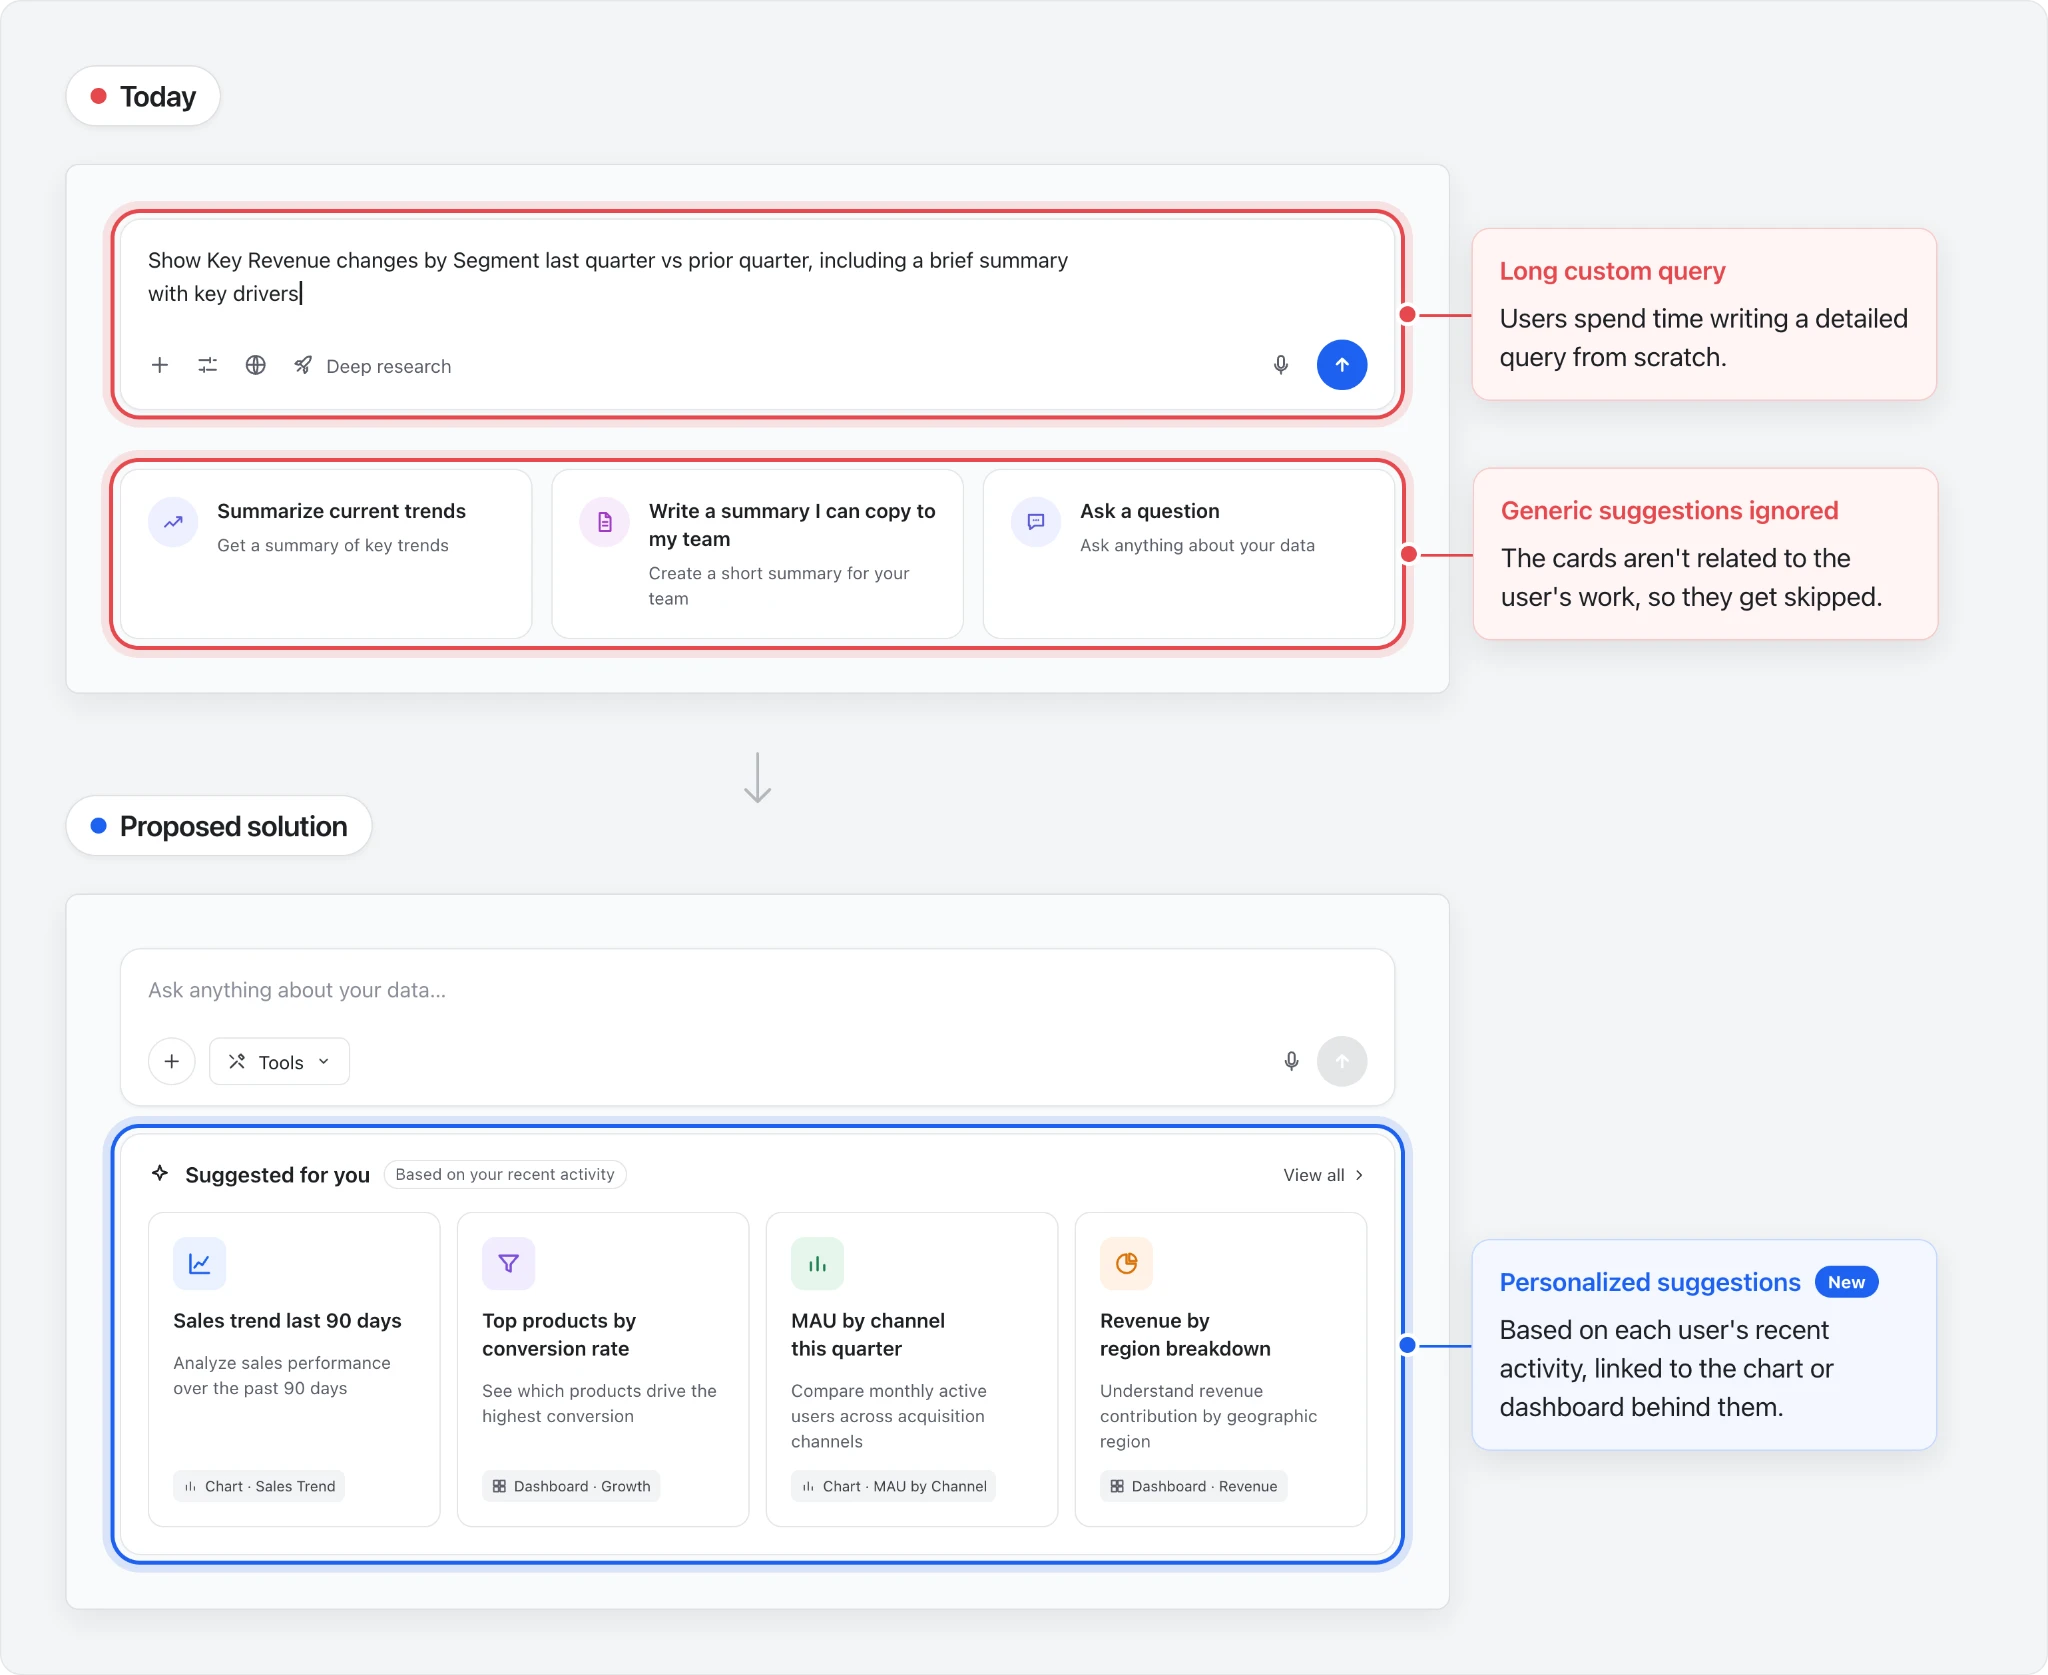
Ifølge de forsøgsresultater, Amplitude delte, steg antallet af beskeder sendt via startsidens forslagskort med 160 % i forhold til kontrolgruppen efter én dag. »Det er et godt eksempel på, hvordan ting, der ikke er banebrydende og derfor bare bliver overset, kan få flere til at bruge funktioner på uventede måder,« forklarer Eric Carlson, seniorledende AI-ingeniør hos Amplitude.
Waves opgaver stiller forskellige krav til modellerne. En dybdegående undersøgelse kræver stærk ræsonnering og velunderbyggede konklusioner. Et lille tjek, der gentages hundredvis af gange, skal være hurtigt og billigt. Amplitude evaluerer kvalitet, svartid og omkostninger for hver opgave og vælger modeller ud fra det.
»OpenAI gav os både stærke modeller til ræsonnering og mindre, hurtigere modeller, så vi kunne afveje kvalitet, svartid og inferensomkostninger på tværs af produktet«
Til Waves Opportunity Investigator evaluerede Amplitude, om modellerne underbyggede deres fund, undgik falske positiver, indarbejdede evaluatorens feedback, kom videre efter værktøjsfejl og holdt påstandene i overensstemmelse med evidensen. GPT‑6.1 Sol fik en samlet score på 4,06 ud af 5 mod 3,62, 3,52 og 2,94 for tre alternative modeller. Den lå i spidsen på alle fem undersøgelseskriterier og havde den korteste medianvarighed for undersøgelser på 54 minutter.
I en separat evaluering af Waves Data Science Agent fik GPT‑6.1 Sol 67,5 ud af 100 mod 69,3 for en anden førende model, med en gennemsnitlig modelomkostning på 1,28 USD mod 2,63 USD pr. opgavekørsel. GPT‑6.1 Sol scorede også højere på overholdelse af værktøjskontrakter, estimering og usikkerhed samt forankring i evidens.
Til opgaver, der udføres i stort omfang, såsom kodegennemgang og mindre evalueringstjek, bruger Amplitude GPT‑6 Luna for at holde svartider og omkostninger nede. Ved at fordele arbejdet mellem specialiserede agenter kan teamet reservere den dyrere ræsonnering til de opgaver, der har mest brug for den.
Til generering af wireframes og mockups fik OpenAI's model til billedgenerering 80,3 ud af 100 for wireframes af løsningen mod 63,9 for en anden model til billedgenerering. Amplitudes evaluering omfattede kommunikationskvalitet, overensstemmelse med produktet, overholdelse af instruktioner, læsbarhed af tekst og brugergrænseflade samt visuel sammenhæng på tværs af 15 forbedringsmuligheder.
Kunder på tværs af brancher bruger allerede Wave i beta til at identificere og lancere produktforbedringer. Wave analyserer sessions- og analysedata og udarbejder derefter anbefalinger med et løsningsforslag, en teknisk plan og acceptkriterier.
Derfra kan teams styre graden af automatisering. De fleste teams sender fejlrettelser direkte til kodeagenter, mens nye funktioner og større satsninger bliver gennemgået af et menneske.
For ændringer, der bliver lanceret, kan vejen fra opdagelse til udførelse være kort: Blandt kundelancerede eksperimenter, flag og vejledninger kom én ud af fire i drift samme dag, som Wave identificerede muligheden, halvdelen på under fire dage og to ud af tre inden for en uge.
Interpoleret ud fra de angivne milepæle; kurven er illustrativ og viser ikke enkeltobservationer.
»Vores ambition med OpenAI er, at virksomheder skal udvikle software som produkter, der forbedrer sig selv,« siger Skates. Efterhånden som OpenAI's modeller bliver bedre til ræsonnering og kodning, vil teams kunne uddelegere mere undersøgelses- og implementeringsarbejde til agenter, så bedre produkter i sidste ende når hurtigere ud til brugerne. Amplitude oplever det allerede: Agenter finder og hjælper med at levere forbedringer til virksomhedens eget produkt, mens teamet arbejder på andre prioriteter. »Jeg tror, teams vil blive overraskede over, hvor meget de kan nå, når deres software arbejder sammen med dem om at gøre produktet bedre.«