Jak Performance Factory od OpenAI udržuje rychlost ChatGPT
Náš systém využívající Codex automatizuje hledání a řešení problémů s výkonem.
Závratné tempo vývoje s využitím agentů způsobilo, že tradiční přístupy k optimalizaci výkonu už nejsou udržitelné. Abychom udrželi krok, vytvořili jsme Performance Factory, autonomní systém, který naplno využívá schopnosti nástroje Codex a našich modelů k hledání a opravování regresí nebývalou rychlostí. Performance Factory běží v cloudu, automatizuje analýzu a řešení problémů s výkonem a umožňuje nám držet krok s našimi ambiciózními plány.
Naši vývojáři v systému Performance Factory definují pracovní postupy pro opakované činnosti a píšou pokyny pro agenty Codex, kteří je provádějí. Například postup pro řešení regresí vytvoří úlohu, když se spustí upozornění na problém s výkonem. Agent prozkoumá zpomalení, zapíše zjištění do úlohy a navrhne opravu, kterou posoudí vývojář. Po nasazení opravy převezme tutéž úlohu další agent a ověří, zda se výkon vrátil na výchozí úroveň. Tento první pracovní postup v systému Performance Factory automatizoval celý proces řešení regresí: od analýzy přes vytvoření opravy až po ověření nápravy. Za něco málo přes tři měsíce postup pro řešení regresí zaznamenal více než 1 700 analýz a odhalil hlavní příčinu ve více než 600 případech. To je 17 automatizovaných analýz denně.
Ukážeme vám, jak se naše využívání nástroje Codex vyvinulo v dnešní Performance Factory, projdeme první spuštěný pracovní postup a podělíme se o první zkušenosti s tvorbou a provozem agentních postupů v produkci.
Jak jsme Codex zapojovali do stále větší části aktivit souvisejících s výkonem, všímali jsme si, že se mění způsob práce našeho týmu. Doufáme, že se z našich zkušeností mohou poučit i další týmy spravující služby, až budou zavádět agentní postupy v jiných oblastech.
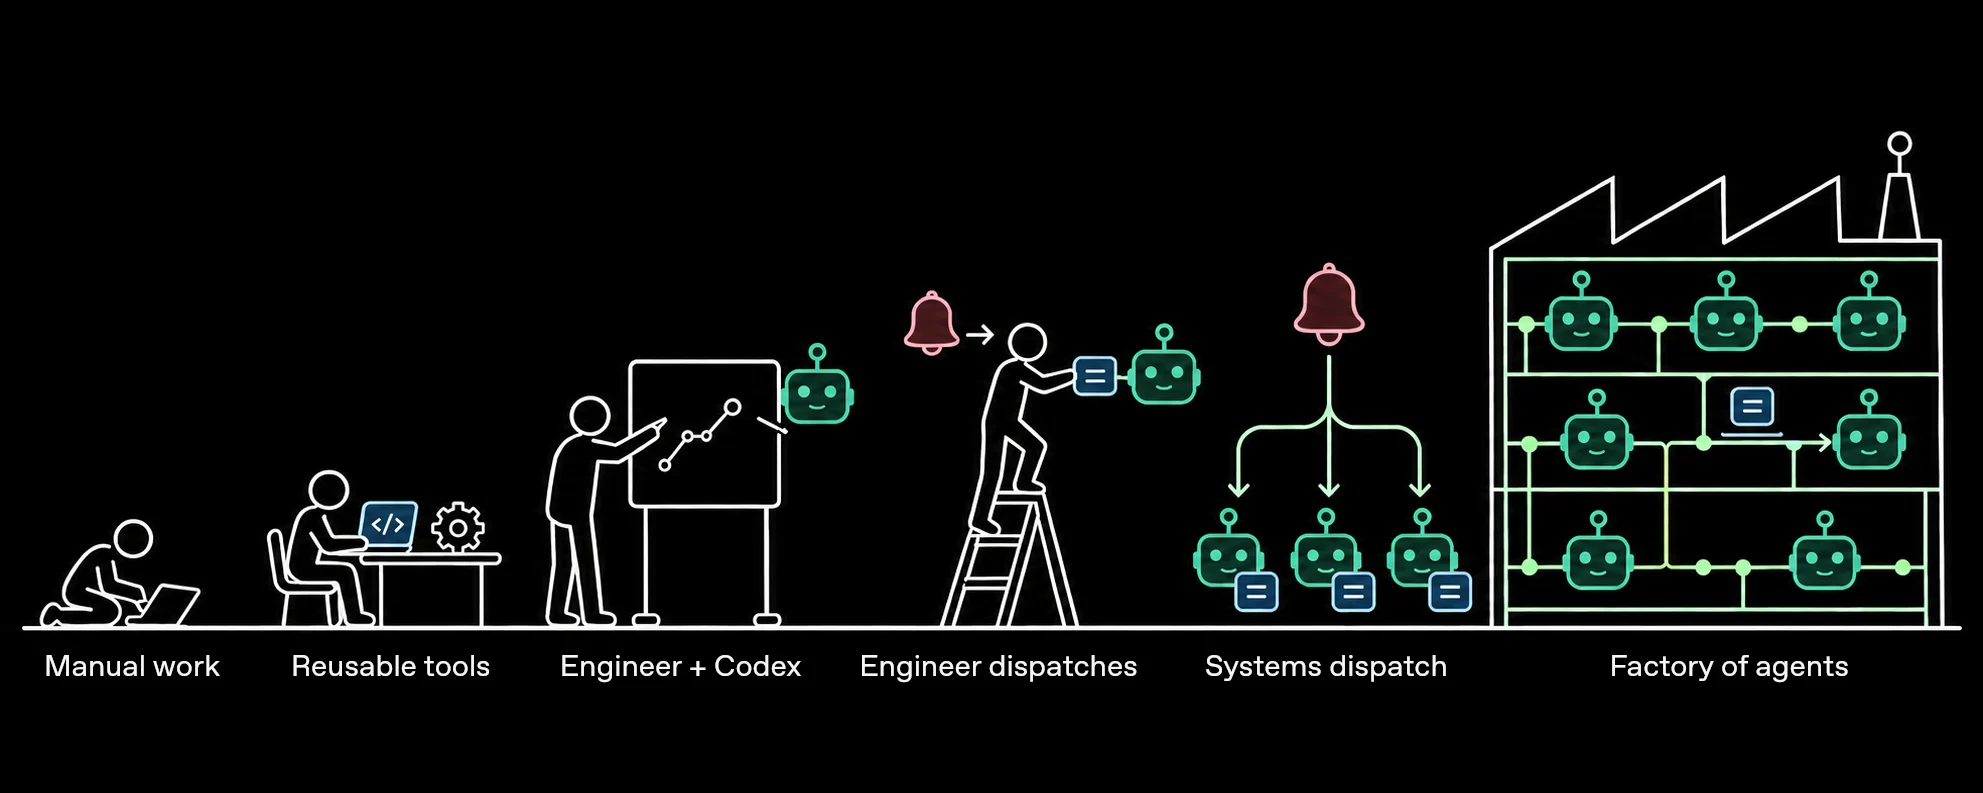
Práce na softwaru se vyvíjí od ruční práce přes spolupráci se stroji až k továrnám agentů.
1. Před použitím Codexu Před příchodem nástroje Codex vývojáři při zkoumání zpomalení ručně procházeli metriky a logy, porovnávali trasování, ladili běžící stroje a četli kód. Tato práce byla časově náročná a k určení, kde hledat, byla často potřeba hluboká znalost služby. Důležité informace se daly snadno přehlédnout. Když jsme se opakovaně setkávali se stejnými problémy, například s prodloužením latence prvního tokenu v ChatGPT, vytvořili jsme pokročilé nástroje, jako jsou profilery CPU a alokací paměti, které tyto analýzy usnadnily. Postupně jsme nashromáždili více než 30 nástrojů pro práci s výkonem.
2. Codex jako partner. Jakmile jsme získali Codex jako partnera, vývojáři se mohli zeptat: „Proč se to zpomalilo?“ a společně s ním hledat příčinu i v systému, který neznali. Codex dokázal prohledávat rozsáhlé báze programu, najít relevantní metriky a trasování, sledovat interakce mezi službami a vhodným profilováním zjistit, co se stalo. Vývojáři ale stále museli celý proces řídit: vědět, které nástroje pro práci s výkonem použít a jak analýzu vést. Složité problémy dokázalo řešit více lidí s menšími nároky na odbornost i čas.
3. Opakovaně použitelné dovednosti. Abychom automatizaci posunuli dál, zachytili jsme analytický postup našeho týmu pro výkon ve sdílené dovednosti nazvané perf-forensics. Ta Codexu říká, jaké nástroje má k dispozici, kdy je použít a jak při analýze zpomalení postupovat, aby se mohl pokusit problém vyřešit z několika úhlů:
Zjistit, kdy zpomalení začalo
Určit, které požadavky byly zasaženy
Prověřit, zda zpomalení mohou vysvětlit nasazení nebo změny konfigurace
Dovednost perf-forensics jsme testovali a zdokonalovali pomocí evaluací založených na dřívějších regresích. U typů regresí, na které jsme se zaměřili (například zvýšení latence a pokles dostupnosti ChatGPT), jsme nyní mohli Codexu předat upozornění a během jediného běhu získat diagnózu, aniž bychom ho museli vést krok za krokem.
4. Člověk jako prostředník. S přidáváním a zdokonalováním dovedností Codexu pro práci s výkonem, jako je perf-forensics, jsme si začali připadat jako pouhý prostředník mezi upozorněními a Codexem. Spustilo se upozornění, vývojář ho jednoduše zkopíroval do Codexu s příslušnou dovedností a pak vložil zjištění zpět do Slacku.
5. Automatizované analýzy. Poté jsme analýzy přesunuli do cloudu, aby upozornění mohlo automaticky spustit relaci Codexu. Codex prozkoumal zpomalení a zveřejnil zjištění ve vlákně na Slacku, ale touto odpovědí automatizace končila. vývojář musel i tak převzít diagnózu, vytvořit opravu a po nasazení ověřit, zda funguje. Jak upozornění přibývala, už jen zjištění, které regrese vyžadují pozornost, znamenalo procházet vlákna na Slacku.
6. Továrna. Performance Factory jsme vytvořili pro kompletní provádění agentních postupů v oblasti výkonnostního vývoje. Systém sleduje, co každá aktivní úloha potřebuje dál, a jakmile je další krok připraven, přidělí jí agenta. Každá úloha si uchovává stav a zjištění, takže si práci mohou předávat agenti a inženýři a navázat na ni po revizi kódu nebo nasazení. U regrese práce začíná analýzou upozornění a končí ověřením obnovení výkonu v produkci. Běžné optimalizace můžeme převést na pracovní postupy, které pravidelně běží napříč našimi službami. Postup, který objeví možnou optimalizaci, může v jiném postupu vytvořit úlohu pro její otestování a implementaci.
Performance Factory se skládá ze čtyř součástí: evidence úloh s konfigurovatelnými postupy, distribuční smyčky přidělující připravenou práci agentům, API spouštějícího Codex v cloudu a odběrů událostí, které probouzejí agenty při změně (například po přidání komentáře při revizi na GitHubu nebo dokončení nasazení).

Performance Factory tvoří služba pro správu úloh, distribuční smyčka, cloudové spouštění a odběry událostí.
Ve službě pro správu úloh vývojáři definují pracovní postupy přidáváním konfiguračních souborů a promptů v Markdownu, kterými se agenti řídí. Konfigurace uvádí stavy, kterými může úloha procházet, povolené přechody a kroky vyžadující zásah vývojáře. Samostatné prompty agentům říkají, co mají v jednotlivých krocích dělat.
Každá aktivita se stává úlohou v rámci určitého postupu a všechny postupy jsou viditelné v uživatelském rozhraní. Vývojáři vidí otevřené úlohy, mohou sledovat jejich průběh a sdílet je s kolegou, který může znát více souvislostí nebo pomoci s dalším krokem.
Distribuční smyčka pravidelně kontroluje, které úlohy jsou připravené na další krok. Každé úloze přidělí agenta tím, že spustí relaci Codexu s pokyny pro aktuální stav úlohy. Agent do úlohy zaznamenává svůj postup, a pokud krok dokončí, přesune ji do dalšího stavu.
Po přidělení úlohy potřebuje agent prostředí pro práci s přístupem ke stejným nástrojům, jaké by použil vývojář. Vytvořili jsme interní API pro programové spouštění relací Codexu v cloudu. Relace Codexu běží v prostředí uvnitř naší sítě s přístupem k repozitářům kódu a nástrojům pro sledování systémů, které používají naši vývojáři: metrikám, logům, trasováním, profilům CPU a snímkům paměti.
Agent běží pod identitou služby, takže můžeme omezit jeho oprávnění a rozpoznat, které akce provedli naši agenti pro optimalizaci výkonu. Přesun aktivit agentů do cloudu nám umožňuje spouštět úlohy souběžně, aniž bychom byli závislí na otevřených noteboocích vývojářů nebo museli ručně spravovat jednotlivé cloudové vývojové stroje.
Některé činnosti musí počkat na člověka nebo na nasazení; agent mezitím nemusí dál běžet. Když úloha potřebuje počkat, může se přihlásit k odběru událostí, jako jsou komentáře při revizi nebo neúspěšné kontroly CI u položky pull request na GitHubu. Tak dostane upozornění, až bude čas v práci pokračovat. Pokud příchozí událost odpovídá nastavenému odběru, úloha je znovu připravena a distribuční smyčka jí může přidělit agenta, který v práci naváže.
První postup, který jsme v systému Performance Factory vytvořili, hledá regrese, zjišťuje jejich hlavní příčiny a řeší je. Říkáme mu postup pro řešení regresí. Řešení výkonnostní regrese prochází několika fázemi: vyžaduje analýzu, hlavní příčina zjištěna, oprava navržena a vyřešeno. Automatizovaný postup jsme proto vytvořili tak, aby odrážel tyto fáze a provázel jimi úlohu.
Když se spustí některé z nastavených upozornění na výkon, postup pro řešení regresí vytvoří úlohu, kterou agenti převezmou a provedou těmito fázemi. Stav a klíčová zjištění se ukládají do úlohy mimo kontext konkrétního agenta, aby na práci mohli navázat další agenti nebo vývojáři. Ti mohou práci sledovat ve Slacku nebo v rozhraní postupu pro řešení regresí, doplňovat kontext a posuzovat navrhované změny. Po zavedení opravy agent před uzavřením úlohy ověří, zda se výkon vrátil do původního stavu.
Postup řešení regresí v systému Performance Factory
Je zjištěna regrese.


- ZjištěnoSystém
- Najít hlavní příčinuAgent
- Navrhnout opravuAgent
- Zkontrolovat a nasaditVývojář
- Ověřit obnovení výkonuAgent
- Vyřešeno
Aktivní fáze: Zjištěno
Postup pro řešení regresí zahrnuje nalezení hlavní příčiny, návrh opravy, kontrol a nasazení i ověření obnovení výkonu.
Nalezení hlavní příčiny (nebo příčin) je prvním zásadním krokem postupu. Agent nejprve zjišťuje, které metriky se zhoršily, kdy se začaly měnit a které požadavky na službu byly zasaženy. Dovednost perf-forensics dává Codexu přístup k nástrojům našich vývojářů zaměřujících se na optimalizaci výkonu a návod, jak na tyto otázky hledat odpovědi.
Upozornění se spustí, když metrika překročí prahovou hodnotu, ale regrese mohla začít už o několik hodin dříve. Agent zpětně prochází data a hledá okamžik, kdy se metrika začala zhoršovat. Pak porovnává skupiny požadavků: skutečně se podobné požadavky zpomalily, nebo jsme obsluhovali více požadavků, které už předtím byly pomalé? Každé z těchto zjištění ukazuje na jinou příčinu.
Jakmile agent ví, kdy a kde hledat, prozkoumá nasazení a změny příznaků funkcí a poté si přečte příslušný kód. Ověří, kdy se změna skutečně projevila u zasažených požadavků, a pomocí logů nebo trasování zkoumá, zda kód může vysvětlit, co se stalo.
Zpočátku se agenti někdy zastavili u prvního věrohodného vysvětlení a některé z těchto diagnóz se ukázaly jako chybné. Abychom tyto chyby zachytili, přidali jsme oponentní kontrolu: samostatnou relaci Codexu, která se snaží navrženou diagnózu vyvrátit. Kontrolní agent znovu prověřuje předpoklady a testuje kontrafaktuální scénáře. Pokud zpomalení způsobilo nasazení změny, zůstaly podobné požadavky, na které se změna nevztahovala, v pořádku? Pokud byla podezřelá změna vrácena zpět, vrátila se zasažená metrika na původní úroveň?
Při jedné analýze agent spojil selhávající konverzace v ChatGPT s chybami při stahování obrázků a označil příčinu za nalezenou. Kontrolní agent Codex si všiml, že interní služba zodpovědná za vyhledávání souborů už opět funguje, zatímco požadavky na obrázky dál selhávají. Diagnóza nevysvětlovala pokračující selhání, a tak kontrolní AI agent analýzu znovu otevřel a zaznamenal, co je ještě potřeba zjistit.
Osvědčilo se nám rozdělovat větší práce do úzce zaměřených relací Codexu. Při ruční revizi 100 návrhů hlavní příčiny jsme 70 % vyhodnotili jako přesné; zbylých 30 % potřebovalo další zpřesnění nebo plně neprokazovalo příčinnou souvislost. V postupu pro řešení regresí jednotlivé relace zkoumají regrese, zpochybňují diagnózy a navrhují opravy. Vzájemnou kontrolou tak zvyšují přesnost výsledků.
Jakmile diagnóza projde oponentní kontrolou, postup požádá Codex o implementaci opravy a vytvoření pull requestu. Vývojář pull requestu zkontroluje a rozhodne, zda ho sloučit. Věnovali jsme značné úsilí tomu, aby toto předání bylo co nejjednodušší. Každá úloha obsahuje zprávu s automaticky vygenerovaným shrnutím regrese, jejího dopadu, hlavní příčiny a navržené opravy. Tato shrnutí jsme upravili tak, aby se v nich dalo rychle zorientovat. Obsahují časové řady metrik, plamenné grafy CPU a trasování, které vývojářům pomáhají rychle pochopit zjištění a prověřit důkazy. Vývojáři mohou pull request přímo upravit nebo na základě diagnózy napsat vlastní opravu. Pokud u pull requestu zadají komentáře, postup probudí agenta, který je zpracuje.
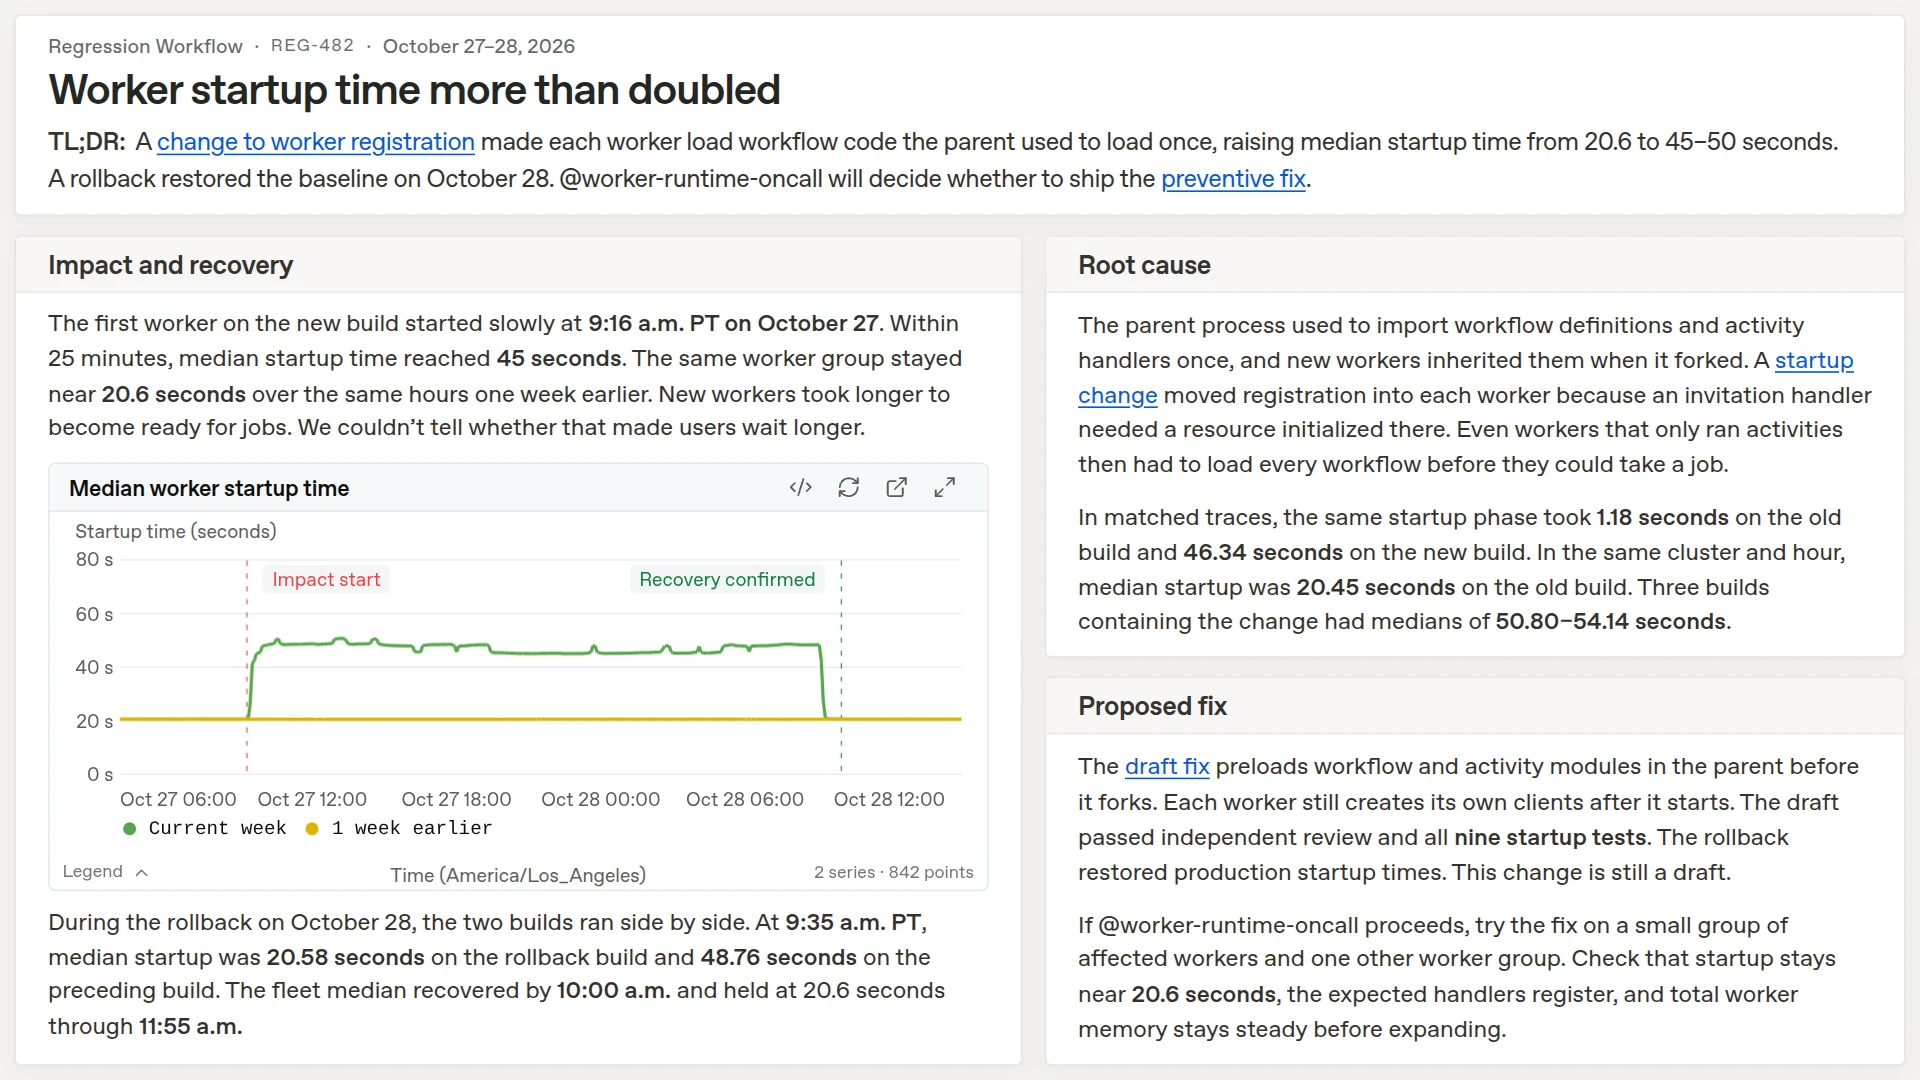
Ukázková zpráva k úloze řešící regresi uvádí klíčové podrobnosti, hlavní příčinu a navrženou opravu.
Jakmile vývojář opravu nasadí, postup probudí agenta, který ověří, zda se výkon vrátil na předchozí výchozí úroveň. Pokud ano, agent označí úlohu za vyřešenou. Pokud se výkon obnovil jen částečně, agent uzavře původní regresi a vytvoří novou úlohu pro zbývající zpomalení, které může mít jinou příčinu. Pokud ke zlepšení nedošlo, agent zaznamená, co se stalo, a vrátí regresi k další analýze.
Vytvořit správnou opravu se ukázalo jako těžší než najít příčinu. Setkali jsme se například s případy, kdy agentem navržené změny byly zbytečně složité nebo způsobovaly nové problémy. Podobně jako při hledání hlavní příčiny jsme ke každé navržené opravě přidali oponentní kontrolu. Ta ověřuje, zda oprava řeší hlavní příčinu, a pomáhá zachytit chyby či nezamýšlené důsledky. Některé opravy navíc vyžadují koncepční rozhodnutí o architektuře. Například přidání mezipaměti může zvýšit výkon, ale zároveň vést k používání zastaralých dat. U takových změn pomůže vedení vývojáře, který službu zná a dokáže zvážit výhody a nevýhody.
Na základě těchto případů vytváříme cyklus vyhodnocování a zlepšování. Porovnáváním oprav navržených agenty se změnami, které vývojáři nakonec sloučí, můžeme lépe pochopit nedostatky návrhů, vytvářet evaluace a zdokonalovat pracovní postup. Pracujeme také na využití syntetických testů výkonu, aby agenti mohli změřit účinek navržených oprav a upravit je ještě před žádostí o kontrolu vývojářem. Zkoumáme také, jak by agenti mohli využívat naše další agentní nástroje pro kontrolu k rozpoznání málo rizikových změn a časem tyto opravy nasazovat bez zapojení člověka.
Tvorba a provoz systému Performance Factory nás hodně naučily o vývoji a provozování agentních postupů v produkci. Tady je několik poznatků pro týmy, které vytvářejí vlastní agentní postupy.
Neupravený výstup analýzy Codexu může být záplavou textu, ve které se těžko orientuje. Dá práci pochopit, co agent tvrdí, a dohledat grafy, abyste zjistili, zda jeho tvrzení podporují data. Chceme, aby vývojáři věnovali pozornost rozhodování, ne zpětnému rozplétání aktivit agenta.
Agenti dokážou prozkoumat více regresí, než kolik má tým čas číst. Naše první verze nabídla vývojářům uživatelské rozhraní plné zjištění, ale někdo stále musel rozhodnout, které informace jsou důležité. Jedna regrese se navíc může v různých upozorněních, monitorovacích nástrojích a kanálech objevit jako několik incidentů. Postup nyní propojuje související incidenty, seskupuje je podle metrik důležitých pro týmy a řadí je podle odhadovaného dopadu. Vývojáři se tak mohou soustředit na doplňování kontextu, zvažování kompromisů a rozhodování o tom, co nasadit.
Úprava analytické dovednosti nebo přechod na novější model může zlepšit diagnostiku některých případů a zhoršit jiné. Dopad těchto změn proto musíme otestovat před jejich zavedením. Odděleně testujeme dvě věci: 1) jak dobře agent provádí analýzu a 2) jak užitečná jsou jeho shrnutí pro vývojáře.
Analýzy zpětně testujeme na dřívějších produkčních incidentech. Z těchto incidentů vytváříme sadu testovacích případů, kterou můžeme znovu spustit, když dovednost změníme. Agent Codexu se pokusí incident prozkoumat a vyřešit a my porovnáme jeho chování se záznamy o skutečném dřívějším řešení. Každý případ začíná s novým analytickým agentem Codex a původní informací, z něhož odstraníme podrobnosti, které by mohly prozradit odpověď.
Testy na historických datech vyžadují opatrnost. Metriky a trasování se uchovávají jen po omezenou dobu a důkazy shromážděné po obnovení provozu mohou prozradit příčinu. Test má smysl pouze tehdy, pokud víme, jaké důkazy měl analytický agent k dispozici. Agent může prohlížet kód a v rámci stanovených omezení dotazovat produkční telemetrii. Nesmí používat uložené vzpomínky (poznámky z dřívějších analýz), číst zprávu o incidentu ani vidět výsledky předchozích relací. Poté také kontrolujeme přepis jeho činnosti a hledáme informace, které mohly test znehodnotit.
Hodnotíme, jak přesně určil začátek a rozsah problému a zasažené požadavky. Posuzujeme také, jak agent využívá důkazy k seřazení možných příčin podle pravděpodobnosti a jak vysvětluje přetrvávající nejistoty. Agent může správně určit čas, a přesto označit za příčinu nesprávné nasazení, proto tyto aspekty hodnotíme zvlášť.
Shrnutí úloh vyhodnocujeme pomocí snímků uložených úloh. Ty jsou pro zpětné testování obzvlášť vhodné, protože shrnování nezávisí na externích metrikách nebo trasování s omezenou dobou uchování. Samostatný hodnotitel kontroluje, zda vývojář neobeznámený se systémem pochopí, co se stalo a proč je to důležité, zda zůstaly zachovány užitečné grafy a zda navržený další krok vychází z důkazů.
A konečně, naši agenti potřebují monitorování stejně jako služby, které zkoumají. Nefunkční profiler nebo chybějící oprávnění mohou agentovi zabránit v ověření příčiny zpomalení. Tato selhání může být těžké ve výsledné zprávě rozpoznat, proto každý den spouštíme agenta, který prochází zprávy a logy z posledních běhů a hledá selhání nástrojů a chyby přístupu.
Performance Factory používáme k samoopravě: opravuje problémy, které tato kontrola odhalí. Když stejná chyba nástroje zablokuje několik analýz, agent vytvoří úlohu pro její opravu. Pokud je příčina jasná, agent navrhne opravu a vývojář změnu zkontroluje a rozhodne, zda ji sloučit. Po sloučení takových změn pomocí evaluací také ověřujeme, zda agenti dokážou překonat krok, který je předtím blokoval.
Postup pro řešení regresí je jen jedním příkladem architektury továrny agentů, která posouvá úlohy přes jasně definované stavy. Agenti posouvají úlohu dál, jakmile lze pokračovat v práci; samostatní kontrolní agenti zpochybňují závěry a vývojáři vstupují do procesu, pokud další rozhodnutí vyžaduje odborný úsudek. Další postupy mohou využít stejný mechanismus s jinými stavy, pokyny a událostmi.
Od jednoho pracovního postupu k mnoha. Performance Factory dokáže koordinovat agenty v rámci různých postupů: agenti v jednom postupu mohou vytvářet úlohy pro jiný.
Náš postup pro řešení regresí se v současnosti spouští na základě upozornění. Pracujeme ale na proaktivnějších způsobech, jak by Performance Factory mohla nacházet zpomalení a možnosti optimalizace i bez spuštěného upozornění. Chceme, aby agenti využívali velké množství podrobných dat o výkonu, která už sbíráme, k odhalování regresí nezachycených našimi upozorněními nebo k hledání možností optimalizace. Porovnáváním různých druhů dat napříč verzemi (sad profilů CPU a paměti, výpisů haldy a trasování požadavků) by si agent mohl všimnout mírného nárůstu využití CPU u určitého požadavku. Pak může v postupu pro řešení regresí vytvořit úlohu, která dohledá příčinu nárůstu, implementuje opravu a vytvoří pull request k posouzení vývojářem.
V případech, kdy už víme, co hledat, pracujeme na začlenění známých informací do dalších postupů systému Performance Factory. Například naše dovednost pro správné dimenzování služeb pomáhá agentům odhalit nastavení automatického škálování, která udržují v chodu více replik, než služba potřebuje. Když se naučíme takový vzorec rozpoznávat, chceme pro něj vytvořit postup a pravidelně ho spouštět napříč všemi službami, abychom je v rychle se měnícím prostředí průběžně optimalizovali. Díky systému Performance Factory mohou poznatky vývojáře z jednoho zpomalení ovlivnit, jak prozkoumáme a opravíme to další, třeba i o měsíce později v jiné službě.
Až si příště při používání ChatGPT všimnete zpomalení, je dost možné, že Performance Factory už zjišťuje proč. Dnes může být úzkým hrdlem čekání na vývojáře, který opravu zkontroluje a sloučí. Už zkoumáme, zda by to agenti mohli dělat sami. S tím, jak Codex dál zrychluje vývoj produktů, musí být systémy pro správu výkonu stále autonomnější a schopné vlastního zlepšování, aby udržely krok. Codex nám už pomáhá vyvíjet ChatGPT rychleji. Teď nám pomáhá udržovat rychlý i samotný ChatGPT.